پرش به محتوای اصلی

موضوع

چندوجهی

Models that natively process text+image+audio+video

۱٬۶۶۴ مقاله منتشر شده

شکاف عمیق میان نمرات فنی و کیفیت انسانی در مدل‌های صوتی هوش مصنوعی

پلتفرم Hume با معرفی محک Real World VoiceEQ نشان داد که مدل‌های صوتی علیرغم نمرات بالای فنی، در درک احساسات و بافت‌های صوتی شکست می‌خورند. داده‌ها حاکی از آن است که هیچ مدل واحدی…

۵ دقیقه خواندن۱
آموزش کاربردی

عکس‌های اینستاگرام شما به آموزش مدل Muse Image می‌روند مگر اینکه مخالفت کنید

متا تنظیماتی را معرفی کرد که به برخی کاربران اجازه می‌دهد از به‌کارگیری محتوای عمومی‌شان برای آموزش هوش مصنوعی Muse Image جلوگیری کنند. در این سیستم، مدل می‌تواند بدون اطلاع…

۱ دقیقه خواندن۲

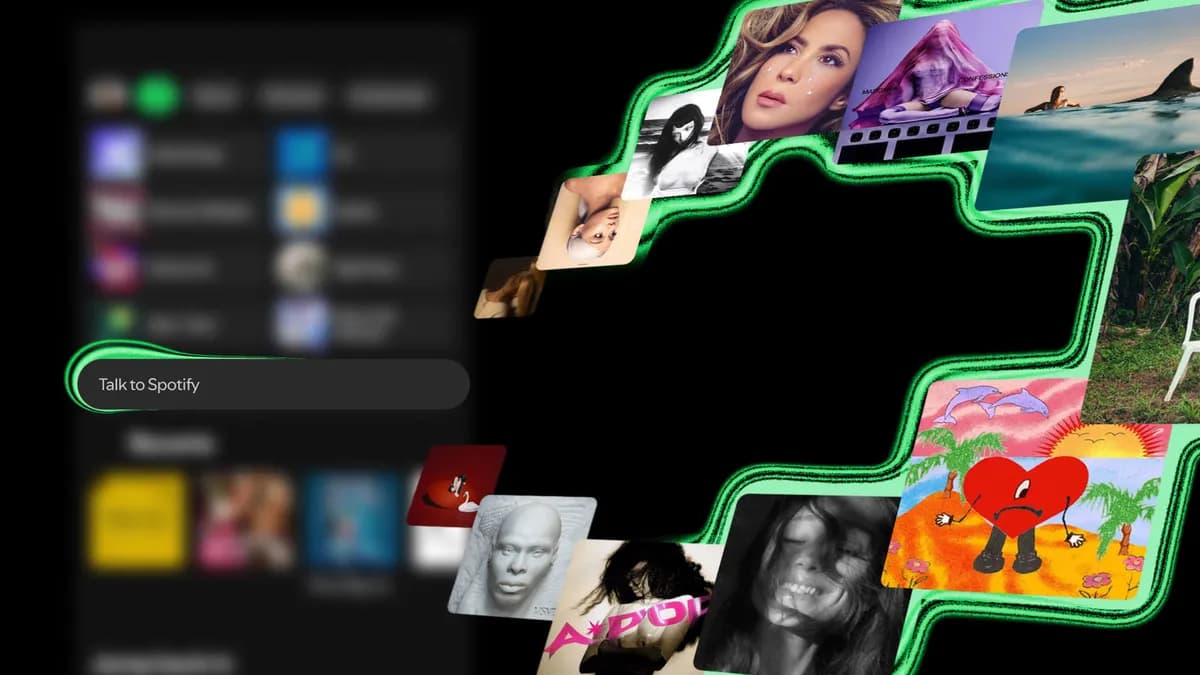
Spotify: قابلیت تحلیل تاریخچه شنیداری برای کاربران بالای ۱۸ سال

اسپاتیفای دستیار جدیدی معرفی کرده که به کاربران اجازه می‌دهد از طریق گفتگوهای صوتی یا متنی، موسیقی خود را مدیریت کنند و تاریخچه شنیداری‌شان را تحلیل نمایند. این قابلیت در حال حاضر…

۳ دقیقه خواندن۲
آموزش کاربردی

استخراج «ژنوم خلاقانه»؛ سازوکاری برای اتوماسیون تحلیل عملکرد تبلیغات

یک معماری عامل‌محور جدید با جداسازی محاسبات داده‌ای از استدلال مدل‌های زبانی، تحلیل تبلیغات را از گزارش‌های ساده به بریف‌های خلاقانه تبدیل می‌کند. این سامانه با شناسایی دقیق…

۱۴ دقیقه خواندن۱