پرش به محتوای اصلی

موضوع

استدلال

Chain-of-thought, reasoning models (o-series, R-series), test-time compute

۲٬۰۴۹ مقاله منتشر شده

دستیابی DeepSeek-R1-8B به امتیاز ۰.۹۱۲ در تحلیل مالی با ترکیب LoRA و NEFTune

پژوهشگران با ترکیب روش‌های LoRA و NEFTune، مدل DeepSeek-R1-8B را برای شناسایی موجودیت‌های نام‌گذر مالی بهینه کردند. این رویکرد ترکیبی در استخراج داده‌های ساختارمند از گزارش‌های…

۱ دقیقه خواندن

چرا یادگیری تقویت‌شده در درمان شخصی‌سازی‌شده‌ی سرطان شکست می‌خورد؟

پژوهشگران با استفاده از چارچوب استنتاج فعال (Active Inference)، روشی برای بهینه‌سازی درمان‌های شخصی‌سازی‌شده‌ی سرطان ابداع کردند. این مدل با ایجاد تعادل میان جمع‌آوری اطلاعات و…

۱ دقیقه خواندن

مطالعه ArXiv: افزایش مقاومت مدل‌های زبانی در برابر داده‌های متناقض تا ۳۳٪

پژوهشگران یک پارادایم رمزگشایی «آگاه از تضاد» معرفی کرده‌اند که مانع از اعتماد کورکورانه‌ی مدل‌ها به داده‌های خارجی نادرست می‌شود. این سازوکار با استفاده از مسیریابی رژیم تطبیقی…

۱ دقیقه خواندن

چرا Anthropic برای دستیابی به دقت ۹۰٪، حریم خصوصی شرکت‌ها را قربانی کرد؟

شرکت Anthropic مدل Claude Fable 5 را با دقت ۹۰ درصدی در تحلیل‌های پیچیده عرضه کرد. این مدل در کنار قدرت بالا، هزینه توکن‌ها را دو برابر کرده و ذخیره اجباری داده‌ها برای ۳۰ روز را…

۴ دقیقه خواندن۲
آموزش کاربردی

چگونه مدل ۳۰ میلیاردی North Mini Code غول‌های ۱۲۰ میلیاردی کدنویسی را شکست داد؟

شرکت Cohere مدل North Mini Code را معرفی کرد؛ یک مدل ۳۰ میلیاردی که در مهندسی نرم‌افزار عامل‌محور، عملکرد مدل‌های ۱۲۰ میلیاردی را پشت سر می‌گذارد. این دستاورد مدیون استفاده از…

۹ دقیقه خواندن۱
آموزش کاربردی

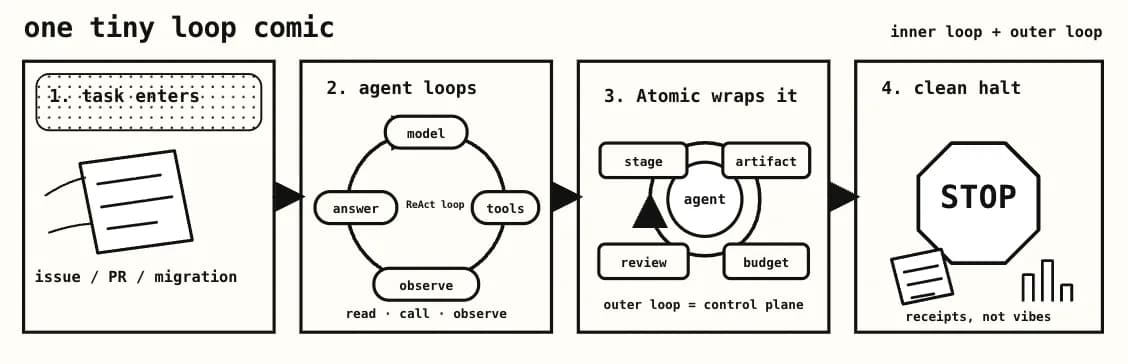
چگونه Atomic با استفاده از TypeScript جلوی توهم عامل‌های کدنویسی را می‌گیرد؟

بسیاری از عامل‌های کدنویسی در وظایف پیچیده شکست می‌خورند چون محدودیت ساختاری ندارند. Atomic با ایجاد یک لایه اجرایی در TypeScript، کنترل دقیق‌تری بر توکن‌ها و خروجی مدل‌ها ایجاد…

۱۵ دقیقه خواندن۵
آموزش کاربردی

سازوکار A11: جداسازی مشاهده از نتیجه برای مهار توهمات هوش مصنوعی

چارچوب جدید A11 با ایجاد لایه‌های استدلالی، مانع از آن می‌شود که مدل‌های هوش مصنوعی مشاهدات را با فرض‌ها اشتباه بگیرند. هدف این سیستم به‌جای رسیدن به حقیقت مطلق، کاهش خطاهای…

۴ دقیقه خواندن

چرا مقیاس‌پذیری مدل‌های زبانی توهمات حقوقی را درمان نمی‌کند؟

خطاهای سیستم‌های هوش مصنوعی حقوقی، مانند استنادهای ساختگی، ریشه در نقص معماری و عدم تطابق بازیابی احتمالی با ساختار سلسله‌مراتبی قوانین دارند. چارچوب پیشنهادی جدید با رویکرد…

۲ دقیقه خواندن۲

مطالعه CARE: کاهش ۵ برابری هشدارهای خطا در خلاصه‌سازی پزشکی با لایه ایمنی جدید

چارچوب CARE یک لایه ایمنی مستقل از مدل است که ضمانت‌های ریاضیاتی علیه توهمات و حذف داده‌های حیاتی در خلاصه‌های پزشکی ارائه می‌دهد. این سیستم با کاهش چشمگیر هشدارهای غیرضروری و…

۲ دقیقه خواندن۲

چرا نمرات «شروع سرد» برای سنجش قابلیت یادگیری عامل‌های VLM کافی نیستند؟

پژوهشگران بنچمارک OmniGameArena را برای اندازه‌گیری نحوه بهبود عامل‌های مدل زبانی-دیداری از طریق بازتاب خودکار معرفی کرده‌اند. برخلاف تابلوهای امتیازات ایستا، این سیستم مسیر…

۱ دقیقه خواندن