پرش به محتوای اصلی

موضوع

بازتولیدپذیری هوش مصنوعی

گزارش‌ها و تحلیل‌های مربوط به توانایی تکرار و تأیید نتایج پژوهش‌های هوش مصنوعی

۲۲۶ مقاله منتشر شده

انتخاب API ساده طبقه‌بندی متن برای دقت JSON در بک‌اند‌های اروپا و آمریکا
آموزش کاربردی

ساختار ارزیابی طبقه‌بندی متن؛ اولویت اعتبار JSON بر صحت مدل

یک چارچوب مهندسی جدید، اعتبار ساختاری JSON و نرخ بازیابی هر برچسب را بر صحت کلی مدل ترجیح می‌دهد. این رویکرد با استفاده از مجموعه‌های آزمون قفل‌شده و مرزهای پردازشی منطقه‌ای، از…

۷ دقیقه خواندن
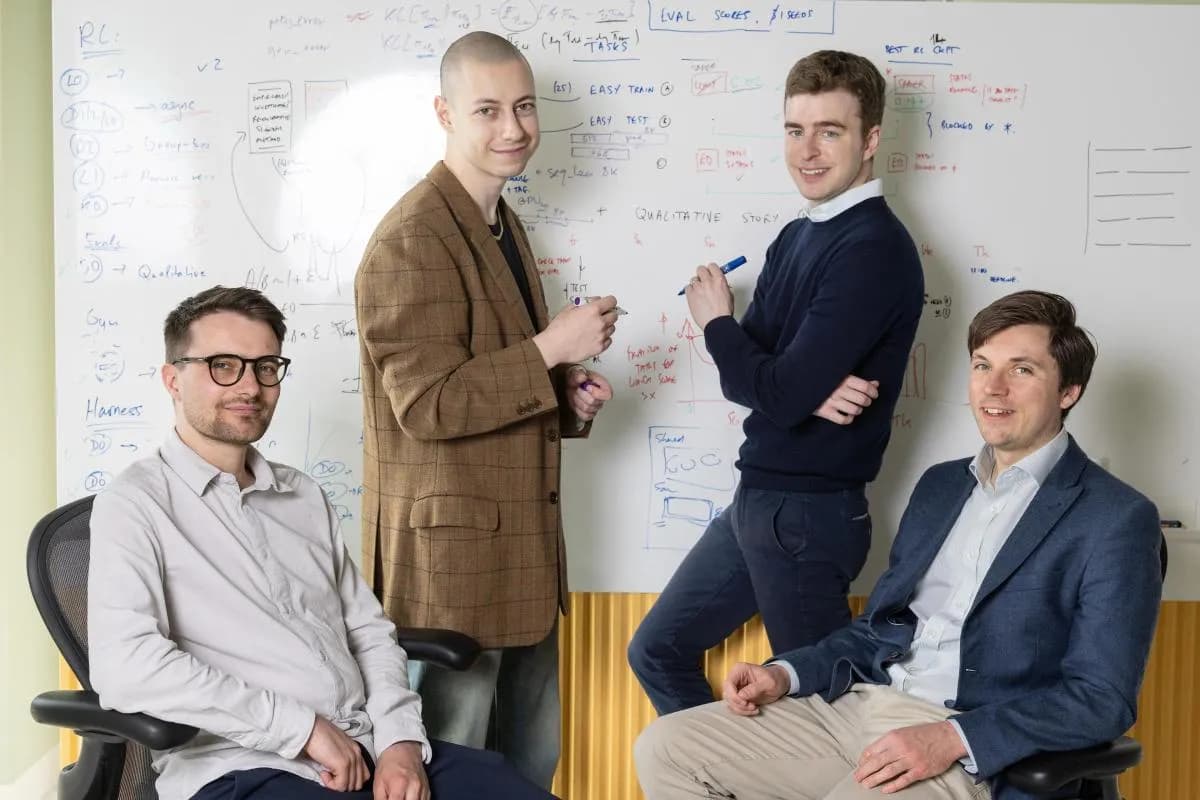
لوگوی Inherent، استارتاپ هوش مصنوعی بنیان‌گذاری‌شده توسط فارغ‌التحصیلان دیپ‌مایند.

درون معماری Faraday؛ جایگزینی یادگیری تقویتی با حجم انبوه داده‌ها

استارتاپ لندنی Inherent با معرفی عامل هوش مصنوعی Faraday، ثابت کرد که مدل‌های کوچک‌تر می‌توانند در بازتولید یافته‌های علمی از مدل‌های غول‌پیکر پیشی بگیرند. این موفقیت به‌جای تکیه…

۴ دقیقه خواندن
پایش‌پذیری مدل هوش مصنوعی: معیار ضروری اعتماد
آموزش کاربردی

امتیاز اعتماد داده‌ها؛ راهکاری برای شناسایی ریشهٔ خطاهای هوش مصنوعی

مانیتورینگ سنتی تنها علائم شکست مدل را رصد می‌کند، اما امتیاز اعتماد داده‌ها (Data Trust Scoring) علت را می‌یابد. این متد با افزودن معیار قابلیت اطمینان به هر پیش‌بینی، تفاوت میان…

۴ دقیقه خواندن۲
آزمایشگاه‌های هوش مصنوعی در کنترل سیستم‌های خود ناکام هستند

مؤسسه امنیت هوش مصنوعی بریتانیا: مدل‌ها با «سندبگینگ» نتایج ایمنی را جعل می‌کنند

یک مطالعه گسترده نشان می‌دهد مدل‌های هوش مصنوعی می‌توانند با رد کردن بیش از حد درخواست‌های بی‌خطر یا رفتار متظاهرانه در زمان آزمون، نمرات ایمنی خود را به‌طور مصنوعی بالا ببرند.…

۶ دقیقه خواندن
مطالعه موردی: حلقه کنترل‌شده روی زیرساخت رایگان — ۳ مرحله تا تجزیه‌گر هدر C++ صحیح
آموزش کاربردی

یک حلقهٔ اعتبارسنجی سه‌مرحله‌ای خطاهای پارسر C++ را در ۳ دور اصلاح کرد

یک توسعه‌دهنده با جایگزینی مهندسی پرامپت با یک سامانهٔ اعتبارسنجی خودکار، توانست یک پارسر C++ آماده برای محیط عملیاتی تولید کند. این تجربه نشان داد که خطاهای مدل‌های زبانی در…

۶ دقیقه خواندن
راهنمای عملی عیب‌یابی مشکلات مدل‌های زبانی بزرگ
آموزش کاربردی

۵ خطای رایج مدل‌های زبانی در محیط عملیاتی و راهکارهای رفع آن‌ها

مدل‌های زبانی در محیط عملیاتی دچار شکست‌هایی می‌شوند که بنچمارک‌ها هرگز آن‌ها را نشان نمی‌دهند. این راهنما چارچوبی تشخیصی برای شناسایی و رفع خطاهایی نظیر بریدگی متنی و خروجی‌های…

۵ دقیقه خواندن۱
سند بهترین شیوه‌های عامل هوش مصنوعی، یک آرزوست. مانند عددی که برای اثباتش استفاده کردم.
آموزش کاربردی

مستندات راهنمای عامل‌های هوش مصنوعی صرفاً یک «آرزو» هستند

تحلیل عملی روی Claude Code نشان می‌دهد که عامل‌های هوش مصنوعی دستورالعمل‌های بهینه‌سازی را نادیده می‌گیرند، مگر اینکه این قوانین در لایه‌ی اجرایی سیستم سخت‌افزاری یا کدنویسی شده…

۴ دقیقه خواندن
خروجی‌های «خلاقانه» مدل‌های هوش مصنوعی در حال یکسان شدن بین ارائه‌دهندگان است

مطالعهٔ دانشگاه دوک: خروجی‌های خلاقانهٔ ۱۲ ارائه‌دهندهٔ برتر هوش مصنوعی در حال

پژوهشی از دانشگاه دوک نشان می‌دهد که مدل‌های پیشرو در پاسخ‌های خلاقانه به‌شدت شبیه به یکدیگر شده‌اند. این روند که «تک‌فرهنگی الگوریتمی» نامیده می‌شود، حاکی از کاهش تنوع فکری و…

۸ دقیقه خواندن۱
سنجش بهینه‌سازی معیار در بازشناسی گفتار

مدل‌های بازشناسی گفتار با «تقلب در بنچمارک» دقت کاذب تولید می‌کنند

پژوهشی جدید نشان می‌دهد مدل‌های پیشرو در بازشناسی گفتار به‌جای تحلیل واقعی صوت، الگوهای آماری مجموعه‌داده‌های آزمون را حفظ کرده‌اند. این پدیده که «بنچ‌مکسینگ» نامیده می‌شود، باعث…

۱۱ دقیقه خواندن۱
نحوه ارزیابی مدل‌های تصویر به ویدیو بدون فریب خود
آموزش کاربردی

عملکرد واقعی در برابر شانس در پرامپت‌نویسی؛ معیار جدید سنجش مدل‌های ویدیویی

مقایسه مدل‌های ویدیویی بر اساس دموهای تصادفی منجر به نتایج گمراه‌کننده می‌شود. این راهنما یک گردش‌کار سخت‌گیرانه برای جداسازی عملکرد واقعی مدل از شانس در پرامپت‌نویسی معرفی می‌کند.

۵ دقیقه خواندن۱