
چرا SSE برای استریم پاسخهای هوش مصنوعی کارآمدتر است؟
یک توسعهدهنده نشان داد که رویدادهای ارسالی سرور (SSE) روشی پایدارتر و روانتر برای استریم توکنهای مدل زبانی بزرگ در رابطهای چت هستند. او با استفاده از fetch و ReadableStream،…
۵ دقیقه خواندن
موضوع
۳٬۶۰۷ مقاله منتشر شده
یک توسعهدهنده نشان داد که رویدادهای ارسالی سرور (SSE) روشی پایدارتر و روانتر برای استریم توکنهای مدل زبانی بزرگ در رابطهای چت هستند. او با استفاده از fetch و ReadableStream،…
تیمهای مهندسی اغلب در تلهٔ بهینهسازی برای عبور از تستها بهجای انجام واقعی کار میافتند. راهکار این مشکل، پیوند دادن هر امتیاز ارزیابی به یک ردپای اجرایی (Trace) دقیق است تا…

با رایگان و فوری شدن تولید کد توسط هوش مصنوعی، ارزش مهندسی نرمافزار از نوشتن توابع به قضاوتهای سطح بالای معماری منتقل شده است. پلتفرم SystemThinkingLab مدل آموزشی خود را برای…

تیم Mysk ابزاری متنباز به نام Loupe منتشر کرد که نشان میدهد اپلیکیشنها چگونه بدون اجازه کاربر، اثر انگشت دیجیتال دستگاه را میسازند. این ابزار ثابت میکند که دادههای غیرحساس…
بسیاری از عاملهای خودکار در محیط عملیاتی شکست میخورند زیرا لایههای ارزیابی و نظارت را ابزارهایی جانبی میبینند، نه بخشی از هسته سیستم. جایگزینی مدلهای «حلقه-باز» با «هارنسهای…

یک توسعهدهنده مستقل با ساخت ForgeOS، هستهای سبک از پایتون، توانست ۱۳ فرآیند خودکار را بدون پیچیدگیهای کوبرنتیز مدیریت کند. این سیستم بهجای بررسی سادهٔ وضعیت اجرا، «تازگی…
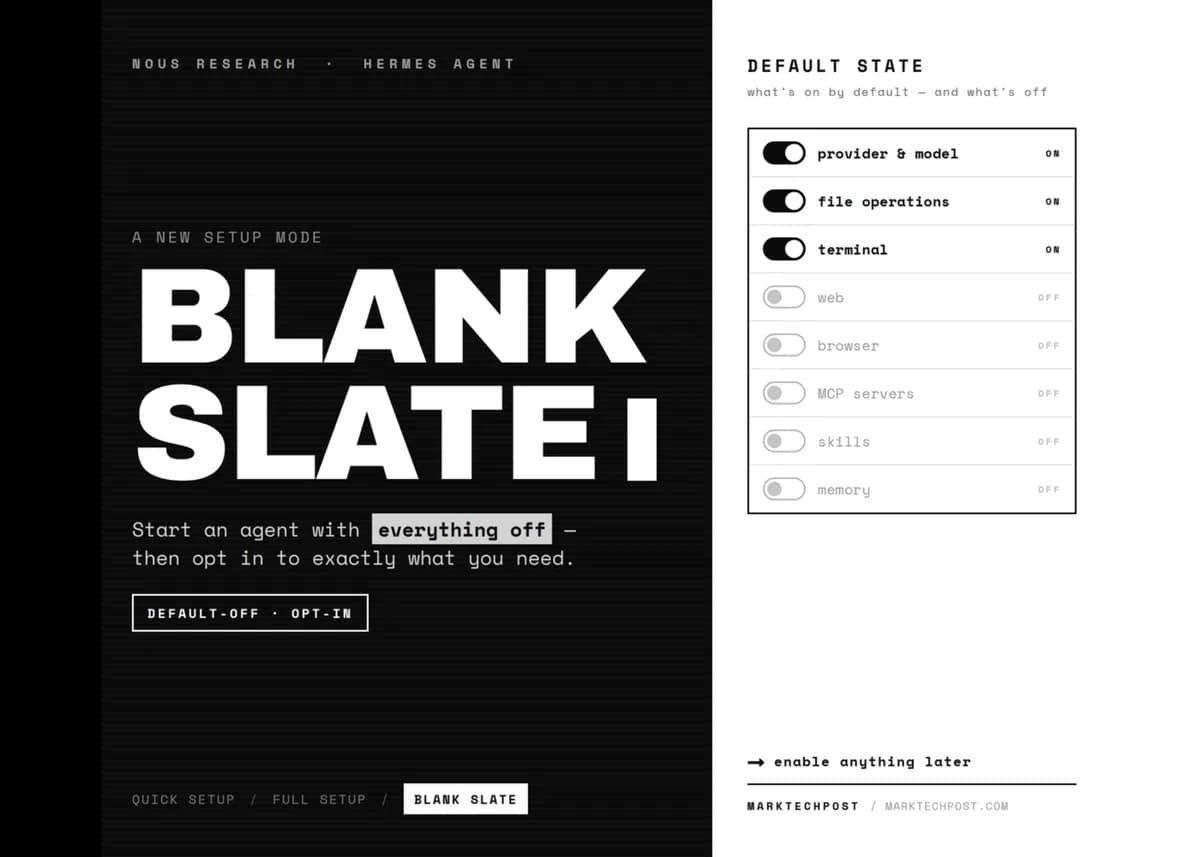
نوس ریسرچ با معرفی حالت Blank Slate در عامل Hermes، امکان راهاندازی عاملها با صفر ابزار فعال فراهم کرد. این رویکرد با الزام به تأیید صریح هر قابلیت، امنیت و کنترل مطلق روی…

مارک بروکر از مهندسان AWS توضیح میدهد که چگونه معیارهای سنتی تأخیر، درد واقعی کاربران را نادیده میگیرند. این شکاف به دلیل «پارادوکس بازرسی» رخ میدهد؛ جایی که کاربران به طور…

مهندسی عاملمحور با انتقال تصمیمگیریهای میانی و اعتبارسنجی به سیستمهای خودگردان، نقش انسان را از اجراکننده به ناظر تغییر میدهد. در این مدل، تمرکز برنامهنویس از نوشتن کد به…
آمازون بیش از ۱۰۰ متریک دقیق استنتاج را به SageMaker AI اضافه کرد. در حالی که این ابزارها نظارت را بهبود میبخشند، اما ریسک مهندسی معکوس معماری مدلها و حملات DoS هدفمند را افزایش…

سامانه TypeForge با مدلسازی خطاهای تایپی بهعنوان «نویز» در کانال انتقال، نقاط ضعف دقیق کاربر را شناسایی میکند. این ابزار بهجای لیستهای کلمات کلی، تمریناتی برای اصلاح…

چارچوب متنباز Agent Rigor برای مقابله با «پوسیدگی زمینه» در عاملهای کدنویس معرفی شده است. این سیستم با جایگزینی پرامپتهای حجیم با یک ساختار لایهای، از تخریب کدبیس و توهمات مدل…