پرش به محتوای اصلی

موضوع

هوش لبه

SLMs, on-device inference, mobile AI, AI PCs

۱٬۶۸۰ مقاله منتشر شده

گیبسون بداخلاقی که در روتر اداری زندگی می‌کند. فقط آنچه روتر می‌بیند را می‌داند.
آموزش کاربردی

آیا روترهای OpenWrt می‌توانند به عامل‌های امنیتی خودمختار تبدیل شوند؟

پروژه متن‌باز the-finn روترهای OpenWrt را به عامل‌های خودمختاری تبدیل می‌کند که ناهنجاری‌های شبکه را رصد می‌کنند. برخلاف دستیارهای مودب، این سیستم یک ناظر «بدقلق» است که ترافیک…

۱۳ دقیقه خواندن۱
ربات چت‌بات روی لپ‌تاپ شخصی در حال اجرا شدن، با نماد هوش مصنوعی روی صفحه نمایش.
آموزش کاربردی

پردازش محلی در برابر ابری؛ تقابل حریم خصوصی و نیاز به سخت‌افزار

اجرای مدل‌های زبانی روی سخت‌افزار شخصی، هزینه‌های اشتراک ماهانه را حذف کرده و با آفلاین کردن پردازش‌ها، حریم خصوصی داده‌ها را تضمین می‌کند. ابزارهایی مانند LM Studio Bionic این…

۵ دقیقه خواندن
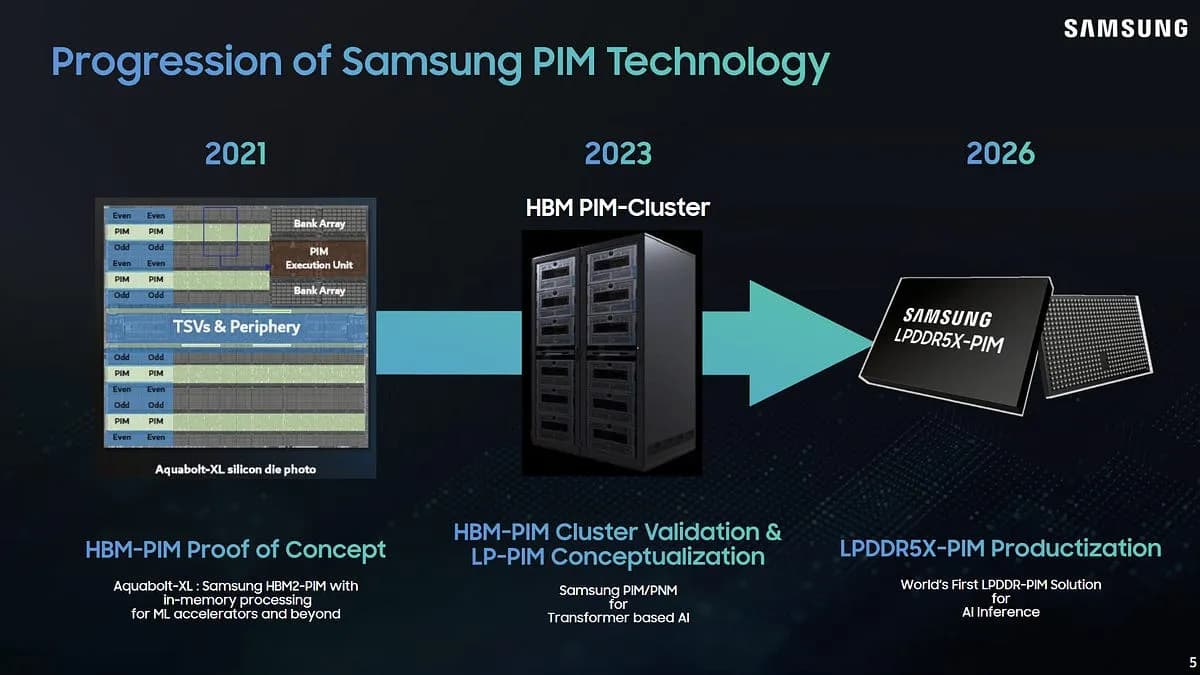
پردازش در حافظه سامسونگ: تراشه‌های هوشمندتر با مصرف انرژی کمتر

تراشه LPDDR5X-PIM سامسونگ پهنای‌باند داخلی را به ۶۱۴ گیگابایت بر ثانیه رساند

سامسونگ با ادغام واحدهای محاسباتی مستقیماً در تراشه‌های حافظه، گلوگاه انتقال داده را حذف کرد. این معماری پهنای‌باند داخلی را ۸ برابر افزایش می‌دهد، اما با چالش‌های شدید نرم‌افزاری…

۹ دقیقه خواندن۱
هوش مصنوعی محلی برای کسب‌وکار: کاهش هزینه بدون ارسال داده به ابر
آموزش کاربردی

هوش مصنوعی محلی در برابر مدل‌های ابری برای مدیریت تحلیل داده‌ها

کسب‌وکارهای کوچک برای حذف اشتراک‌های ماهانه و تأمین امنیت داده‌ها به سمت مدل‌های محلی حرکت می‌کنند. این رویکرد امکان اتوماسیون تحلیل داده‌ها و نویسه‌خوانی نوری را بدون ریسک‌های…

۳ دقیقه خواندن
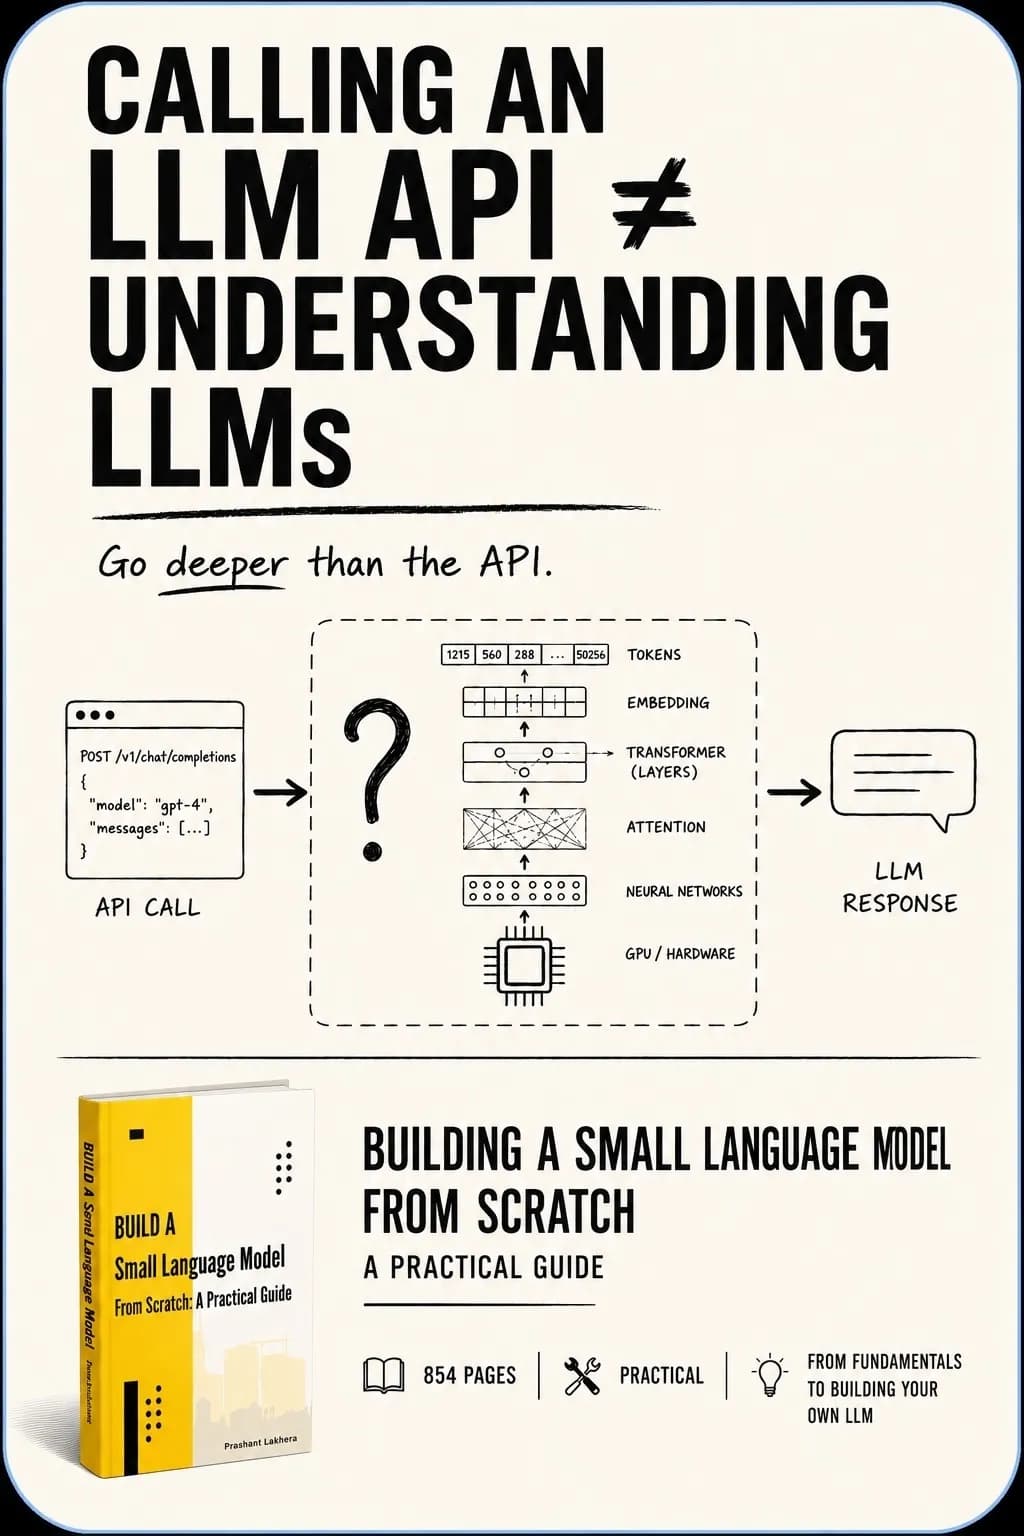
فراخوانی API مدل زبانی به معنای درک نحوه کار آن نیست
آموزش کاربردی

مصرف API در برابر تسلط بر ترنسفورمرها در مهندسی مدل‌های زبانی

بسیاری از توسعه‌دهندگان اتصال به API را با تخصص در هوش مصنوعی اشتباه می‌گیرند. یک راهنمای جامع جدید تأکید می‌کند که برای مهندسی واقعی، تسلط بر ترنسفورمرها و توکن‌سازی ضروری است.

۲ دقیقه خواندن
سیستم‌های صورتحساب اعتباری و محاسباتی مقاوم برای گردش کارهای سنگین GPU
آموزش کاربردی

واحد‌های محاسباتی دانه‌ریز؛ راهکار جدید برای پایان هزینه‌های پیش‌بینی‌ناپذیر GPU

یک چارچوب معماری جدید، صورت‌حساب‌های سادهٔ مبتنی بر زمان را با «واحدهای محاسباتی دانه‌ریز» (GCU) جایگزین می‌کند تا قیمت‌گذاری دقیق‌تری برای جریان‌های کاری سنگین هوش مصنوعی ارائه…

۱۳ دقیقه خواندن
اجرای محلی Qwen3.8 27B روی مک استودیو: اعداد واقعی و بنچمارک‌های عملکردی
آموزش کاربردی

مدل Qwen3.8 27B سرعت استنتاج را نصف کرد اما پاسخ‌ها را سریع‌تر به پایان می‌رساند

بنچمارک‌های مدل Qwen3.8 27B روی مک استودیو نشان می‌دهد که با وجود کاهش سرعت تولید توکن، به‌دلیل ایجاز بیشتر در پاسخ‌ها، زمان کل انتظار کاربر کاهش یافته است. این مدل امکان…

۹ دقیقه خواندن۴