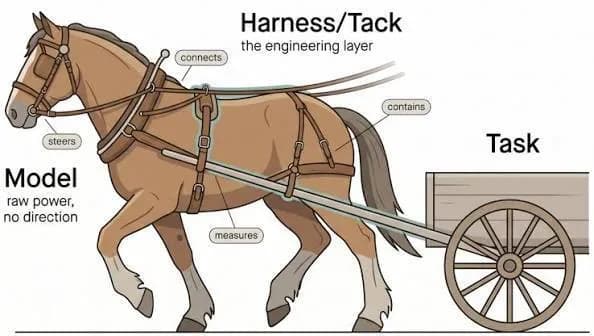
تصور کنید یک عامل هوش مصنوعی را برای پروژهای ششساعته استخدام کردهاید که باید دهها فایل کد را تغییر دهد، یک مخزن کد عظیم را بخواند، با مرورگر وب تعامل داشته باشد، APIهای داخلی را فراخوانی کند و در نهایت یک گزارش جامع تولید کند. اگر در آخرین مرحله و درست پیش از تایید نهایی، سیستم کرش کند، چه اتفاقی میافتد؟ آیا عامل باید همه چیز را از صفر شروع کند؟ آیا فایلهای تغییر یافته از بین میروند؟ آیا سیستم به یاد دارد که انسان قبلاً تاییدیه داده است؟ و از همه مهمتر، آیا پس از راهاندازی مجدد، عامل بهطور تصادفی یک پرداخت یا استقرار (Deployment) تکراری را اجرا میکند؟
اینجاست که تفاوت بین «مغز» و «بدن» هوش مصنوعی مشخص میشود. طبق تحلیلهای جاری در سال ۲۰۲۶، پارادایم هوش مصنوعی در حال تغییر است. برای سالها، صنعت تقریباً بهطور انحصاری بر روی مدل تمرکز داشت: تواناییهای استدلالی آن، پنجره متنی (Context Window) و تواناییاش در دنبال کردن دستورات پیچیده. اما اکنون در سال ۲۰۲۶، یک درک حیاتی ظهور کرده است: مدل صرفاً موتور محرک است، اما هارنس عامل (Agent Harness) — شبیه به شاسی و سیستم ترمز یک خودرو که موتور را در جای خود نگه میدارد و مسیر حرکت را کنترل میکند — همان چیزی است که تعیین میکند عامل چه چیزی را میبیند، کجا عمل میکند، چه دادههایی پس از یک سقوط سیستمی باقی میمانند، کدام اقدامات نیاز به تایید انسانی دارند و آیا نتیجه نهایی قابل اعتماد است یا خیر. در دنیای نرمافزارهای عاملمحور (Agentic)، سیستم پیرامونی اکنون به پلتفرم واقعی تبدیل شده است.
همانطور که در تحلیل قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، اتکای صرف به هوش مدل برای مدیریت عملیات پیچیده، ریسکهای امنیتی بزرگی ایجاد میکند. در سالهای گذشته، گفتگوها تحت سلطه بنچمارکها، امتیازات کدنویسی و قابلیتهای چندوجهی (Multimodality) بود. اگرچه این موارد اهمیت دارند، اما گلوگاه تغییر کرده است. مشکل سخت دیگر تنها این نیست که مدل گام بعدی درست را انتخاب کند؛ بلکه ساخت یک محیط زمان-اجرا (Runtime) است که بتواند هزاران اقدام را بهطور ایمن در برابر شکستها، بازنشانیهای متنی، توقفهای مربوط به تایید انسانی و تغییرات زیرساختی حفظ کند. به همین دلیل است که جدیدترین دستاوردهای ۲۰۲۶ بیشتر به توسعه سیستمعامل شبیه شدهاند تا پژوهشهای سنتی AI. ما شاهد جداسازی «نشست» (Session)، «هارنس» و «سندباکس» هستیم که اجازه میدهد هر یک بهطور مستقل شکست بخورند یا ارتقا یابند، بدون اینکه کل جریان کاری فرو بپاشد. برای درک عمیقتر این لایهها، میتوان به بررسی ۹ لایه دفاعی برای جلوگیری از فجایع عاملهای هوش مصنوعی رجوع کرد که ضرورت وجود لایههای قطعی را فراتر از استدلال مدل توضیح میدهد.
یک هارنس مستحکم بر چهار ستون اصلی استوار است:
پایداری (Durability): تضمین میکند وضعیت عامل ذخیره شود و دائمی باشد. در پیادهسازیهای اولیه، وضعیت (State) در پنجره متنی زندگی میکرد. اگر پنجره پر میشد یا نشست منقضی میشد، عامل پیشرفت خود را «فراموش» میکرد — شبیه به میز کاری که فقط جای چند ورق کاغذ دارد و با پر شدن آن، مطالب قدیمی دور ریخته میشوند. هارنسهای مدرن از نقاط بازرسی (Checkpoints) مستحکم استفاده میکنند. با تبدیل پیشرفت عامل به مجموعهای از انتقالهای وضعیت (State Transitions) که در یک پایگاه داده ذخیره میشوند (به جای تاریخچه چت ناپایدار)، سیستم میتواند تکلیف را دقیقاً از همان جایی که متوقف شده بود از سر بگیرد، فارغ از اینکه کرش رخ داده باشد یا مدل ارتقا یافته باشد. این امر یک عامل را از یک اسکریپت شکننده به یک نرمافزار سازمانی قابلاعتماد تبدیل میکند.
مشاهدهپذیری (Observability): مشکل «جعبه سیاه» استدلالهای عامل را حل میکند. وقتی یک عامل ۱۰۰ گام طی میکند، یک اپراتور انسانی بههیچوجه نمیتواند تکتک ردپاهای استدلالی را بخواند تا بفهمد چرا یک تصمیم خاص گرفته شده است. هارنسهای پیشرفته یک لاگ حسابرسی (Audit Log) ساختاریافته ارائه میدهند — نقشهای سطحبالا از اقدامات، فراخوانیهای ابزار و نتایج — که از «زنجیره تفکر» (Chain-of-Thought) داخلی مدل جدا شده است. این ساختار، شبیه به شاگرد ریاضی است که بلندبلند فکر میکند تا به جواب برسد، اما در اینجا ما فقط نتایج نهایی و گامهای کلیدی را میبینیم. این امر اجازه میدهد عیبیابی سریع انجام شود و انسانها بدون غرق شدن در نویزهای سطح توکن، مسیر حرکت عامل را نظارت کنند و کار عامل را به یک دفتر کل (Ledger) شفاف از فعالیتها تبدیل کند.
سطوح دسترسی (Permissioning): لایهی ایمنی و شاید حیاتیترین جزء هارنس است. یک مدل ممکن است «تصمیم بگیرد» برای حل یک مشکل، کل پایگاهداده را پاک کند، اما این هارنس است که مانع از این اقدام میشود. با پیادهسازی یک سیستم دسترسی مبتنی بر مانیفست (Manifest-based)، توسعهدهندگان میتوانند مرزهای سخت تعریف کنند. برخی اقدامات «کمریسک» هستند و میتوانند بهطور خودکار اجرا شوند، در حالی که اقدامات «پرریسک» — مانند تراکنشهای مالی یا استقرار در محیط عملیاتی (Production) — یک تایید اجباری توسط انسان در حلقه (Human-in-the-loop) را فعال میکنند. هارنس مدیریت توقف، اطلاعرسانی به انسان و ازسرگیری امن تکلیف را پس از دریافت تایید بر عهده دارد. این رویکرد تاییدیه انسانی در مقابل سیستمهای امتیازدهی پویا در مدیریت ریسک قرار میگیرد که نشان میدهد چرا تاییدیه یکباره برای عاملهای خودگردان کافی نیست. این یک لایه ایمنی ایجاد میکند که مستقل از غیرقابلپیشبینی بودن مدل است.
جداسازی محیط (Environment Isolation): از طریق سندباکس (Sandbox) یا محیطهای ایزوله، تضمین میکند اقدامات عامل به سیستم میزبان آسیب نزند. روند سال ۲۰۲۶ به سمت محیطهای کاری موقت و یکبارمصرف (Ephemeral) است. وقتی یک عامل نیاز به اجرای کد یا تغییر فایلها دارد، هارنس یک کانتینر امن را بالا میآورد. اگر عامل بهطور تصادفی یک دستور مخرب را اجرا کند، تنها سندباکس آسیب میبیند. پس از اتمام تکلیف، سندباکس برای اهداف حسابرسی اسنپشات (Snapshot) شده و سپس نابود میشود. این جداسازی اجازه میدهد عاملها با درجهای از آزادی عمل کنند که روی یک سیستم Bare-metal غیرقابلتصور بود. در واقع، اهمیت این محدودیتها را میتوان در مورد عامل Sonjomon مشاهده کرد که ترجیح داد به جای اصلاح خودسرانه و ریسکپذیر خطاهای سرور، از خویشتنداری استفاده کند.
بر اساس مستندات منتشر شده از آزمایشگاههای بزرگ AI، این تغییر کاملاً مشهود است. ما شاهد معرفی محیطهای کاری پایدار، مانیفستها و اسنپشاتها هستیم. هدف این است که از «مهندسی پرامپت» فاصله گرفته و به سمت «مهندسی سیستم» حرکت کنیم. مزیت رقابتی دیگر تنها داشتن هوشمندترین مدل نیست، بلکه داشتن مستحکمترین هارنس است. یک مدل با هوش کمی کمتر که در یک هارنس درجهیک قرار دارد، بهطور مداوم از یک مدل نابغه در محیطی شکننده بهتر عمل میکند؛ زیرا میتواند از خطاها بازیابی شود، پروتکلهای ایمنی سختگیرانه را رعایت کند و وضعیت را در بازههای زمانی طولانی حفظ کند.
این تحول نقش توسعهدهندگان را نیز تغییر داده است. آنها بهجای صرف ساعتها وقت برای اصلاح پرامپتها جهت جلوگیری از توهم (Hallucination) — وقتی مدل با اطمینان چیزی میگوید که وجود ندارد، مثل دوستی که خاطرهای را اشتباه تعریف میکند — اکنون در حال طراحی ماشینهای وضعیت (State Machines) و تعریف مرزهای دسترسی هستند. آنها در حال ساخت «گاردریلها» و «تورهای ایمنی» هستند که به AI اجازه میدهد بهطور خودگردان عمل کند. تمرکز از «مغز» به «سیستم عصبی» منتقل شده است — همان زیرساختی که مغز را به جهان متصل میکند و تضمین میکند سیگنالها بهطور قابلاعتمادی منتقل شوند.
علاوه بر این، مفهوم «چابکی مدل» (Model Agility) از طریق هارنس ممکن شده است. چون وضعیت و محیط از مدل جدا شدهاند، توسعهدهنده میتواند در میانه یک تکلیف، مدل زبانی (LLM) زیربنایی را عوض کند. اگر یک تکلیف برای برنامهریزی به استدلال سطحبالا نیاز دارد اما برای کدنویسی به اجرای ساده، هارنس میتواند گامهای مختلف را به مدلهای مختلف هدایت کند. اگر مدل جدیدتر و کارآمدتری منتشر شود، هارنس میتواند وضعیت موجود را به مدل جدید منتقل کند بدون اینکه نیاز به شروع مجدد کل فرآیند باشد. این ماژولار بودن از وابستگی به یک فروشنده خاص (Vendor Lock-in) جلوگیری کرده و بهینهسازی مداوم هزینه و عملکرد را ممکن میسازد.
در نهایت، هارنس عامل حلقه مفقوده بین دموهای جذاب و استقرار واقعی در صنعت است. صنعت از فاز «جادوی» رابطهای چت عبور کرده و وارد فاز سختگیرانهی مهندسی نرمافزار شده است تا مدلهای زبانی را از یک همکار خلاق به یک کارمند خودگردان و قابلاعتماد تبدیل کند. آینده نرمافزارهای عاملمحور با این تعریف نخواهد بود که چه کسی بزرگترین مدل را دارد، بلکه با این تعریف خواهد بود که چه کسی مستحکمترین سیستم را برای جای دادن آن مدل میسازد. هارنس جایی است که قابلیت اطمینان واقعی در آن نهفته است و بنیادی است که نسل بعدی نرمافزارهای سازمانی خودگردان بر روی آن بنا خواهد شد.
گام بعدی شما
- بررسی معماریهای State-based برای جایگزینی حافظه متنی در عاملهای خودتان.
- پیادهسازی لایهی تایید انسانی (Human-in-the-loop) برای تمامی توابع حساس API.
- تست استقرار عامل در محیطهای کانتینری ایزوله برای جلوگیری از دسترسیهای غیرمجاز به سیستم.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو