تصور کنید سد ورود به دنیای پژوهشهای هوش مصنوعی دیگر یک بودجه شرکتی چندمیلیاردی نباشد، بلکه صرفاً یک سیستم دسکتاپ ردهبالا در خانه باشد. این رویایی است که پروژه CetinLM با پردازش ۲.۰۵ میلیارد توکن روی یک واحد پردازش گرافیکی (GPU) مصرفکننده ۱۶ گیگابایتی NVIDIA RTX — شبیه به موتور قدرتمند یک ماشین مسابقه که حالا در یک گاراژ کوچک خانه میراند — به واقعیت تبدیل کرده است. این حجم از داده برای یک مدل بنیادین پردازش شده و اتکای صنعت به خوشههای عظیم GPU را به چالش کشیده است.
به نقل از مستندات این پروژه در ۱۶ سپتامبر ۲۰۲۶، این دستاورد نشان میدهد که مهندسی دقیق میتواند جایگزین زیرساختهای عظیم شود که معمولاً برای پژوهشهای هوش مصنوعی مورد نیاز است. سالهاست روایت غالب در این صنعت «چاقی محاسباتی» است؛ وضعیتی که در آن موفقیت با اندازه مرکز داده و میزان سرمایه جسورانه برای سختافزار سنجیده میشود. همانطور که در تحلیلهای پیشین ما دربارهی مدلهای زبانی کوچک اشاره کردیم، بسیاری از توسعهدهندگان پذیرفته بودند که پیشآموزش یک مدل از صفر، بدون دسترسی به خوشههای سازمانی غیرممکن است. این رویکرد در تضاد با تلاشهای اخیر برای بهینهسازی است، مشابه آنچه در دستوردهٔ پیشآموزش Magic برای کاهش ۱۰ برابری هزینههای محاسباتی مشاهده کردیم.
زمینه: بحران چاقی محاسباتی
در حال حاضر، کنگلomeratهای فناوری جهانی معماریهای حجیمی میسازند که مقادیر عظیمی از برق را مصرف میکنند. این ناکارآمدی ساختاری اغلب به عنوان یک اختراع مرموز و تقریباً «بیگانه» بازاریابی میشود تا ارزشهای مالی نجومی این شرکتها توجیه گردد. این رویکرد منجر به یک بحران محیطزیستی ناشی از مصرف ناپایدار انرژی در اکوسیستم هوش مصنوعی شده است.
این اتکا به قدرت خام محاسباتی، منجر به ایجاد یک انحصار متمرکز در منابع شده است. این وضعیت القا میکند که نوآوری واقعی مستلزم سوزاندن شبکههای برق کوچک است تا بتوان تنها یک مدل بنیادین را آموزش داد. اما CetinLM با اثبات این موضوع که انضباط الگوریتمی سختگیرانه میتواند بیشترین هوش معنایی را در هر وات برق استخراج کند، این انحصار را به چالش میکشد.
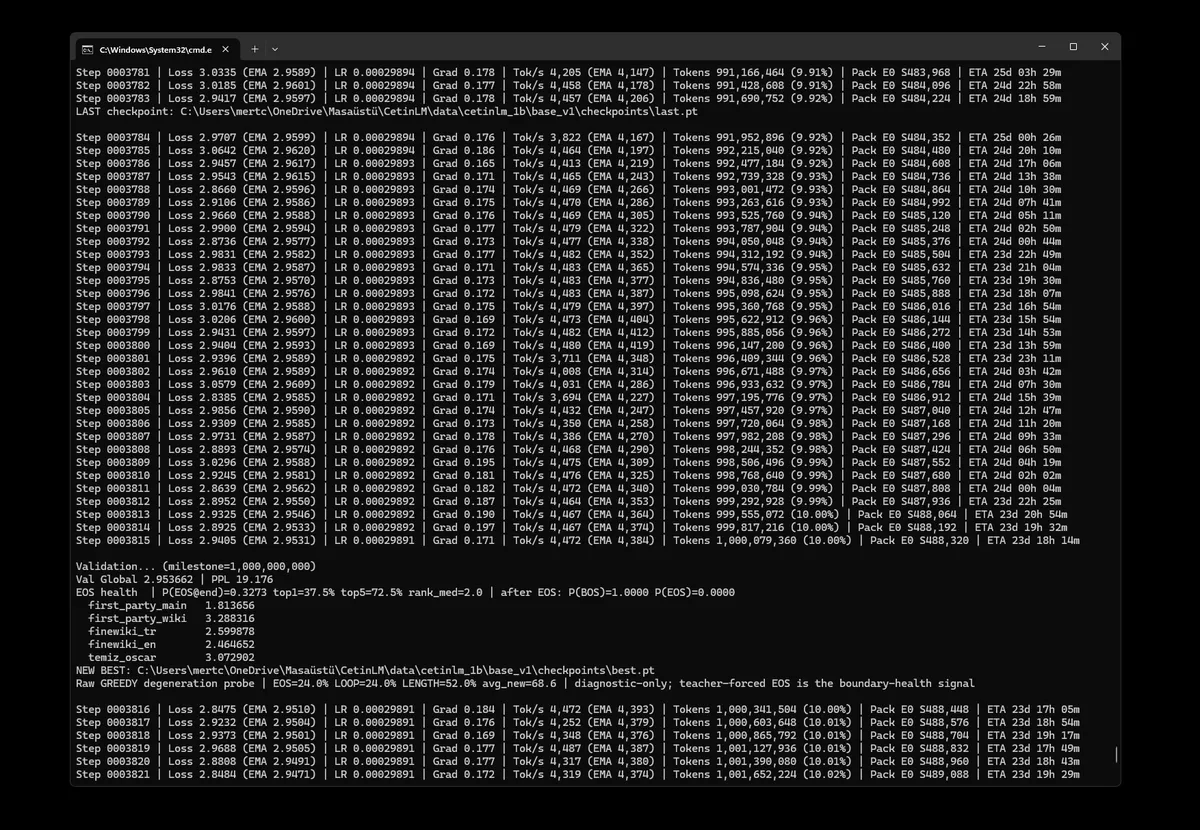
این مدل تحت نظر شرکت Me Force Technology توسعه یافته و توانسته است از چالشهای رایج سختافزارهای خانگی، مثل کرشهای حافظه ویدیویی (VRAM) یا تخریب محاسباتی، عبور کند. مرت چتین (Mert Cetin)، معمار ارشد پروژه، گزارشهای عملکردی را منتشر کرد که نشاندهنده یک منحنی اعتبارسنجی پایدار در حین مقیاسپذیری مدل است:
- ۱.۸۰ میلیارد توکن: تابع زیان اعتبارسنجی ۲.۷۶۵
- ۲.۰۵ میلیارد توکن: تابع زیان اعتبارسنجی ۲.۷۳۹
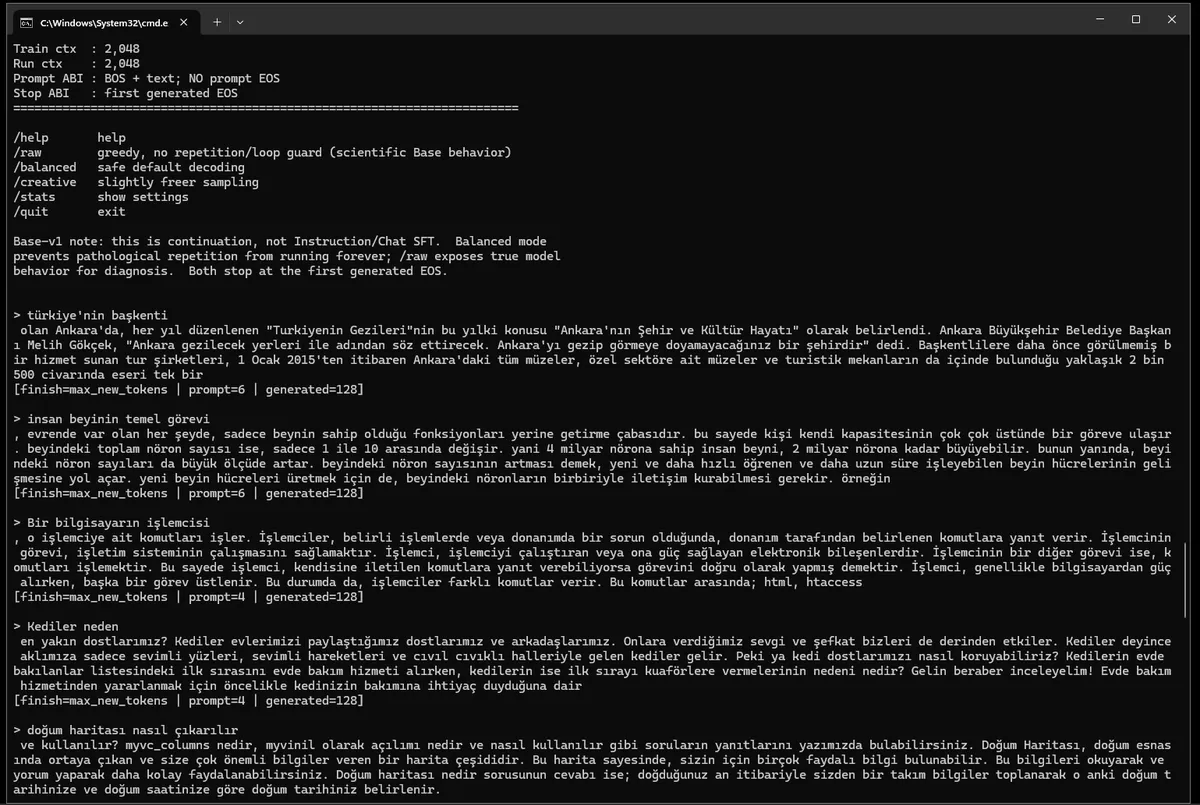
بر اساس بررسیهای فنی، حتی پیش از مراحل تنظیم نظارتشده (SFT) — که مثل آموزش یک پزشک عمومی برای تخصص در یک رشته خاص است — یا همراستاسازی چت و تقویت جستجو (Search Augmentation)، معماری خام مدل توانست با احتمال ۷۵.۱٪ دادههای زمینهای متمایز را درست شناسایی کند (مثلاً شناسایی صحیح آنکارا به عنوان پایتخت ترکیه). این نشان میدهد که سیستم در مرحله پیشآموزش (Pre-training) توانسته است هندسه زبانی را بهدرستی استخراج و تقطیر کند.
جزئیات استراتژی مهندسی
تیم CetinLM بهجای مقیاسپذیری کورکورانه و متکی بر قدرت خام، از انضباط برنامهنویسی استفاده کرد. آنها یک خط لوله آموزشی سفارشی را از صفر ساختند که شامل موارد زیر است:
- معماریهای اختصاصی برای سازماندهی و کیوریتوری دادهها
- قراردادهای سطح پایین برای توکنسازی (Tokenization) — یعنی تبدیل متن به تکههای کوچک شبیه برشهای کیک که مدل راحتتر آنها را بخورد
- بهینهسازیهای خالص در سطح پایین بدون استفاده از لایههای واسط (Wrappers) یا مدلهای بازسازیشده (Rebranded Fine-tunes)
این رویکرد اجازه میدهد تا سیستم بیشترین هوش ممکن را در هر وات انرژی استخراج کند و یک فضای کاری دسکتاپ استاندارد را به یک آزمایشگاه هوش مصنوعی سبز و بهینهشده تبدیل نماید. برای درک بهتر نحوه مدیریت بهینه جریان دادهها در محیطهای عملیاتی، میتوان معماری Triton و تبدیل دادهها به موتورهای اعتبارسنجی را بررسی کرد.
طبق شرح عمومی پروژه، هدف این بود که مدل سبکتر و آموزش هوشمندتر شود. مرت چتین در این باره میگوید: «هوش مصنوعی جادو نیست؛ بلکه ریاضیات، داده، بهینهسازی و مهندسی سیستم است. مدل را سبکتر کنید. آموزش را هوشمندتر کنید. اجازه دهید هر وات برق، هر توکن و هر پارامتر، جایگاه خود را در مدل به دست آورد.»
با تمرکز بر یک اکوسیستم محلی، پژوهشگران جایگزینی پایدار برای معماریهای تشنهی انرژی غولهای فناوری ایجاد کردند. این تغییر در عمل نشان میدهد که «خندقه» یا همان موانع دفاعی تکچاپهای فناوری، بر پایه ضرورت ریاضی نیستند، بلکه بر پایه ترجیح برای مقیاسهای ناکارآمد بنا شدهاند.
برای یک توسعهدهنده مستقل، این به معنای توانایی ساخت پشتههای نرمافزاری حاکمیتی و محلی است، بدون آنکه وابسته به ارائهدهندگان ابری خارجی باشد. از نظر اثرات محیطزیستی، این متد به مصرف ناپایدار الکتریسیتهای که در حال حاضر این حوزه را گرفتار کرده است، پاسخ میدهد.
آنچه این دستاورد برای کل این رشته تغییر میدهد، فرض بنیادین «قوانین مقیاسپذیری» (Scaling Laws) است. اگر یک GPU مصرفکننده بتواند پشتهای از ۲.۰۵ میلیارد توکن را مدیریت کند، نیاز به مراکز داده عظیم دیگر یک محدودیت فنی نیست، بلکه یک انتخاب است. این ثابت میکند وقتی انضباط مهندسی بر قوانین مقیاسپذیری کورکورانه اولویت یابد، تکچاپهای فناوری موانع دفاعی خود را از دست میدهند.
نقشه راه CetinLM اکنون به سمت آزمایش محدودیتهای سختافزارهای ۲۴ گیگابایتی برای آموزش پیکربندیهای بزرگتر و توانمندتر به صورت بومی (Native) حرکت میکند. این گام به دنبال کشف مرزهای بهرهوری است، نه درخواست تخصیص منابع از مراکز داده خارجی.
توسعهدهندگان میتوانند پیشرفت ریاضیاتی این معماری را از طریق پروفایل رسمی XertXetin در X یا زیرساخت CetinLM دنبال کنند.
گام بعدی شما
- بررسی مستندات بهینهسازی VRAM در پروفایل XertXetin برای کاهش هزینههای آموزش مدلهای محلی.
- آزمایش مدلهای کوچکتر (SLM) روی سختافزارهای خانگی با استفاده از تکنیکهای بهینهسازی سطح پایین.
- دنبال کردن پیشرفتهای CetinLM در مسیر عبور از ۱۶ گیگابایت به ۲۴ گیگابایت حافظه گرافیکی.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است؛ برای درک اینکه چگونه تراشههای جدید مرزهای استنتاج را جابهجا میکنند، به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو