اگر برای مدیریت هزینههای API خود روی سقف توکنهای ابزارهای هوش مصنوعی حساب میکنید، باید بدانید که این سقفها همیشه امن نیستند. یک نقص فنی در نحوه محاسبه حجم دادهها در Claude Code میتواند صورتحساب ماهانه شما را بهطور غیرمنتظرهای چند برابر کند.
طبق گزارشی که در ۲۳ سپتامبر ۲۰۲۶ در وبسایت dev.to منتشر شد، ابزار Claude Code با وجود اعلام محدودیت ۲۵ هزار توکنی، در برابر متون متراکم زبانهای CJK (چینی، ژاپنی و کرهای) تسلیم میشود. در یک آزمایش، رشتهای از متن با ۲۴ هزار نویسه توانست ۴۹٬۹۶۴ توکن (Token) — یعنی تقریباً دو برابر سقف مجاز — را مستقیماً وارد پنجره زمینه (Context Window) مدل کند.
همانطور که در تحلیل قبلی ما دربارهی تلاشهای Anthropic برای کاهش هزینههای استنتاج در مدل Opus 5.5 اشاره کردیم، بهینهسازی در سطح مدل تنها نیمی از مسیر است. اگر ابزارهای واسط در مدیریت خروجیها ناکارآمد باشند، تمام دستاوردهای کاهش هزینه در سطح مدل با جهشهای ناگهانی توکنها از بین میرود.
تصور کنید یک سرور پروتکل زمینه مدل (MCP) — شبیه به یک مترجم تخصصی که ابزارهای خارجی را به زبان مدل ترجمه میکند — میسازید که لاگهای بینالمللی را پردازش میکند. شما برای پیشبینی هزینهها روی سقف ۲۵ هزار توکنی تکیه میکنید، اما وقتی ابزار شما متنی متراکم برمیگرداند، این سقف عملاً ناپدید میشود.
جزئیات محیط آزمایش
پژوهشگران این تستها را در ۱۶ سپتامبر ۲۰۲۶ روی نسخه v2.1.273 ابزار Claude Code و مدل claude-opus-5[1m] اجرا کردند. برای ایزوله کردن محیط، آنها از یک اسکریپت پایتون بدون وابستگی استفاده کردند که از طریق JSON-RPC با مدل ارتباط برقرار میکرد.
این سرور دارای دو ابزار بود: emit_text برای بازگرداندن تعداد مشخصی نویسه و emit_text_annotated که یک محدودیت ۳۰۰٬۰۰۰ نویسهای را در متادیتای خود تعریف کرده بود. برای تأیید دریافت کامل متن، از سیستم نشانگر (Marker) در ابتدا و انتهای متن استفاده شد تا مشخص شود آیا مدل تمام خروجی را دریافت کرده است یا خیر.
برای حذف متغیرهای مزاحم، از دستور --strict-mcp-config استفاده شد تا ابزارهای داخلی غیرفعال شوند. هزینهها با تحلیل ترنسکریپتها در مسیر ~/.claude/projects/ و جمع زدن توکنهای ورودی و توکنهای خواندهشده از حافظه پنهان (Cache) محاسبه شد.
سازوکار شکست سیستم
بر اساس بررسیهای فنی، سیستم برای مدیریت نتایج حجیم از دو بررسی متوالی استفاده میکند که روی انواع مختلف متن، یکسان عمل نمیکنند:
- بررسی اندازه (Size Check): زمانی فعال میشود که خروجی بین ۴۵٬۰۰۰ تا ۵۲٬۰۰۰ نویسه باشد. در این حالت، خروجی با یک پیشنمایش ۲ کیلوبایتی جایگزین شده و متن کامل در یک فایل JSON ذخیره میشود.
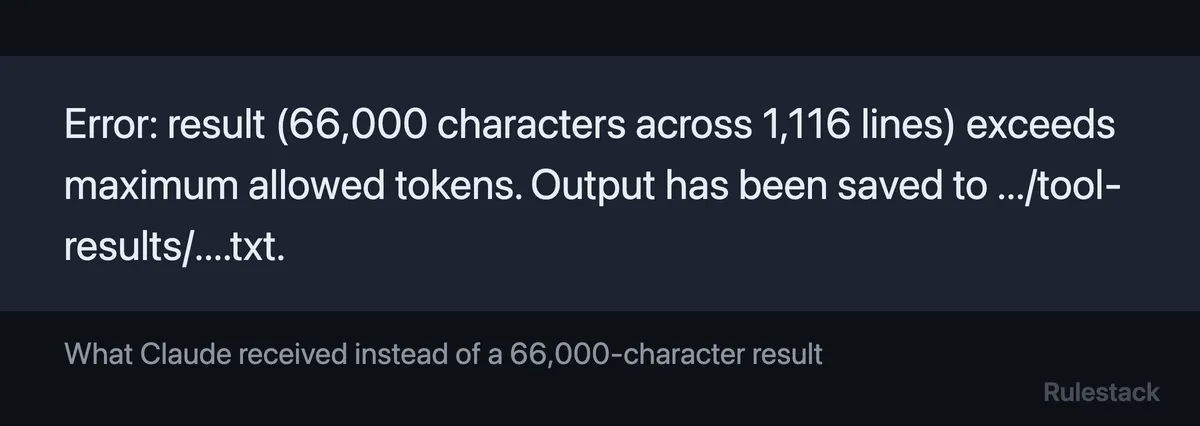
- بررسی توکن (Token Check): این مرحله یک درخواست به API شمارش توکنها ارسال میکند. اگر تعداد توکنها از ۲۵٬۰۰۰ بیشتر باشد، پیام خطا نمایش داده شده و مسیر فایل متنی جایگزین میشود.
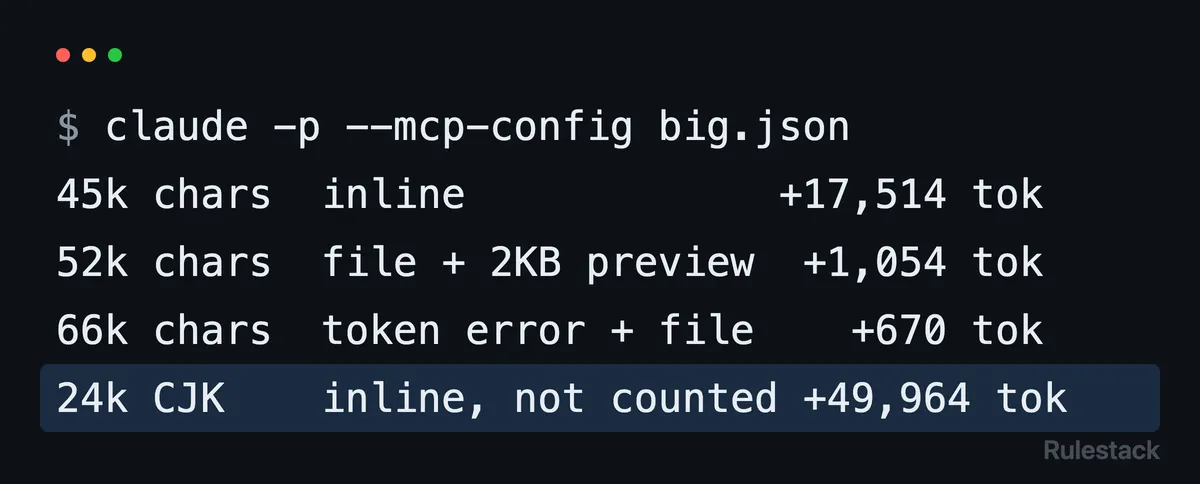
مشکل اینجاست که بررسی توکن تنها بعد از عبور از آستانه نویسهها در بررسی اول اجرا میشود. اگر متنی از نظر تعداد نویسه کوتاه اما از نظر توکن متراکم باشد، هر دو لایه حفاظتی را دور میزند. لاگهای دیباگ تأیید کردند که برای نتایجی زیر ۴۵٬۰۰۰ نویسه، هیچ درخواستی برای شمارش توکنها ارسال نمیشود.
رخنه در زبانهای CJK
در یک آزمایش مشخص، پژوهشگران ۲۴٬۰۰۰ نویسه تصادفی CJK را بازگرداندند. در حالی که هر نویسه انگلیسی حدود ۰.۳۹ توکن هزینه دارد، هر نویسه CJK حدود ۲ توکن مصرف میکند.
چون ۲۴٬۰۰۰ نویسه بسیار کمتر از آستانه ۴۵٬۰۰۰ نویسه بود، Claude Code هرگز درخواست شمارش توکن نداد. در نتیجه، ۴۹٬۹۶۴ توکن بهطور کامل وارد بستر متن شد. این خطا اثر مالی مستقیم داشت: هزینه این اجرای واحد ۰.۵۱ دلار بود، در حالی که اجراهای مشابه که بهدرستی به فایل منتقل شده بودند، تنها ۰.۰۲ دلار هزینه داشتند.
تحلیل سلسلهمراتبی اندازه
پژوهشگران با تغییر اندازه خروجی، مرزهای سیستم را بهصورت زیر ترسیم کردند:
- ۲٬۰۰۰ نویسه: ارسال کامل در متن (۸۷۱+ توکن). بدون شمارش توکن.
- ۳۰٬۰۰۰ نویسه: ارسال کامل در متن (۱۱٬۶۸۷+ توکن). بدون شمارش توکن، علیرغم عبور از آستانه هشدار ۱۰ هزار توکنی.
- ۴۵٬۰۰۰ نویسه: ارسال کامل در متن (۱۷٬۵۱۴+ توکن). بدون شمارش توکن.
- ۵۲٬۰۰۰ نویسه: فعال شدن بررسی اندازه. ارسال پیشنمایش ۲ کیلوبایتی و فراخوانی
count_tokens. - ۶۲٬۰۰۰ نویسه: فعال شدن بررسی اندازه، اما چون تعداد توکنها (حدود ۲۴٬۱۰۰) زیر سقف بود، پیشنمایش ارسال شد.
- ۶۶٬۰۰۰ نویسه: فعال شدن بررسی توکن. جایگزینی متن با پیام خطا و مسیر فایل.
- ۲۴٬۰۰۰ نویسه CJK: دور زدن تمام بررسیها و ارسال کامل ۴۹٬۹۶۴ توکن.
تفاوت در فرمت فایلها
وقتی محدودیتها فعال میشوند، سیستم بسته به نوع بررسی، دادهها را متفاوت ذخیره میکند:
- نتایج مبتنی بر توکن: بهصورت فایلهای
.txtساده ذخیره میشوند که شکست خطوط را حفظ میکنند و اجازه میدهند ابزارReadبا استفاده از آفستها (Offset) بهطور بهینه عمل کند. - نتایج مبتنی بر اندازه: بهصورت آرایههای JSON ذخیره میشوند که کل خروجی را در یک رشته متنی در یک خط قرار میدهند. برای یک نتیجه ۵۲٬۰۰۰ نویسهای، یک خط واحد با طول ۵۲٬۸۹۱ نویسه ایجاد شد.
دور زدن محدودیتها
پژوهشگران دو روش برای تغییر این سقفها را بررسی کردند:
۱. متغیر محیطی MAX_MCP_OUTPUT_TOKENS: افزایش این مقدار به ۵۰٬۰۰۰ برای یک نتیجه ۶۶٬۰۰۰ نویسهای، بررسی توکن را خاموش کرد اما نتیجه همچنان بهدلیل بررسی اندازه به فایل منتقل شد.
۲. متادیتای anthropic/maxResultSizeChars: ابزاری که محدودیت ۳۰۰٬۰۰۰ نویسه را اعلام کرده بود، توانست ۶۶٬۰۰۰ نویسه را بدون هیچ بررسی توکنی بهصورت inline ارسال کند. این نشان میدهد متادیتای ابزار، هر دو بررسی پیشفرض را لغو میکند.
اثر بر عملکرد مدل
جالب است که مسیر فایل اغلب بهینهتر است. برای یافتن یک نشانگر در انتهای یک متن ۶۶٬۰۰۰ نویسهای، مدل با یک بار خواندن فایل و استفاده از آفست، تنها ۵٬۲۴۵ توکن مصرف کرد، در حالی که ارسال inline هزینه ۲۸٬۸۶۷ توکنی داشت — یعنی کمتر از یکپنجم هزینه.
گام بعدی شما
- اگر توسعهدهنده MCP هستید، هرگز به محدودیتهای کلاینت برای کنترل بودجه تکیه نکنید.
- برای متون CJK یا دادههای Base64، سیستم سقفگذاری (Capping) را در لایه سرور پیادهسازی کنید.
- از ابزار
Readبرای دسترسی به دادههای حجیم بهجای ارسال مستقیم در متن استفاده کنید تا هزینه استنتاج کاهش یابد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو