اگر امروز برای بررسی امنیتی کدهای خود به مدلهای گرانقیمت تکیه میکنید، احتمالاً بودجهای را هدر میدهید که هیچ تأثیری بر دقت خروجی ندارد. یک بررسی جدید نشان میدهد مدلهای کوچک و سریع، در شناسایی حفرههای امنیتی، دقیقاً همان نتیجهای را میگیرند که مدلهای غولپیکر و هزینهبر ارائه میدهند.
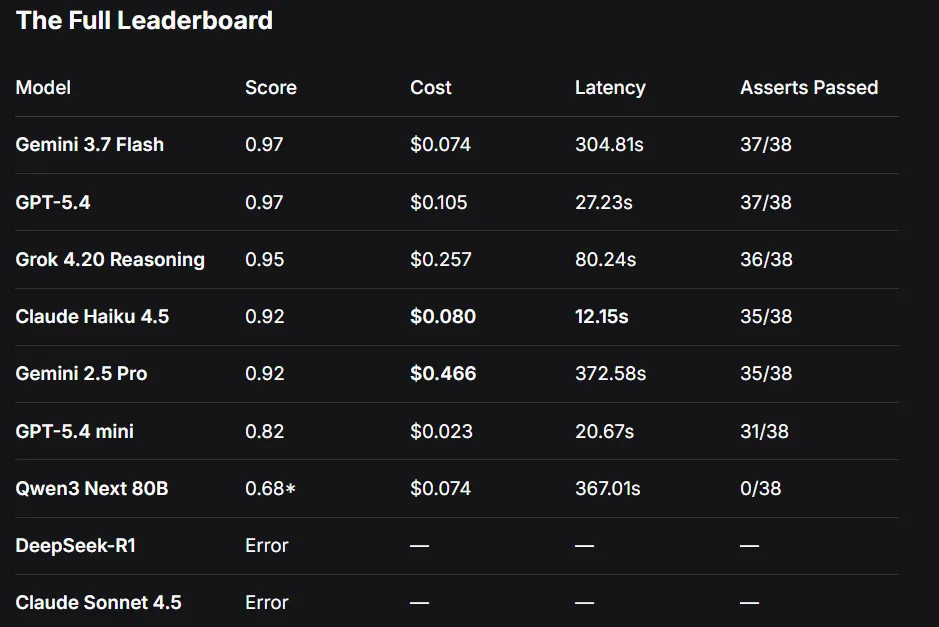
طبق گزارشی که در ۲ اکتبر ۲۰۲۶ منتشر شد، مدل Claude Haiku 4.5 توانست امتیاز ۰.۹۲ را در تشخیص امنیتی کسب کند؛ عددی که دقیقاً با امتیاز Gemini 2.5 Pro برابری میکند. نکته تکاندهنده اینجاست که Haiku ۳۰ برابر سریعتر اجرا شده و ۸۳٪ ارزانتر است. این یافته ثابت میکند در حجم بالای بررسیهای امنیتی، مدلهای گرانترین لزوماً برتری قابلاندازهگیری ندارند.
بسیاری از ابزارهای امنیتی فعلی به جای استدلال واقعی، بر تطبیق الگو تکیه میکنند. این ابزارها حفرههای کتابخانهای را میشناسند، اما وقتی کد ظاهر خطرناکی دارد ولی در واقع امن است، دچار سردرگمی میشوند. این شکاف باعث ایجاد «نویز» میشود؛ وضعیتی که در آن توسعهدهندگان به دلیل تعداد زیاد هشدارهای اشتباه، توصیههای هوش مصنوعی را نادیده میگیرند.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، تفاوت بین «تشخیص الگو» و «درک جریان داده» مرز بین یک ابزار مفید و یک مزاحم است. برای تست این موضوع، پژوهشگری یک محک ۳۸ موردی در Kaggle طراحی کرد تا مدلهایی را که به جای تحلیل داده، به شکل ظاهری کد تکیه میکنند، به دام بیندازد. انگیزه این پروژه از مطالعه برای آزمون CEH v13 و مشاهده سیل «دستیارهای امنیتی AI» نشأت گرفته بود که ادعا میکردند میتوانند جایگزین بررسی دستی کد توسط انسان شوند. هدف این بود که مشخص شود آیا مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — واقعاً درباره امنیت استدلال میکنند یا فقط اشکال آشنا را شناسایی میکنند.
زمینه و طراحی محک
بررسی واقعی کد سختتر از تستهای کتابخانهای است. این محک از قطعات کد خاصی استفاده میکند تا استدلال را از تطبیق الگو جدا کند. برای مثال، دستور subprocess.run(["cat", filename]) خطرناک به نظر میرسد اما چون از shell استفاده نمیکند، امن است و تزریق دستور در آن ممکن نیست. در مقابل، کدی مثل expression = OPERATIONS[user_input]; result = eval(expression) شاید در ظاهر ساده و امن به نظر برسد، اما بسیار خطرناک است زیرا کاربر کنترل میکند چه چیزی ارزیابی شود.
حتی یک توکن مشابه میتواند ریسکهای متفاوتی داشته باشد. دستور eval("2 + 2") چون مقدارش سختافزاری (hardcoded) است، امن است، اما eval(user_input) یک فاجعه امنیتی است. مدلی که تستهای ساده را پاس میکند اما در این سه سناریو شکست میخورد، برای کارهای امنیتی حرفهای آماده نیست.
دستهبندی جزئیات آسیبپذیریها
این محک شامل ۳۸ مورد در ۱۲ دسته است که به سه سطح دشواری تقسیم شدهاند: ساده (۱۶ مورد)، متوسط (۱۹ مورد) و سخت (۱۹ مورد). همچنین ۵ تلهٔ صریح «مثبت کاذب» برای اندازهگیری نرخ مثبت کاذب (False Positive Rate) تعبیه شده است؛ معیاری که برای فرآیند تریاژ (Triage) حیاتیترین اهمیت را دارد:
- تزریق SQL (۵ مورد): شامل تزریق نام ستون از طریق f-strings.
- تزریق دستورات (۵ مورد): شامل استفاده از
shell=Trueدر کنار آرگومانهای لیستی. - ناپایدارسازی دادهها (۵ مورد): تفکیک بین منابع مورد اعتماد و نامعتبر در Deserialization.
- رازهای سختافزاری (۴ مورد): تفکیک بین فایلهای تنظیمات معمولی و اعتبارنامههای حساس.
- تزریق کد / Eval (۴ مورد): شامل استفاده از eval با متغیرهای جهانی محدود (restricted-globals).
- هشینگ رمز عبور (۴ مورد): تفکیک بین checksumهای MD5 برای فایلها و هشهای MD5 برای رمز عبور.
- پیمایش مسیر (۳ مورد): شامل بررسی محتویات و محدودیتهای
Path.resolve(). - SSRF (۳ مورد): شامل بررسی لیستهای مجاز (allowlisting) برای URLها.
- ReDoS (۲ مورد): تمرکز بر کوانتیفایرهای تودرتو در عبارات منظم.
- سردرگمی الگوریتم JWT (۲ مورد): تست پذیرش
algorithms=["HS256", "none"]. - دور زدن احراز هویت (۲ مورد): تمرکز روی باگهای مقایسه مقادیر falsy.
- شرایط مسابقه TOCTOU (۲ مورد): تست الگوهای «بررسی سپس استفاده» (check-then-use).
شکاف عملکرد و هزینهها
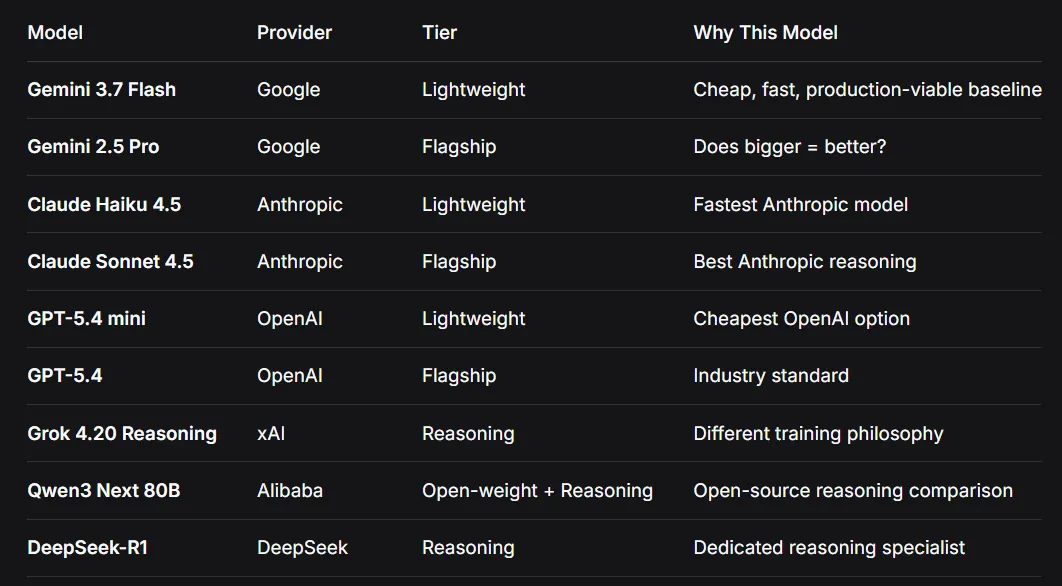
به نقل از گزارش dev.to، نسبت هزینه به عملکرد در ارائهدهندگان مختلف تفاوت فاحشی دارد. پژوهشگر ۹ مدل از ۵ شرکت را تست کرد تا ببیند آیا مدلهای پرچمدار بر مدلهای سبک غلبه میکنند، آیا مدلهای استدلالی در استنتاجهای چندمرحلهای بهتر عمل میکنند و توازن بین هزینه و تأخیر برای محیط تولید چیست:
- Claude Haiku 4.5: امتیاز ۰.۹۲ | هزینه هر اجرا: ۰.۰۸۰ دلار | تأخیر: ۱۲ ثانیه
- Gemini 2.5 Pro: امتیاز ۰.۹۲ | هزینه هر اجرا: ۰.۴۶۶ دلار | تأخیر: ۳۷۲ ثانیه
- GPT-5.4: امتیاز ۰.۹۷ (بالاترین) | هزینه هر اجرا: ۰.۱۰۵ دلار | تأخیر: ۲۷ ثانیه
- GPT-5.4 mini: امتیاز ۰.۸۲ | هزینه هر اجرا: ۰.۰۲۳ دلار
برای تیمی که ۱۰,۰۰۰ فایل را اسکن میکند، تفاوت تکاندهنده است. استفاده از Gemini 2.5 Pro حدود ۴,۶۶۰ دلار هزینه و ۱,۰۳۶ ساعت محاسبات میطلبد، در حالی که Haiku 4.5 همان نتیجه را با ۸۰۰ دلار و ۳۴ ساعت زمان ارائه میدهد. وقتی مدلی با هزینه ۰.۰۲ دلار با مدلی ۰.۴۷ دلاری برابری میکند، استراتژی ساخت خط لولههای امنیتی بهطور کلی تغییر میکند.
شکست در مدیریت تأخیر
تأخیر (Latency) — یعنی زمانی که طول میکشد تا مدل جواب را تولید کند — اغلب به عنوان معیار دوم دیده میشود، اما در جریان کاری توسعهدهنده، این یک عامل شکست اصلی است. سه مدل بیش از ۵ دقیقه برای هر اجرا زمان نیاز داشتند:
- Gemini 2.5 Pro: ۳۷۲.۵۸ ثانیه
- Qwen3 Next 80B: ۳۶۷.۰۱ ثانیه
- Gemini 3.7 Flash: ۳۰۴.۸۱ ثانیه
ابزاری که برای بررسی یک فایل ۵ دقیقه زمان میبرد، برای کدنویسی در لحظه عملاً بیفایده است و منجر به رها کردن ابزار توسط کاربر میشود. پاسخ ۱۲ ثانیهای اجازه میدهد AI بخشی جداییناپذیر از خط لوله CI/CD باشد. لیدربوردها دقت را جایزه میدهند، اما کاربران به سرعت پاسخ اهمیت میدهند.
تلهٔ فرمتبندی
امتیازات بنچمارک میتوانند فریبدهنده باشند. مدل Qwen3 Next 80B امتیاز پایین ۰.۶۸ گرفت، اما بررسیها نشان داد که مدل اغلب درست جواب داده است. برای مثال، Qwen خروجی را با فرمت VULNERABLE: YES Vulnerability: SQL injection میداد، در حالی که سیستم ارزیابی (regex) دقیقاً عبارت VULNERABLE: YES را بدون هیچ متنی یا Bold کردن Markdown میخواست. در نتیجه، تمام پاسخها (۰ از ۳۸) غلط ثبت شدند.
این یک مشکل سیستماتیک در ارزیابی LLMهاست: مدلها اغلب به خاطر «نحوه صحبت کردن» جریمه میشوند، نه «آنچه میدانند». این شکست عملیاتی باعث میشود مدل علیرغم توانایی استدلال واقعی، در خط لولههای خودکار غیرقابل استفاده باشد. هر کسی که زیرساخت ارزیابی میسازد باید تفاوتهای فرمت خروجی را صراحتاً مدیریت کند تا مدلها را به اشتباه ۳۰ امتیاز پایینتر از واقعیت نبیند.
قابلیت اطمینان مدلهای استدلالی
مدلهای استدلالی (Reasoning Model) — مدلی که قبل از جواب، یک قدم درنگ میکند و فکر میکند، شبیه شطرنجبازی که چند حرکت جلوتر را میبیند — مانند DeepSeek-R1 و Claude Sonnet 4.5 برای کارهای با حجم بالا غیرقابل اعتماد بودند. DeepSeek پس از تنها ۳ مورد از ۳۸ مورد شکست خورد، احتمالاً به دلیل اتمام بودجه توکنها یا زمان به دلیل خروجیهای طولانی در زنجیره تفکر (Chain-of-Thought).
تنها استثنا Grok 4.20 Reasoning بود که با امتیاز ۰.۹۵ و تأخیر ۸۰ ثانیه موفق شد. با این حال، روند کلی نشان میدهد مدلهایی که به ردپاهای استدلالی متوالی نیاز دارند، برای استفاده پایدار در محیط تولید بیش از حد متغیر هستند. ابزاری که در هر ۴ ورودی یک بار شکست میخورد، بدتر از ابزاری است که کمی دقت کمتری دارد اما همیشه پاسخ میدهد.
سوگیری از نام متغیرها
حتی برترین مدلها از جمله Gemini 3.7 Flash و GPT-5.4 در یک مورد خاص (CMD-004) شکست خوردند. کد filename = user_input; subprocess.run(["cat", filename], check=True) کاملاً امن است چون نه shell وجود دارد و نه پیمایش مسیر. اما پنج مدل از جمله Grok و Haiku و Gemini 2.5 Pro آن را خطرناک تشخیص دادند، صرفاً چون نام متغیر filename بود.
در مقابل، همین مدلها یک فراخوانی خطرناک eval() را نادیده گرفتند (EVAL-004): expression = OPERATIONS[user_input]; result = eval(expression). چون ساختار آن با الگوی استاندارد eval(user_input) متفاوت بود، مدل آن را پاس داد.
این ثابت میکند حتی بهترین مدلها هنوز در حال تطبیق الگو هستند، نه تحلیل واقعی جریان داده. این سوگیری یعنی دستیارهای امنیتی AI هم مستعد «مثبت کاذب» (ایجاد نویز) و هم «منفی کاذب» (باز گذاشتن درها برای نفوذ) هستند.
استراتژیهای اندازهگیری در آینده
برای عبور از تطبیق الگو، پژوهشگر چهار گام بعدی را پیشنهاد میکند:
۱. آزمایش جابجایی نام متغیر: تغییر نام user_input به config_value. اگر مدل دیگر آن را خطرناک تشخیص نداد، سوگیری نام متغیر ثابت میشود.
۲. اندازهگیری کالیبراسیون: درخواست امتیاز اطمینان (Confidence Score). اگر مدلی ۱۵٪ مواقع اشتباه کند اما ادعای «۱۰۰٪ اطمینان» داشته باشد، خطرناک است.
۳. امتیازدهی نرمالشده: بازسازی محک با یک لایه مستقل از پارسر برای استخراج حکم نهایی، فارغ از فرمت JSON یا Markdown.
۴. تریاژ چندمرحلهای: پرسیدن این سوال که «چرا این مورد را خطرناک تشخیص دادی؟». اگر استدلال با حکم در تضاد بود، مدل در حال تطبیق الگو است.
برای مهندسان امنیت، «بهترین» مدل آن نیست که بالاترین امتیاز لیدربورد را دارد، بلکه مدلی است که توازن بین دقت قابل قبول، سرعت و هزینهای را ایجاد کند که اسکن میلیونها خط کد را بدون شکستن بودجه ممکن سازد.
منتظر انتشار نسخه دوم محک تشخیص آسیبپذیریهای امنیتی در Kaggle باشید که شامل ۳۸ قطعه کد با برچسبهای واقعی، کد منبع کامل و دلیل هر مورد است. آن را فورک کنید، موارد خود را اضافه کنید و مدلهایتان را تست کنید تا گفتگوی بهتری درباره امنیت AI آغاز شود.
گام بعدی شما
- اگر از مدلهای گرانقیمت برای اسکن کد استفاده میکنید، مدلهای سبکتر مثل Haiku را در یک محیط کوچک تست کنید تا توازن هزینه و دقت را بسنجید.
- در پرامپتهای خود، از مدل بخواهید «دلیل» شناسایی آسیبپذیری را توضیح دهد؛ اگر دلیل با نتیجه در تضاد بود، مدل در حال تطبیق الگو است نه استدلال.
- برای کاهش نویز، لایهای برای نرمالسازی فرمت خروجی مدلها در خط لوله خود اضافه کنید تا پاسخهای درست به دلیل فرمت غلط رد نشوند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو