اگر صاحب وبسایت هستید، دیگر مجبور نیستید بین دیده شدن در گوگل و تبدیل شدن به غذای رایگان برای مدلهای هوش مصنوعی یکی را انتخاب کنید. کلودفلر (Cloudflare) در ۱۵ سپتامبر ۲۰۲۶ تنظیمات جدیدی را تحت عنوان «عدم اجازه به آموزش هوش مصنوعی» (Disallow AI Training) عرضه کرد که قابلیت کشف سایت در موتورهای جستوجو را از فرآیند آموزش مدلها تفکیک میکند.
سالهاست که وب آزاد بر پایه یک موازنه شکننده پیش میرود. اکثر مالکان سایت برای جذب ترافیک به رباتهای جستوجو نیاز دارند، اما از اینکه محتوایشان برای ساخت مدلهای رقیب استخراج شود، بیزارند. طبق گزارش کلودفلر، این تضاد به دلیل استفاده غولهایی مثل گوگل و مایکروسافت از «خزندههای چندمنظوره» (Mixed-use Crawlers) است؛ رباتهای واحدی که هر دو وظیفه را همزمان انجام میدهند.
تا پیش از این، اگر برای توقف آموزش، ربات را مسدود میکردید، عملاً سایت خود را از فهرست جستوجو حذف میکردید. این انتخاب دوتایی، ناشران را مجبور میکرد تا استخراج دادهها را به عنوان «مالیات» برای دیده شدن بپذیرند. زیرساخت جدید کلودفلر با شناسایی لحظهای هدف از خزش، این پویایی قدرت را تغییر میدهد.
زمینه اقتصادی خزش دادهها
اکثر مالکان سایت میخواهند توسط انسانها، عاملها و رباتهای مفید پیدا شوند. اما بخش بزرگی از اینترنت باز توسط تبلیغات، اشتراکها یا روابط مستقیم با بازدیدکنندگان تامین مالی میشود. این مدلهای کسبوکار تنها زمانی درآمدزایی میکنند که یک انسان واقعاً وارد صفحه شود.
تفاوت شدیدی در نگاه مالکان سایت به جستوجو در برابر آموزش وجود دارد. بر اساس بررسیهای کلودفلر، کمتر از ۱٪ سایتهای کلودفلر انتخاب میکنند که رباتهای جستوجو را مسدود کنند، زیرا جستوجو تقریباً در سطح جهانی مفید تلقی میشود. در مقابل، ۱۷٪ سایتها ترجیح میدهند مکانیزمی را برای مسدود کردن آموزش هوش مصنوعی فعال کنند. این شکاف ثابت میکند که رویکرد کلی «مسدود کردن AI» (Block AI) ناکارآمد است و نیاز به تفکیک دقیقتری است. این چالشها در حالی رخ میدهد که گسترش محتوای تولید شده توسط هوش مصنوعی پیش از این باعث دشواری در یافتن تحلیلهای انسانی در وب شده است.
چرا robots.txt کافی نیست؟
یک دستور ساده در فایل robots.txt بهتنهایی نمیتواند مشکل آموزش را حل کند. هر کسی میتواند یک فایل robots.txt منتشر کند، اما خود این فایل نمیتواند شناسایی کند که چه کسی در حال خزش است یا دلیل خزش او چیست. مهمتر از آن، robots.txt نمیتواند جلوی خزندهای را بگیرد که صرفاً تصمیم میگیرد دستورات را نادیده بگیرد.
به همین دلیل یک راهکار در سطح شبکه (Network-level) لازم است. کلودفلر میتواند ترجیحات را منتشر کند، خزنده را شناسایی کرده، دلیل خزش را طبقهبندی کند و کسانی را که قوانین را نادیده میگیرند، مسدود کند. این اقدامات سپس از طریق Radar گزارش میشوند تا مشخص شود هر اپراتور در عمل چه رفتاری دارد.
استاندارد رباتهای «مسئولپذیر»
کلودفلر تنها به مسدود کردن رباتها بسنده نکرده، بلکه در حال ایجاد یک گواهینامه برای اپراتورهای ربات است. این شرکت عنوان «مسئولپذیر» (Accountable) را برای اپراتورهایی تعریف کرد که به استانداردهای شفافیت و کنترل متعهد شوند. برای کسب این عنوان، یک اپراتور ربات باید شرایط زیر را برآورده کند یا متعهد به اجرای آنها شود:
- مکانیزم انصراف (Opt-out): ایجاد راهی شفاف برای مالکان سایت جهت انصراف از آموزش AI از طریق robots.txt یا استانداردهای مشابه.
- کنترل خلاصهها: مکانیزمی برای انصراف مالکان سایت از حضور در خلاصههای AI که مستقیماً با اپراتور تنظیم شود و تا سال آینده، از طریق کلودفلر قابل مدیریت باشد.
- شفافیت در سطح URL: ارائه معیارها و دیدی جامع درباره اینکه کدام صفحات خاص برای آموزش در دسترس قرار گرفتهاند و محتوا چگونه در جستوجو ظاهر شده است.
- تضمین جستوجو: اطمینان دادن به این نکته که انصراف از آموزش هوش مصنوعی، هیچ تاثیری بر نتایج جستوجوی سنتی یا رتبهبندیها (Rankings) نخواهد داشت.
به نقل از کلودفلر، شرکتهای اپل (Apple)، گوگل (Google) و مایکروسافت (Microsoft) پیش از این صلاحیتهای لازم را کسب کرده یا متعهد شدهاند که در بازه زمانی مشخص این کار را انجام دهند. این یعنی اکنون میتوان به رباتهای آنها دستور داد: «برای جستوجو ایندکس کن، اما آموزش نده» بدون اینکه ترس از جریمه در رتبهبندی وجود داشته باشد.
سازوکار کنترلهای جدید
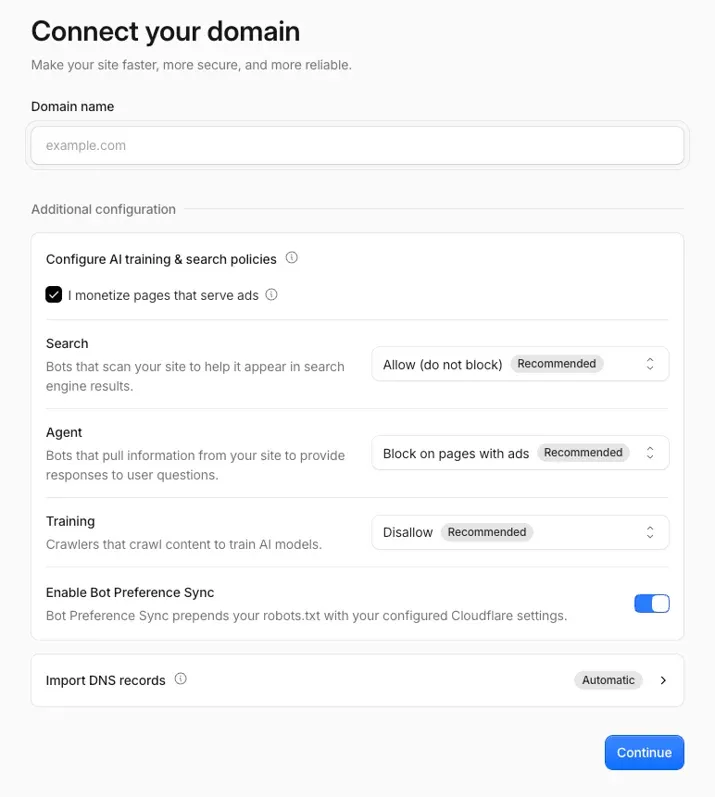
کلودفلر اکنون رفتار رباتها را به سه دسته مجزا تقسیم میکند. چون یک ربات میتواند بیش از یک رفتار داشته باشد، اینها به عنوان کنترلهای جداگانه مدیریت میشوند:
- جستوجو (Search): خزش صرفاً برای ساخت فهرست (Index) موتور جستوجو.
- آموزش (Training): خزش برای آموزش یا تنظیم دقیق (Fine-tuning) — شبیه وقتی به یک پزشک عمومی، تخصص پوست میدهیم تا روی یک حوزه دقیق شود — یک مدل هوش مصنوعی.
- عامل (Agent): عاملهایی که به دستور کاربر به جای انسان از صفحه بازدید میکنند، مانند عاملهای استفاده از مرورگر (browser-use agents) یا رباتهای واکشی چت (chat fetch bots).
این تفکیک اجازه میدهد مدیریت ترافیک بسیار دقیقتر از یک دکمه ساده «مسدود کردن AI» باشد. در این راستا، بهینهسازی نحوه تعامل این عاملها با وب، مانند استفاده از فرمتهای بهینه برای کاهش تأخیر، به بهبود تجربه کاربری کمک میکند. تنظیمات موجود عبارتاند از:
- اجازه (Allow): تمام خزندهها مجاز هستند، مگر اینکه توسط تنظیمات دیگر یا قوانین WAF مسدود شده باشند.
- عدم اجازه به آموزش AI (Disallow AI Training): هسته اصلی بهروزرسانی است. این گزینه از طریق Bot Preference Sync ترجیحات «عدم آموزش» را در robots.txt منتشر میکند. خزندههای مسئولپذیر (Accountable) برای جستوجو مجاز میمانند. اما هر خزنده آموزشی دیگر، از جمله رباتهای آموزشی آمازون (Amazon)، آنتروپیک (Anthropic)، متا (Meta) و اوپنایآی (OpenAI) مسدود میشوند. مسدود کردن اینها تاثیری بر جستوجو ندارد. لازم به ذکر است که این گزینه فقط برای بخش Training در دسترس است و برای Search یا Agent وجود ندارد.
- مسدود کردن در صفحات دارای تبلیغات: خزندهها، از جمله خزندههای چندمنظوره، تنها در صفحاتی که شناسایی شود تبلیغ نمایش میدهند، مسدود میشوند. این لازم است چون ترجیحات مربوط به تبلیغات را نمیتوان در robots.txt بیان کرد؛ چرا که لیست صفحات دارای تبلیغ بسیار بزرگ است و سریع تغییر میکند.
- مسدود کردن (Block): تعطیلی کامل تمام خزندهها، حتی خزندههای چندمنظوره.
چرخش در مدیریت رباتها
این بهروزرسانی رفتار تنظیمات قبلی را به طور بنیادی تغییر میدهد. پیش از این، گزینههای «مسدود کردن» و «مسدود کردن در صفحات دارای تبلیغات» برای خزندههای چندمنظوره اعمال نمیشد تا سئو سایتها به طور تصادفی نابود نشود. اما از ۱۵ سپتامبر ۲۰۲۶، این تنظیمات برای همه، از جمله Applebot، Bingbot و Googlebot اعمال میشود.
اگر میخواهید رتبهبندی جستوجوی خود را حفظ کنید اما آموزش AI را متوقف کنید، باید صراحتاً گزینه «عدم اجازه به آموزش AI» را انتخاب کنید. اگر گزینه «مسدود کردن» (Block) را انتخاب کنید، در واقع تصمیم گرفتهاید که به طور کامل از نتایج جستوجو ناپدید شوید.
مهاجرت و پیادهسازی
کلودفلر در حال حذف تدریجی گزینه «مسدود کردن رباتهای AI» (Block AI Bots) به نفع کنترلهای تفکیکشده Search، Training و Agent است. همچنین Managed Robots.txt جای خود را به Bot Preference Sync میدهد. مشتریانی که Managed Robots.txt را فعال کرده بودند، به سیستم جدید منتقل میشوند.
برای دامنههای موجود که هرگز از کنترلهای تفکیکشده استفاده نمیکردند، مهاجرت بر اساس تنظیمات قدیمی «Block AI» انجام میشود:
- غیرفعال (انتخاب نشده) $
ightarrow$ اجازه به جستوجو، اجازه به آموزش، اجازه به عامل. - مسدود (Block) $
ightarrow$ اجازه به جستوجو، عدم اجازه به آموزش، مسدود کردن در صفحات تبلیغاتی. - مسدود در صفحات تبلیغاتی $
ightarrow$ اجازه به جستوجو، عدم اجازه به آموزش، مسدود کردن در صفحات تبلیغاتی.
برای دامنههایی که از قبل از کنترلهای تفکیکشده استفاده میکردند، انتخابهای قبلی Training در حالت «Block» یا «Block on pages with ads» به «Disallow AI Training» منتقل میشوند.
برای دامنههای جدیدی که بعد از ۱۵ سپتامبر وارد میشوند، کلودفلر دو پیشفرض بر اساس مدل درآمدزایی ارائه میدهد:
- سایتهای غیرتبلیغاتی: جستوجو (Allow)، آموزش (Allow)، عامل (Allow). قابلیت Preference Sync فعال است.
- سایتهای تبلیغاتی: جستوجو (Allow)، آموزش (Disallow AI Training)، عامل (Block on pages with ads). قابلیت Preference Sync فعال است. دلیل این تنظیم این است که آموزش AI جایگزین بازدید انسانی شده و عاملها صفحات را بدون حضور انسانی (که تبلیغات را ببیند) واکشی میکنند.
جزئیات پیادهسازی خزندهها
شرکتهای مختلف از مسیرهای فنی متفاوتی برای این درخواستها استفاده میکنند و سیستم کلودفلر این ترجیحات را در استانداردهای مختلف همگامسازی میکند:
- Applebot: اجازه انصراف از طریق قانون 'Applebot-Extended' در robots.txt را میدهد. مالکان سایت میتوانند از دستور 'nosnippet' در HTML برای خلاصههای AI استفاده کنند یا محتوا را به عنوان «پشت دیوار پرداخت» (paywalled) علامتگذاری کنند تا از خروجیهای مولد حذف شود. اگرچه اپل امروز ابزار بازرسی در سطح URL ندارد، اما راهکاری برای سال آینده برنامهریزی شده است. اپل تایید کرده که عدم اجازه به آموزش، تاثیری بر رتبهبندی جستوجو ندارد.
- Googlebot: از 'Google-Extended' در robots.txt و یک دکمه در پورتال وبمستر برای حذف محتوا از نتایج جستوجوی مولد استفاده میکند. گوگل معیارهایی برای نتایج جستوجو و خلاصههای AI ارائه میدهد و در هفتههای آینده ابزارهای شفافیت بیشتری در سطح URL برای Google-Extended عرضه میکند. گوگل نیز تایید کرده که عدم اجازه به Google-Extended بر رتبهبندی اثر نمیگذارد.
- Bingbot: در حال حاضر به تگ NOARCHIVE و ابزارهای وبمستر متکی است. مایکروسافت در حال ساخت مکانیزمی برای پذیرش ترجیحات «عدم آموزش» در robots.txt در سطح دامنه است که برای اوایل ۲۰۲۷ هدفگذاری شده است. تا آن زمان، گزینه «Disallow AI Training» به طور خودکار ترجیحات را از طریق robots.txt به بینگ منتقل نمیکند. مالکان سایت در حال حاضر میتوانند از ابزار Block URLs یا Content Removal استفاده کنند. مایکروسافت اعلام کرده که استفاده از NOARCHIVE بر رتبهبندی جستوجو اثر نمیگذارد.
نبرد بعدی: خلاصههای AI
آموزش مربوط به «مغز» مدل است، اما خلاصههای AI مربوط به «سفر کاربر» است. کلودفلر اشاره میکند که خلاصهها مشکل اقتصادی متفاوتی ایجاد میکنند: آنها میتوانند تعداد کل بازدیدها را کاهش دهند، اما «قصد» (Intent) کاربرانی را که واقعاً کلیک میکنند، افزایش دهند.
دادهها اثرات متناقضی را نشان میدهند:
- کاهش حجم: بیش از نیمی از مصرفکنندگان خلاصهها را در جستوجو میخوانند و احتمال اینکه این کاربران بعد از خواندن خلاصه، جستوجوی خود را متوقف کنند بیش از ۴۰٪ است.
- افزایش تبدیل: کاربرانی که از طریق جستوجوی AI ارجاع میشوند، نرخ تبدیل ۳ تا بیش از ۵ برابر بیشتری نسبت به ارجاعات جستوجوی سنتی دارند.
هدف کلودفلر برای اوایل سال آینده، دادن کنترل دقیق به مالکان سایت است تا تعیین کنند چه مقدار از محتوایشان در این خلاصهها ظاهر شود. یک پاسخ «بله یا خیر» برای کل سایت بیش از حد ساده است. یک ناشر که با تبلیغات تامین مالی میشود ممکن است برای حجم مخاطب بهینه کند، در حالی که یک خردهفروش بازدیدکنندگان کمتر اما با قصد خرید بالا را ترجیح میدهد. به همین دلیل است که انصراف از خلاصههای AI اکنون یکی از الزامات تبدیل شدن به یک اپراتور «مسئولپذیر» است.
به سوی وب مذاکرهشده
این اقدام نشاندهنده چرخش به سمت یک «وب مذاکرهشده» است. به جای استخراج وحشیانه دادهها در سال ۲۰۲۳، زیرساختها به سمتی میروند که تولیدکنندگان محتوا بتوانند شرایط خدمات (Terms of Service) خاص خود را تعیین کنند و این شرایط در سطح شبکه اجرا شود.
کلودفلر با IETF و سایر نهادهای استاندارد در حال تلاش است تا این اصول را به استانداردهای باز و متقابل تبدیل کند. با تکامل استانداردهایی مانند ai-prefs، کلودفلر رویکرد خود را به کنترلهای Agent بازنگری خواهد کرد، زیرا اینترنت هنوز دستورالعمل تثبیتشدهای برای بیان ترجیحات Disallow به عاملها ندارد.
Cloudflare Radar به ردیابی عمومی کنترلها، شفافیت و گزارشهای ارائه شده توسط اپراتورهای مسئولپذیر ادامه خواهد داد. شما باید فوراً تنظیمات Security در پنل کلودفلر خود را بررسی کنید تا مطمئن شوید سایت شما به طور تصادفی از جستوجو مسدود نشده یا ناخواسته در حال تغذیه نسل بعدی مدلهای LLM است.
گام بعدی شما
- همین حالا تنظیمات Security در پنل کلودفلر خود را بررسی کنید تا مطمئن شوید سایت شما به طور تصادفی از جستوجو مسدود نشده یا ناخواسته در حال تغذیه مدلهای AI است.
- اگر مدل درآمدی شما بر پایه تبلیغات است، گزینه Disallow AI Training را فعال کنید تا از کاهش بازدیدهای انسانی جلوگیری کنید.
- برای سایتهای شرکتی، بررسی کنید که آیا محتوای حساس شما در خلاصههای AI گوگل و بینگ ظاهر میشود یا خیر.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو