تصور کنید تنها با تغییر یک فرمول ریاضی، بتوانید ۱۰۰ ترابایت حافظه رم را در مقیاس جهانی آزاد کنید. در ۱۸ سپتامبر ۲۰۲۶، کلودفلر (Cloudflare) جزئیات فنی این موفقیت را منتشر کرد که حاصل بازنگری در منطق ریاضی پشت سرویس مسیریابی بکاند خود، یعنی Pingora Backend Router (PBR)، است.
در مقیاس هزاران سرور و پتابایتهای حافظه، حتی یک درصد بهبود در بهرهوری، پیروزی بزرگی محسوب میشود. برای کلودفلر، چالش اصلی یک نشت حافظه در کتابخانه متنباز pingora-ketama بود؛ ابزاری که برای هشینگ سازگار (Consistent Hashing) استفاده میشود. این سیستم تضمین میکند که درخواستهای قابل کش (Cacheable) به طور مداوم به یک سرور یکسان مسیریابی شوند تا از ایجاد کپیهای تکراری فایلها در مراکز داده جلوگیری شود.
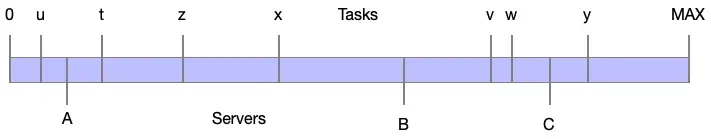
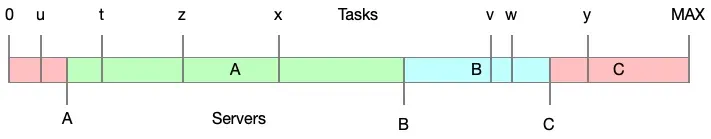
برای درک این مکانیسم، یک خط اعداد را تصور کنید که در آن هم سرورها و هم وظایف (Tasks) به عنوان نقاطی روی آن نگاشته شدهاند. هر وظیفه به اولین سروری که در سمت چپ خود پیدا میکند، اختصاص مییابد. اگرچه این روش ساده است، اما مشکلی ایجاد میکند: چون هشها تصادفی هستند، برخی سرورها به طور طبیعی محدودههای بسیار بزرگتری نسبت به دیگران به دست میآورند. این امر منجر به توزیع نامتوازن بار میشود، به طوری که برخی سرورها دو برابر همتایان خود فشار کاری تحمل میکنند.
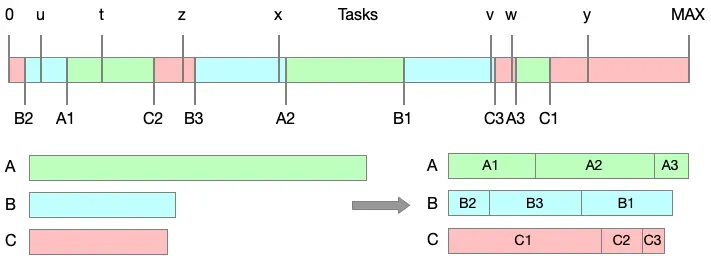
برای حل این مشکل، مهندسان معمولاً «گرههای مجازی» یا هشهای بیشتری برای هر سرور اضافه میکنند. منطق این است که نقاط تصادفی بیشتر در نهایت منجر به توزیعی برابرتر میشود. در سیستمهای NGINX و Pingora، مقدار پیشفرض ۱۶۰ هش برای هر سرور است. اگر سروری فضای دیسک بیشتری داشته باشد، وزن آن افزایش مییابد و در نتیجه هشهای بیشتری به حلقه اضافه میشود تا سهم بیشتری از ترافیک را جذب کند.
انفجار مصرف حافظه
پیچیدگی زمانی زیاد شد که کلودفلر متوجه شد هر سرور نمیتواند هر درخواستی را به دلیل الزامات قانونی (Compliance) یا نیاز به ویژگیهای خاص پردازش کند. برای حل این موضوع، آنها حلقههای هش مجزایی برای ترکیبهای مختلف ویژگیها ساختند. این تصمیم منجر به یک انفجار نمایی در تعداد حلقهها شد، تا جایی که برخی سرویسها تنها برای ذخیره این هشها، تا ۶ گیگابایت رم مصرف میکردند.
تیم فنی ابتدا روی فرمت ذخیرهسازی حمله کرد. در ساختار (Struct) اولیه زبان Rust، از یک عدد صحیح ۳۲ بیتی برای شاخص سرور استفاده شده بود که در مجموع ۸ بایت برای هر نقطه اشغال میکرد. مهندسی به نام زایدون اشاره کرد که چون PBR به ندرت بیش از ۶۵,۰۰۰ سرور را هماهنگ میکند، یک عدد ۱۶ بیتی برای شاخص سرور کاملاً کفایت میکند.
با این حال، قوانین تراز حافظه (Memory Alignment) در Rust باعث میشد حتی با کاهش شاخص به ۱۶ بیت، ساختار برای حفظ تراز با هش ۳۲ بیتی، همچنان ۸ بایت باقی بماند. برای دور زدن این محدودیت سختافزاری، تیم تصمیم گرفت هش و شاخص را به صورت یک آرایه بایت خام ([u8; 6]) ذخیره کند و از متدهای Getter برای دسترسی به دادهها استفاده نماید.
این تغییر به تنهایی مصرف حافظه هشینگ سازگار را ۲۵٪ کاهش داد. اما پیشرفت واقعی زمانی رخ داد که آنها ریاضیات احتمالات را دوباره بررسی کردند.
قانون بازده نزولی هشها
مهندسان کلودفلر فرمول خاصی برای «ضریب تغییرات» (CV) استخراج کردند که حاشیه خطای توزیع بار را اندازهگیری میکند. آنها دریافتند که رابطه بین تعداد هشها و کاهش خطا، به هیچ وجه خطی نیست.
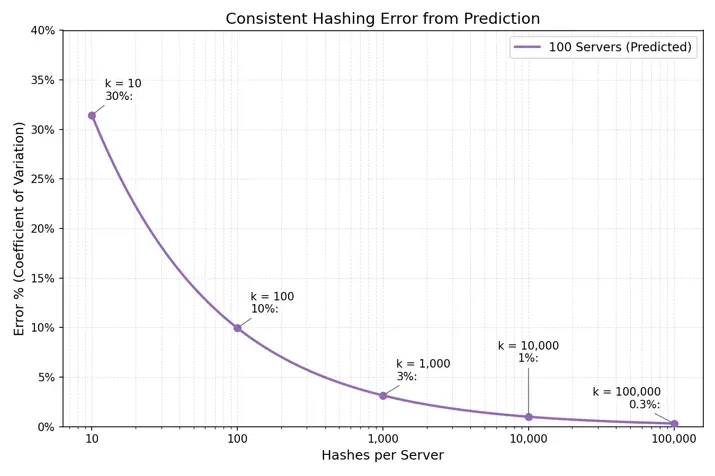
به نقل از تحلیلهای فنی کلودفلر، برای سروری با وزن بالا (مثلاً ۱۰۰,۰۰۰ هش)، ۹۰,۰۰۰ هش آخر تنها ۰.۷٪ در کاهش خطا نقش داشتند. بدتر از آن، آنها دریافتند که تعداد زیاد هشهای ۳۲ بیتی احتمال برخوردها (Collisions) را افزایش میدهد — پدیدهای که به «پارادوکس تولد» معروف است. این برخوردها در واقع خطاهای پیشبینیناپذیری را وارد سیستم میکنند؛ به این معنا که تعداد هشهای بیشتر در نهایت میتواند سیستم را غیردقیقتر کند.
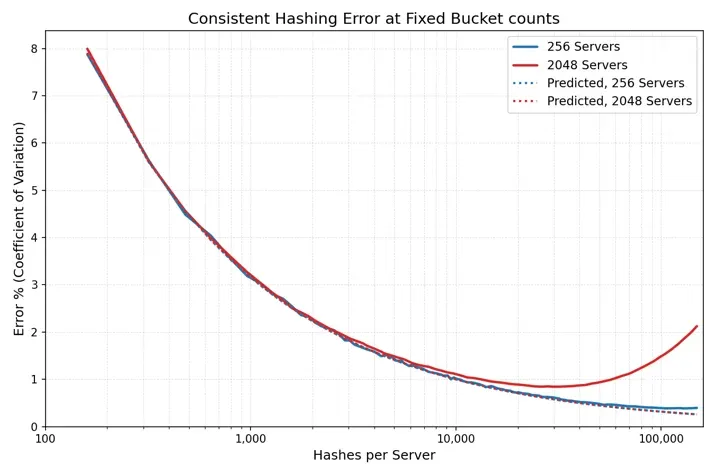
بر اساس این محاسبات ریاضی، کلودفلر تشخیص داد که میتواند تعداد هشهای هر سرور را ۹۰٪ کاهش دهد بدون اینکه هیچ تأثیر محسوسی بر توازن بار بگذارد. این اقدام اندازه حلقههای هش ذخیره شده در حافظه را به شدت کوچک کرد.
مهاجرت بدون سقوط
تغییر یک حلقه هش بسیار خطرناک است چون مسیر مسیریابی درخواستها را تغییر میدهد. یک تغییر ناگهانی و جهانی باعث میشد تقریباً تمام محتوای کششده باطل شود و ترافیک عظیمی به سرورهای مبدأ (Origin) سرازیر شود — که در واقع یک حمله DDoS خودساخته برای زیرساخت شرکت بود.
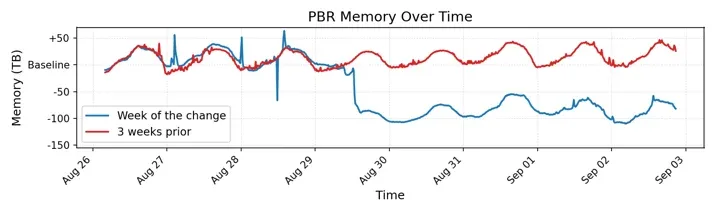
برای جلوگیری از این فاجعه، PBR به طور موقت دو نسخه از لودبالانسر را در حافظه نگه داشت: حلقه قدیمی Ketama و حلقه جدید و کوچکتر. تیم از یک چارچوب مهاجرت (Migration Framework) استفاده کرد تا ترافیک را بر اساس هش درخواستها به تدریج جابهجا کند و استقرار را پایدار سازد.
آنها تغییرات را لایه به لایه اجرا کردند؛ ابتدا در سایتهای اعتبارسنجی کوچک و سپس در مراکز داده بزرگتر. این روش اجازه داد تا ردپای انتخاب بکاند (Backend-selection traces) و ترافیک مبدأ را در لحظه رصد کنند. پس از رسیدن درصد مهاجرت به ۱۰۰٪، حلقههای قدیمی از حافظه حذف شدند.
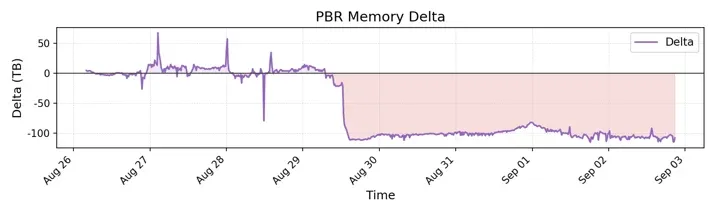
طبق گزارش نهایی کلودفلر، نتیجه این عملیات کاهش شدید مصرف حافظه و بازپسگیری ۱۰۰ ترابایت رم در سطح جهانی بود. این موفقیت پس از تلاش مشابه تیم DNS آنها رخ داد که ماه گذشته ۱۰۰ ترابایت دیگر را آزاد کرده بود.
این بهینهسازی ثابت میکند که پیشفرضهای «استاندارد صنعت» — مانند خط پایه ۱۶۰ هش — اغلب دلخواه و قراردادی هستند. کلودفلر با بهکارگیری حساب دیفرانسیل و ریاضیات در معماری سیستم، یک بحران حافظه را به یک برد عظیم در منابع تبدیل کرد.
برای توسعهدهندگانی که از کریت pingora-ketama استفاده میکنند، این بهبودها اکنون به عنوان یک ویژگی Cargo (که به طور گسترده تبلیغ نشده) در دسترس است تا بتوانند ذخیرهسازی فشرده و تعداد هشهای مقیاسپذیر را در استکهای فنی خود پیاده کنند. در حالی که کلودفلر بر بهینهسازی حافظه سختافزاری تمرکز کرده، در حوزههای نرمافزاری نیز رویکردهای مشابهی برای مدیریت حافظه دیده میشود؛ برای مثال، عاملهای HowiPrompt با بهرهگیری از حافظه معنایی مشترک قادرند خطاهای کد را به صورت خودکار شناسایی و ترمیم کنند.
اگر شما نیز سیستمهای توزیعشده در مقیاس بالا مدیریت میکنید، توصیه میشود ثابتهای «بدیهی» معماری خود را بازبینی کنید. گرانترین اتلاف در زیرساخت شما ممکن است عددی پیشفرض باشد که هرگز دلیل انتخاب آن را زیر سؤال نبردهاید.



گفتگو