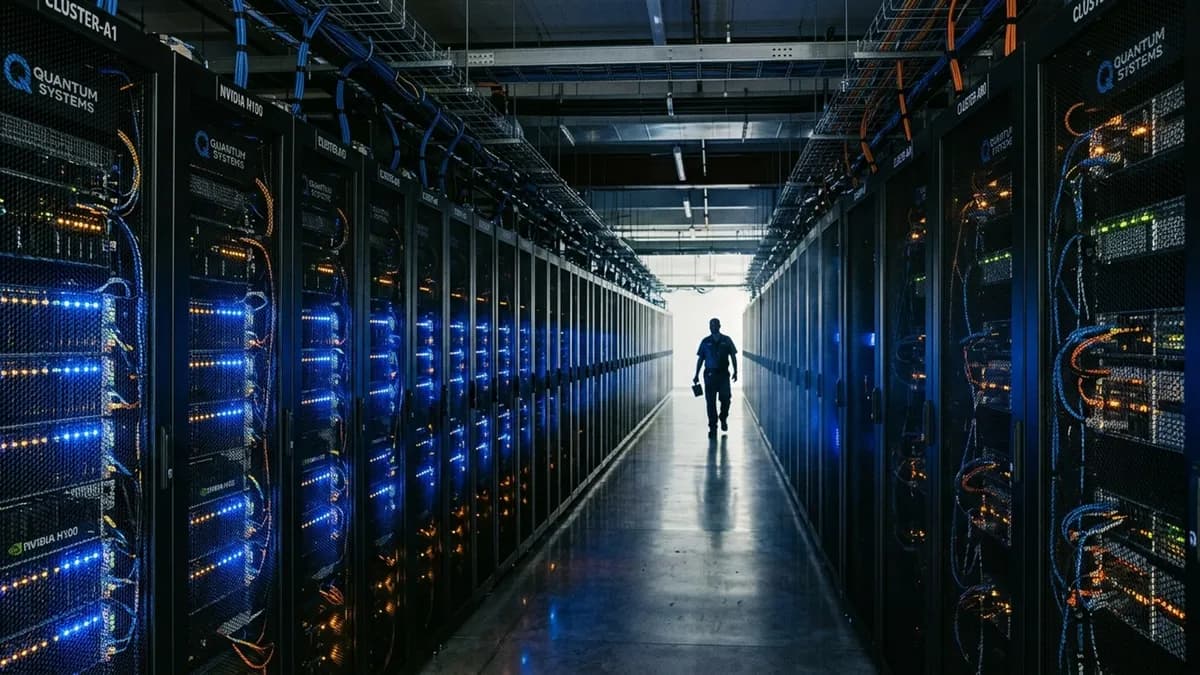
اگر در حال توسعهٔ مدلهای هوش مصنوعی هستید که باید زنجیرهای از ده اقدام پیچیده را بدون وقفه اجرا کنند، هر میلیثانیه تأخیر در دسترسی به داده میتواند کل فرآیند را متوقف کند. CoreWeave با اتصال صدها پردازنده گرافیکی Rubin در یک خوشهٔ واحد، این گلوگاه را برای سیستمهای عاملمحور از بین برد.
به نقل از اعلام رسمی این شرکت در ۱۶ سپتامبر ۲۰۲۶، CoreWeave موفق شد سیستمهای چند-رکی Vera Rubin NVL72 را به صورت یک سرویس ابری قابل اعتماد فعال کند. این دستاورد به معنای تبدیل صدها واحد پردازش گرافیکی (GPU) به یک زیرساخت محاسباتی عظیم است که به جای مجموعهای از سرورهای مجزا، مانند یک موجودیت واحد و یکپارچه عمل میکند. این اولین بار است که یک ارائهدهنده ابر هوش مصنوعی، این معماری را به عنوان یک سرویس ابری قابل اطمینان اعتبارسنجی کرده است تا بنیادی عظیم برای هوش مصنوعی عاملمحور ایجاد کند.
چن گلدبرگ، نایبرئیس اجرایی محصول و مهندسی در CoreWeave، بیان کرد که اتصال صدها GPU روبیین به عنوان یک خوشه مقیاسپذیر واحد، به مشتریانی که در حال ساخت هوش مصنوعی عاملمحور هستند، امکان مقیاس بیشتر، تکرار سریعتر و بهرهوری بالاتر را میدهد؛ چرا که مدلها و عاملها به طور مداوم در حال یادگیری و بهبود هستند.
همانطور که در تحلیلهای قبلی ما دربارهی زیرساختهای محاسباتی مدلهای بنیادی اشاره کردیم، صنعت اکنون از رابطهای سادهٔ چت به سمت هوش مصنوعی عاملمحور (Agentic AI) — سیستمهایی که مثل یک کارمند متخصص، استدلالهای چندمرحلهای انجام داده و از ابزارهای مختلف استفاده میکنند — حرکت کرده است. این رویکرد در حالی توسعه مییابد که برخی تلاش میکنند توان محاسباتی محلی را برای اجرای این عاملها در دسکتاپهای فوقفشرده فراهم کنند تا وابستگی به ابر کاهش یابد. این مدلها به شدت به تأخیر (Latency) در دسترسی به دادهها حساس هستند؛ یک تأخیر کوچک در یک فراخوانی مدل میتواند در زنجیرهای از ده اقدام متوالی انباشته شده و کل عامل را متوقف کند. به همین دلیل CoreWeave کل رکهای سختافزاری را به جای سرورهای پراکنده، یکپارچه کرده است.
جزئیات سختافزاری
هر رک Vera Rubin NVL72 یک نیروگاه متراکم است که بر اساس طراحی نسل سوم MGX ساخته شده است. طبق مستندات انویدیا (NVIDIA)، هر رک شامل موارد زیر است:
- ۷۲ پردازنده گرافیکی Rubin همراه با ۳۶ پردازنده مرکزی Vera.
- ۲۰.۷ ترابایت حافظه HBM4 با پهنای باند ۱,۴۰۰ ترابایت بر ثانیه.
- ۳,۶۰۰ PFLOPS توان محاسباتی برای استنتاج (Inference) در قالب فرمت NVFP4 — لحظهای که مدل واقعاً جواب تولید میکند، شبیه به خودِ آشپزی و نه دورهی آموزش آشپز.
- نسل ششم NVLink با پهنای باند ۲۱۶ ترابایت بر ثانیه.
- ۳۶ پردازنده مرکزی Vera با ۳,۱۶۸ هسته اختصاصی Olympus و تا ۵۴ ترابایت حافظه LPDDR5X.
برای اتصال این رکها، CoreWeave از شبکه اترنت NVIDIA Spectrum-X استفاده میکند. هر GPU روبیین به دو کارت شبکه ConnectX-9 SuperNIC مجهز است که اتصال ۱.۶ ترابیت بر ثانیه را برای ارتباطات مقیاسپذیر (scale-out) از طریق مسیرهای چندصفحهای و چندریلی فراهم میکند. این طراحی ماژولار اجازه میدهد تا تقریباً ۱۲۸,۰۰۰ پردازنده گرافیکی در هر ریل، در یک ساختار بدون مسدودسازی (non-blocking fabric) متصل شوند، بدون اینکه هنگام گسترش شبکه، نیاز به بازطراحی کامل سیستم باشد.
ارکستراسیون خودکار
مدیریت این مقیاس عظیم نیازمند اتوماسیون کامل است. CoreWeave چندین رک را به عنوان یک سیستم واحد از طریق کنترل خودکار چرخه حیات رک، اعتبارسنجی در سطح سیستم و مقیاسبندی شبکه فعال میکند.
CoreWeave از سیستمی به نام Mission Control برای مدیریت چرخه حیات رکها از طریق کنترلکننده Rack LifeCycle استفاده میکند. این اتوماسیون چندین وظیفه حیاتی در مرحله راهاندازی را پوشش میدهد:
- شناسایی سختافزار (Hardware detection)
- بهروزرسانی فریمورها (Firmware updates)
- اعتبارسنجی سیستم (System validation)
- مدیریت توان و خنککننده (Power and cooling management)
ابزاری به نام Racky کنترل سطح رک و ابزار Valvey عملیات خنککننده را مدیریت میکنند. طبق گزارش شرکت، هیچ رکی پیش از گذراندن یک سری تستهای سختگیرانه تشخیص میدانی انویدیا و آزمونهای فشار کاری (workload testing) در سطح کامل رک، وارد مرحله تولید نمیشود. تنها رکهایی که به عنوان یک سیستم کامل این استانداردها را پاس کنند، فعال میشوند.
رفع گلوگاه دادهها
قدرت محاسباتی زمانی بیفایده است که GPUها منتظر دریافت داده باشند. CoreWeave برای حل این مشکل، AI Object Storage را با شتابدهنده LOTA (Local Object Transport Accelerator) معرفی کرد. LOTA با اعمال حافظه پنهان (Caching) مدیریتشده روی هر گنه سرویس کوبرنتیز (Kubernetes) در CoreWeave، سرعت خواندن دادهها را به سطح حافظههای NVMe محلی میرساند و تأخیر را در مقایسه با خوشههای ذخیرهسازی سنتی ۸ برابر کاهش میدهد. این سیستم تا ۷ گیگابایت بر ثانیه پهنای باند برای هر GPU فراهم میکند و با رشد خوشهها، به صورت خطی مقیاس میپذیرد.
برای تیمهای جهانی، قابلیت جدید شتابدهی نوشتن بینمنطقهای (cross-region write acceleration) اضافه شده است. این یعنی نقاط بازرسی (Checkpoints) ابتدا با سرعت و تأخیر محلی در همان منطقه ذخیره شده و سپس در پسزمینه به یک منطقه دوم دورتر منتقل میشوند. از آنجایی که اپلیکیشن تنها یک «باکت» (Bucket) واحد را میبیند، هیچ تغییری در کدنویسی لازم نیست و قوانین دسترسی و نگهداری دادهها، فارغ از مبدأ نوشتن، یکسان باقی میمانند. این ویژگی توقفهای زمان آموزش را به حداقل میرساند و نیاز به جابجایی دستی دادهها بین مناطق را از بین میبرد.
سسیل رابرت-میشون، مدیر زیرساخت داخلی در شرکت Cohere، تأیید کرد که این ساختار یکپارچه باعث میشود زمانبندی آموزش مدلها دیگر تابع تأخیرهای بازیابی داده بینمنطقهای نباشد و بیان کرد: «ذخیرهساز AI Object در CoreWeave به ما یک ردپای دادهای یکپارچه در مناطق مختلف میدهد که خواندن آنها به صورت محلی کش میشود، بنابراین هیچ بخشی از فرآیند منتظر شبکه نمیماند.»
همچنین یک لایه Archive کمهزینه برای ذخیره دادههایی که تیمها معمولاً حذف میکنند اضافه شده است؛ مانند مجموعهدادههای مورد نیاز برای بازتولید یک نتیجه، نسخههای مدل برای مراجعات آینده، یا نقاط بازرسی از اجرای مدلی که تقریباً به نتیجه رسیده بود. این لایه هیچ هزینهای برای بازیابی دادهها، حذف زودهنگام یا خواندن از لایه آرشیو ندارد.
مزیت رقابتی و کاهش هزینهها
این زیرساخت برای کاهش شدید هزینه استدلالهای عمیق طراحی شده است. انویدیا ادعا میکند Vera Rubin NVL72 میتواند مدلهای ترکیب خبرهها (Mixture-of-Experts) — مدلی که شبیه به یک بیمارستان است و هر سؤال را به پزشک متخصص همان حوزه ارجاع میدهد — را تنها با یکچهارم پردازندههای مورد نیاز در نسل قبلی (GB200 NVL72) آموزش دهد.
در بخش استنتاج، هدف کاهش ۱۰ برابری هزینه به ازای هر میلیون توکن (Token) — تکههای کوچکی از متن، شبیه برشهای یک کیک که مدل تکهتکه میخورد — برای هوش مصنوعی عاملمحور است، به طوری که تا ۱۰ برابر توکن بیشتر به ازای هر مگاوات انرژی تولید شود.
CoreWeave با کسب رتبه پلاتینیوم در SemiAnalysis ClusterMAX 1.0 و 2.0، خود را به عنوان جایگزین اصلی ابر-سرویسدهندههای بزرگ (Hyperscalers) معرفی کرده است. این شرکت به نتایج رکوردشکن بنچمارک MLPerf در هر دو بخش استنتاج و آموزش اشاره کرده است. علاوه بر این، بنچمارکهای مستقل توسط Artificial Analysis، شرکت CoreWeave را در رتبه اول سرعت استنتاج و نسبت قیمت به عملکرد برای مدلهای Kimi K2.6 و Kimi K2.7 Code متعلق به Moonshot AI قرار داده است.
در واقع، تغییر بنیادین در اینجا، گذار از ارائه «ماشینهای مجازی» به سمت ارائه «ابرکامپیوتر به عنوان سرویس» (Supercomputer-as-a-Service) است. این تحول در لایه سختافزار با تلاشهایی برای انتقال هوش مصنوعی به هسته سیستمعامل لینوکس همسو است تا مدیریت منابع در سطح پایینتر و بهینهتر صورت گیرد.
باید رصد کرد که این تغییر سختافزاری چگونه بر انتشار مدلهای استدلالی نسل بعد در آزمایشگاههایی مانند Cohere تأثیر میگذارد، چرا که گلوگاه اصلی از توان محاسباتی خام (FLOPs) به بهرهوری شبکه اتصال (Interconnect Fabric) منتقل شده است.
گام بعدی شما
- اگر از مدلهای استدلالی سنگین استفاده میکنید، تأثیر پهنای باند interconnect را در سرعت پاسخدهی مدلهای خود بسنجید.
- برای کاهش هزینه استنتاج در مقیاس بالا، معماریهای مبتنی بر Rubin را در نقشه راه زیرساختی خود قرار دهید.
- بررسی کنید که آیا سیستم ذخیرهسازی فعلی شما گلوگاه سرعت GPUهای شماست یا خیر.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو