اگر تیم مهندسی شما هر هفته ساعتها را صرف اصلاح کدهای استخراج داده میکند، در واقع در حال پرداخت یک «مالیات نگهداری» پنهان هستید. طبق گزارشی که در ۱۵ سپتامبر ۲۰۲۶ در وبسایت dev.to منتشر شد، تیمهای مهندسی بهطور متوسط سالانه ۳۰۰۰ دلار از بهرهوری خود را بهدلیل شکست اسکرپرهای داخلی از دست میدهند.
این مشکل از شکنندگی انتخابگرهای CSS (CSS Selectors) ناشی میشود. برای سالها، توسعهدهندگان برای تحلیل HTML به کتابخانههایی مثل BeautifulSoup و Selenium تکیه کردهاند. این ابزارها برای یادگیری عالی هستند، اما در محیط عملیاتی شبیه به بمبهای ساعتی عمل میکنند؛ کافی است یک وبسایت نام کلاس .product-price را به یک رشته تصادفی مثل ._3xP9z تغییر دهد تا کل خط لوله دادهها متوقف شود و مهندسان مجبور شوند آخر هفتههای خود را صرف عیبیابی درخت DOM کنند.
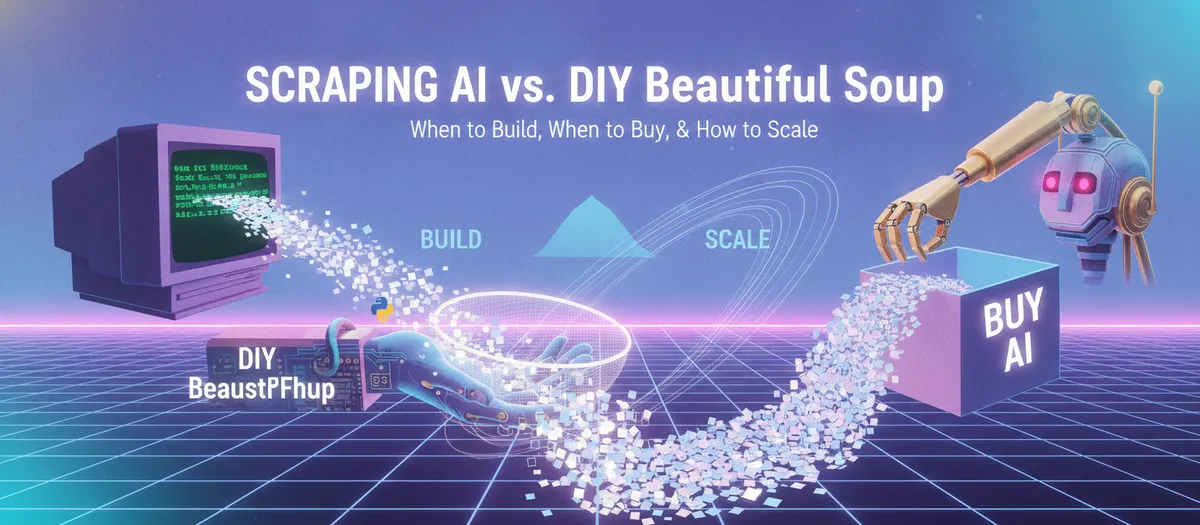
همانطور که در تحلیلهای قبلی ما دربارهی اتوماسیون دادهها اشاره کردیم، وابستگی به ساختارهای سختافزاری یا کدنویسی صلب، بزرگترین نقطه ضعف سیستمهای قدیمی است. در واقع، تضاد میان هزینههای ابزارهای متنباز و سرویسهای مدیریتشده نشان میدهد که سهولت در نگهداری میتواند بر هزینههای اولیه اولویت یابد. برای حل این بحران، شرکت indigodata Inc (زیرمجموعه SMS DataTech Co., Ltd توکیو)، پلتفرم Scraping AI را معرفی کرد. این سرویس بهجای پیمایش دستی DOM، از یک موتور استخراج معنایی مبتنی بر مدل زبانی بزرگ (LLM) — شبیه کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — استفاده میکند. در این روش، هوش مصنوعی بهجای دنبال کردن تگهای HTML، معنای دادهای را که به دنبالش است درک میکند.
بر اساس مستندات این پلتفرم، مزایای فنی این API شامل موارد زیر است:
- حذف انتخابگرهای CSS: استفاده از تطبیق معنایی LLM برای یافتن دادهها، فارغ از تغییرات چیدمان سایت.
- رندرینگ خودکار: بهرهگیری از Chromium بدون رابط گرافیکی (Headless) برای مدیریت برنامههای تکصفحهای (SPA) که بر پایه جاوااسکریپت هستند.
- اعتبارسنجی داخلی: ادغام JSON Schema برای تضمین یکپارچگی دادهها بدون نیاز به نوشتن Regexهای پیچیده.
- بهرهوری: کاهش زمان راهاندازی از چندین ساعت برای هر سایت به یک فراخوانی API که حدود ۶۰ ثانیه زمان میبرد.
مقایسه مالی نشاندهنده تضاد شدیدی است. روشهای سنتی (DIY) معمولاً به ۶۰ ساعت نگهداری سالانه و هزاران دلار هزینه حقوق نیاز دارند. در مقابل، Scraping AI سالانه بین ۶۰ تا ۳۶۰ دلار هزینه توکن دارد و کل زمان راهاندازی آن تنها یک ساعت است. البته باید توجه داشت که استفاده از عاملهای هوش مصنوعی پیشرفتهتر میتواند هزینههای عملیاتی را تا ۵.۷ برابر افزایش دهد، لذا انتخاب ابزار متناسب با بودجه حیاتی است.
توسعهدهندگان برای مهاجرت سیستمهای قدیمی میتوانند از الگوی «قطعکننده» (Circuit Breaker) استفاده کنند. در این رویکرد ترکیبی، ابتدا استخراج با هوش مصنوعی امتحان میشود و تنها در صورت شکست API، سیستم به پارسر قدیمی BeautifulSoup بازمیگردد تا از توقف سرویس جلوگیری شود.
این تغییر، استخراج وب را از یک وظیفه مهندسی شکننده به یک جریان داده مدیریتشده تبدیل میکند. برای کسبوکارهایی که قیمت رقبا را در دهها سایت رصد میکنند، ارزش اصلی در حذف ریسک «شکست خاموش» است. این رویکرد در کنار سایر ابزارهای هوش مصنوعی با بازگشت سرمایه بالا برای سال ۲۰۲۷، میتواند زیرساخت دادهای شرکتها را متحول کند.
البته این ابزار محدودیتهایی هم دارد؛ در حال حاضر استخراج از شبکههای اجتماعی (SNS) را پشتیبانی نمیکند و در برابر دیوارهای ضدبات سختگیرانه مثل Cloudflare، نرخ موفقیت ۸۵ درصدی دارد.
گام بعدی شما
- اگر از BeautifulSoup استفاده میکنید، یک مسیر بحرانی (Critical Path) را شناسایی کرده و با SDK پایتون این ابزار (
pip install scraping-ai) تست کنید. - برای کاهش هزینهها، مدل ترکیبی Circuit Breaker را در خط لولههای داده خود پیادهسازی کنید.
- اعتبار رایگان ۲۰۰ توکنی اولیه را برای سنجش نرخ موفقیت در سایتهای هدف خود به کار ببرید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو