اگر فکر میکنید استخراج متن از یک PDF یعنی اتوماسیون، احتمالاً در تلهای افتادهاید که بسیاری از سازمانهای بزرگ در آن گیر کردهاند. تبدیل متن خام به یک اقدام تجاری واقعی، هنوز هم بزرگترین نقطه شکست در استراتژیهای دیجیتال است. این تنش و چالش در یک تحلیل فنی مورخ ۲۷ سپتامبر ۲۰۲۶ در وبسایت dev.to برجسته شد؛ گزارشی که به طور دقیق توضیح داد چرا تلقی کردن «درک اسناد» و «پردازش هوشمند اسناد» (IDP) به عنوان دو مفهوم مترادف، باعث ایجاد یک شکاف بحرانی در استراتژی اتوماسیون سازمانها میشود.
زمینه و مفهوم تفسیر اسناد
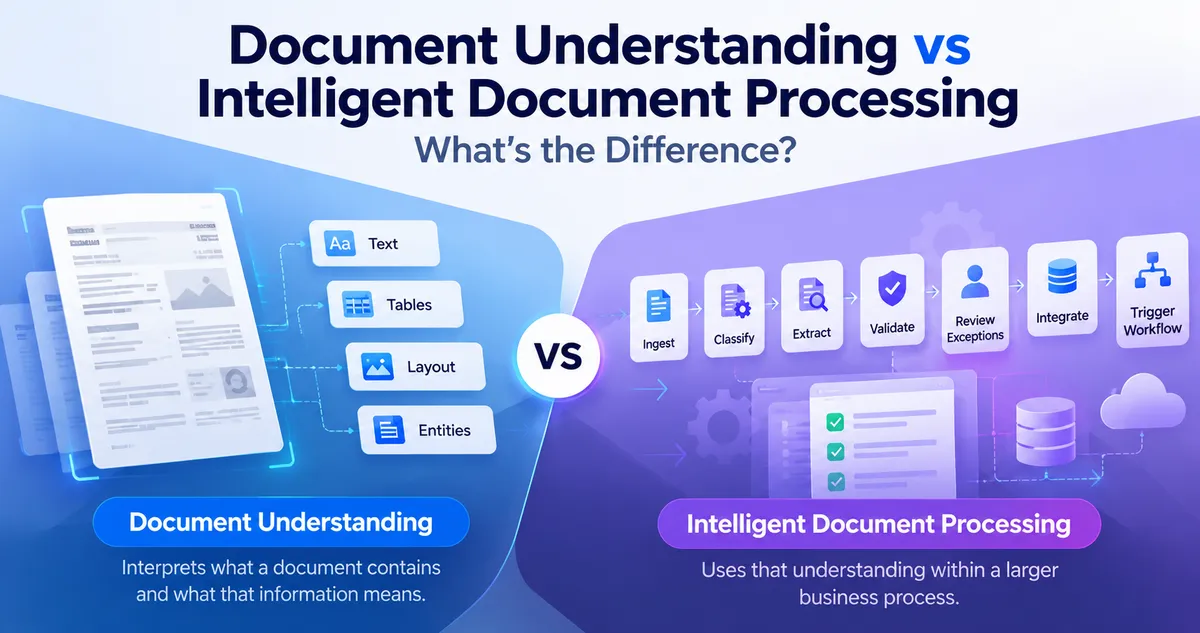
تصور کنید یک صورتحساب بانکی دارید. یک سیستم ساده فقط پیکسلها، کاراکترها، مختصات و عناصر بصری را میبیند؛ اما یک سیستم پیشرفته متوجه میشود که کدام عدد «مانده حساب»، کدام «شماره حساب» و کدام تاریخ «روز تراکنش» است. این دقیقاً تفاوت میان خواندن و فهمیدن است.
خواندن تکتک کلمات و اعداد مفید است، اما سیستم باید تشخیص دهد که یک مقدار خاص نشاندهنده یک برداشت (Debit) است و شرح یک تراکنش به تاریخ و مبلغ مشخصی تعلق دارد. بسیاری از شرکتها توانایی «خواندن» را با توانایی «پردازش» اشتباه میگیرند و در نتیجه، گردش کارهایی ایجاد میکنند که همچنان به مداخلات دستی شدید نیاز دارد.
در واقع درک اسناد (Document Understanding) لایهی هوشمند این فرآیند است. این لایه برای تفسیر ساختار از ترکیبی از نویسهخوانی نوری (OCR)، بینایی ماشین، پردازش زبان طبیعی (NLP)، یادگیری ماشین و تحلیل چیدمان (Layout Analysis) استفاده میکند. مدلهای چندوجهی (Multimodal) مدرن — که همزمان روی اطلاعات متنی و بصری کار میکنند — اکنون رابطهی بین یک مقدار و برچسب آن را در جداول پیچیده حفظ میکنند تا معنای دادهها در ساختارهای سخت از بین نرود. این رویکرد با ضرورت معماریهای چندوجهی برای بقای پشتههای فناوری همسو است که نشان میدهد ادغام دادههای بصری و متنی دیگر یک انتخاب نیست، بلکه یک ضرورت است.
جزئیات فنی پشتهی IDP
اما بر اساس مستندات dev.to، درک سند تنها گام نخست است. یک جریان کامل IDP به لایهی عملیاتی گستردهتری نیاز دارد. درک یک سند تنها بخشی از نیاز سازمان است؛ یک سند ممکن است نیاز داشته باشد که ابتدا شناسایی شود، سپس خوانده شود، تفسیر گردد، اعتبارسنجی شود، با سایر اطلاعات مقایسه شود و در نهایت در صورتی که چیزی اشتباه به نظر برسد، مورد بازبینی قرار گیرد.
این فرآیند از یک توالی مشخص و مهندسیشده پیروی میکند:
- دریافت و طبقهبندی (Ingest & Classify): شناسایی نوع سند و مدیریت ورود اولیه دادهها به سیستم. در این مرحله، ابزارهایی برای تبدیل اسناد نامنظم به دادههای ساختاریافته حیاتی هستند، مشابه آنچه ابزار Docling شرکت IBM برای پاکسازی PDFهای پیچیده ارائه میدهد.
- درک و استخراج (Understand & Extract): استفاده از هوش مصنوعی برای بیرون کشیدن موجودیتهای خاص (Entities)، شناسایی فیلدها و درک بخشهای مختلف سند.
- اعتبارسنجی و بازبینی (Validate & Review): بررسی دادههای استخراجشده بر اساس قوانین تجاری یا مقایسه با سایر سیستمها و ارجاع فیلدهایی که سطح اطمینان (Confidence) پایینی دارند به اپراتور انسانی.
- یکپارچهسازی و اجرا (Integrate & Trigger): انتقال دادههای تاییدشده به نرمافزارهای سازمانی برای شروع یک گردش کار در مراحل پاییندست.
این هماهنگسازی (Orchestration) است که IDP را تعریف میکند. یک سامانه ممکن است در درک یک فاکتور پیچیده درجه یک باشد، اما اگر نتواند آن فاکتور را با یک سفارش خرید (Purchase Order) تطبیق دهد یا در سیستم ERP پرداخت را فعال کند، یک راهکار IDP نیست. اتوماسیون سرتاسری نیازمند هر دو رکن «هوش» و «هماهنگسازی» است.
نقش انسان در چرخه (Human-in-the-Loop)
در این معماری، حضور انسان همچنان یک جزء اجباری است. اسناد اغلب با کیفیت اسکن پایین، دستنویس، دارای اطلاعات ناقص، مقادیر مبهم یا تناقض با سایر سوابق میرسند.
IDP جایگزین انسان نمیشود، بلکه نقش او را از «تایپیست داده» به «مدیر استثنائات» تغییر میدهد. به جای فشار دادن اطلاعات نامطمئن در یک جریان خودکار که منجر به خطاهای سیستمی میشود، IDP موارد استثنایی را برای تایید به یک شخص ارجاع میدهد تا اطمینان حاصل شود که قضاوت انسانی تنها در جایی که واقعاً مورد نیاز است، اعمال میشود.
تاثیر هوش مصنوعی مولد
ورود مدلهای زبانی بزرگ (LLM) و هوش مصنوعی محاورهای لایهی جدیدی به این پشته اضافه کرده است. اگرچه LLMها خلاصهسازی یا پرسوجو از مجموعهای از اسناد را با استفاده از زبان طبیعی ساده میکنند، اما آنها همچنان به کیفیت لایهی زیرین یعنی «درک اسناد» وابسته هستند.
سیستم همچنان باید بتواند سند درست را شناسایی کند، بافتار (Context) را حفظ کند و پاسخ را به منبع اطلاعاتی قابلاعتماد متصل نماید. هوش مصنوعی محاورهای IDP را بیرنگ و بیاثر نمیکند، بلکه لایهای را به قابلیتهایی اضافه میکند که IDP پیش از آن ممکن ساخته بود.
برای کسی که این سیستمها را پیاده میکند، معنای این حرف ساده است: «هماهنگسازی» گردش کار از «هوش» مدل مهمتر است. شما نمیتوانید گلوگاههای فرآیندی را صرفاً با ارتقای مدل استخراج حل کنید، در حالی که لایههای اعتبارسنجی و یکپارچهسازی شما هنوز صلب یا دستی هستند.
در نهایت، درک اسناد معنای محتوا را میسازد، اما IDP آن معنا را به کار میگیرد. گذار از اولی به دومی، یعنی تبدیل یک ابزار «تولید داده» به یک سامانه «اجرای فرآیند تجاری».
گام بعدی شما
- بررسی کنید آیا در سازمان شما دادههای استخراجشده توسط AI مستقیماً به یک اکشن (Action) متصل میشوند یا هنوز نیاز به کپی-پیست انسانی دارند.
- لایهی اعتبارسنجی (Validation) خود را پیش از ارتقای مدل استخراج، بازبینی کنید.
- برای موارد با اطمینان پایین (Low-confidence)، یک گردش کار بازبینی انسانی (Human-in-the-loop) طراحی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو