اگر امروز برای پردازش حجم عظیمی از دادهها روی CPU تکیه میکنید، گلوگاه اصلی شما احتمالاً عملیات مرتبسازی است. گوگل با معرفی یک پیادهسازی جدید، این سد عملکردی را با جهشی ۱۹ برابری در برابر std::sort کتابخانه استاندارد C++ شکست. این کد که در تاریخ ۱۶ سپتامبر ۲۰۲۶ منتشر شد، با بهرهگیری از SIMD (یک دستورالعمل، چندین داده) به سرعتهای رکوردشکن دست یافته است. این فناوری به پردازنده اجازه میدهد تا چندین عنصر از یک آرایه عددی را بهطور همزمان پردازش کند.
مرتبسازی یکی از بلوکهای سازنده و بنیادی برای پرسوجوهای SQL است. این موضوع بهویژه در پایگاههای داده ستونی (Columnar Databases) مدرن که مقادیر را بهصورت متوالی ذخیره میکنند، اهمیت حیاتی دارد. در این ساختار، فیلتر کردن یا مرتبسازی دادهها بسیار سریعتر از ذخیرهسازی سنتی مبتنی بر سطر است؛ جایی که تمام فیلدهای یک رکورد پیش از شروع رکورد بعدی در کنار هم ذخیره میشوند.
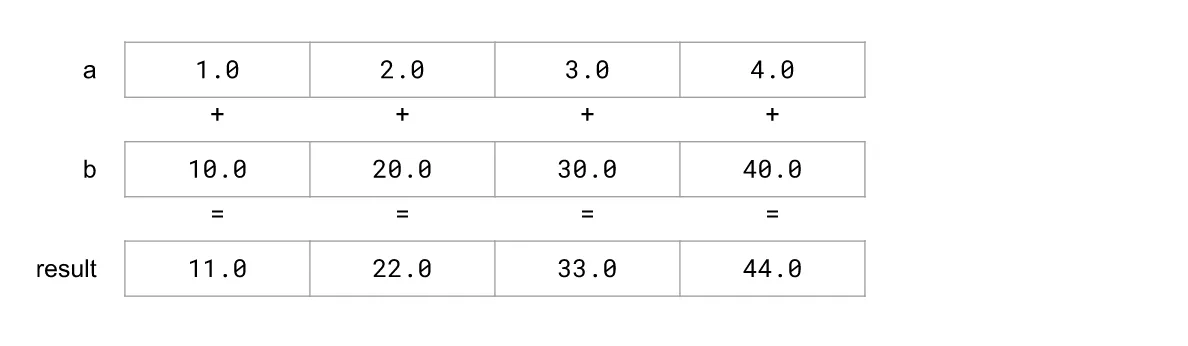
اگرچه حوزه مرتبسازی یک زمینه بالغ است، اما اکثر کتابخانههای استاندارد از دستورالعملهای برداری (Vector Instructions) موجود در CPUهای مدرن بهطور کامل استفاده نمیکنند. SIMD به CPU اجازه میدهد تا روی چندین عنصر مستقل در یک دستورالعمل واحد عملیات انجام دهد. برای مثال، با استفاده از AVX-512 میتوان ۱۶ مقدار float32 یا با استفاده از Arm NEON چهار مقدار را بهطور همزمان پردازش کرد. این شکاف تکنولوژیک، فرصتی عظیم برای افزایش عملکرد در برنامههایی با حجم داده بالا ایجاد کرده است.
طبق گزارش وبلاگ مهندسی گوگل، این افزایش سرعت از بهینهسازی مرحله افراز (Partitioning) در الگوریتم Quicksort حاصل شده است. تیم توسعهدهنده از کتابخانه Highway برای پیادهسازی توابع SIMD قابلحمل در شش مجموعه دستورالعمل مختلف استفاده کرد. این رویکرد باعث شد تا نیاز به بازنویسی حدود ۳۰۰۰ خط کد C++ برای هر پلتفرم حذف شود.
بنچمارکهای فنی
- پشتیبانی سختافزاری: این کد روی معماریهای Arm NEON، Arm SVE، RISC-V V و x86 AVX-2/AVX-512 قابل اجرا است.
- نرخ انتقال داده (Apple M1): برای مرتبسازی یک میلیون عدد، خروجی با سرعتهای ۴۹۹ مگابایت بر ثانیه (۳۲ بیتی)، ۴۷۱ مگابایت بر ثانیه (۶۴ بیتی) و ۴۶۶ مگابایت بر ثانیه (۱۲۸ بیتی) تولید میشود.
- نرخ انتقال داده (3 GHz Skylake): با استفاده از AVX-512، سرعت برای اعداد ۳۲ بیتی به ۱۱۲۳ مگابایت بر ثانیه، برای ۶۴ بیتی به ۱۱۱۹ مگابایت بر ثانیه و برای ۱۲۸ بیتی به ۱۱۲۰ مگابایت بر ثانیه میرسد.
- مقایسه: روی همین سختافزار، کتابخانه استاندارد بسته به نوع عدد، تنها بین ۵۸ تا ۱۲۸ مگابایت بر ثانیه سرعت دارد.
- عملکرد AVX2: این پیادهسازی به سرعت ۷۹۸ مگابایت بر ثانیه میرسد که از پیشرفتهترین مرتبساز بهینهشده برای AVX2 (با سرعت ۶۹۹ مگابایت بر ثانیه) سریعتر است.
- تطبیقپذیری: برخلاف مرتبسازهای پیشین که محدود به اعداد صحیح ۳۲ بیتی بودند، این نسخه از طیف کامل ورودیهای ۱۶ بیتی تا ۱۲۸ بیتی پشتیبانی میکند.
جزئیات پیادهسازی
- منطق Quicksort: این الگوریتم آرایهها را بر اساس یک مقدار محوری (Pivot) که در حالت ایدهآل میانه است، به زیرآرایهها تقسیم میکند و این فرایند را بهصورت بازگشتی تکرار میکند تا زمانی که زیرآرایهها به ۲۵۶ عنصر یا کمتر برسند.
- مورد ۲۵۶ عنصر: برای این آرایههای کوچک، یک روش مرتبسازی ویژه به کار گرفته شده تا کارایی به حداکثر برسد.
- Compress-Store: مکانیسم اصلی بر پایه دستورالعمل "فشردهسازی-ذخیره" است. این قابلیت به CPU اجازه میدهد تنها عناصری را که شرط خاصی دارند (مثلاً کوچکتر از مقدار محوری باشند) بهصورت متوالی در حافظه ذخیره کند.
- شبیهسازی: برای معماریهایی که فاقد این دستورالعمل خاص هستند (مانند AVX2)، این پیادهسازی رفتار مذکور را با استفاده از دستورالعملهای جایگشت (Permute) شبیهسازی میکند.
- بهینهسازی خودکار: کتابخانه Highway در زمان اجرا دستورالعملهای موجود در CPU را بررسی کرده و بهترین گزینه را انتخاب میکند. مشخص شده است که AVX-512 بدون هیچ تلاش اضافی از سوی توسعهدهنده، ۱.۴ تا ۱.۶ برابر سریعتر از AVX2 است.
این تغییر، فرض بنیادی مبنی بر اینکه مرتبسازی یک عملیات بسیار هزینهبر برای CPU است را تغییر میدهد. با رسیدن به آستانه ۱ گیگابایت بر ثانیه در یک هسته واحد، توسعهدهندگان اکنون میتوانند فیلترهای پیچیدهتر و مرتبسازیهای بلادرنگ را در موتورهای پایگاه داده پیاده کنند بدون اینکه با دیوار محدودیت عملکرد مواجه شوند.
برای یک توسعهدهنده معمولی، این به معنای آن است که پردازش داده با کارایی بالا دیگر نیازمند نوشتن کدهای اسمبلی خاص برای هر معماری نیست. استفاده از Highway تضمین میکند که همان کد C++ بهطور خودکار سریعترین مجموعه دستورالعمل موجود در ماشین کاربر را انتخاب کند.
توسعهدهندگان اکنون میتوانند این کد را که تحت لایسنس Apache2 در گیتهاب منتشر شده است، برای شتاببخشی به خطوط لوله داده (Data Pipelines) خود ادغام کنند. گام بعدی برای جامعه برنامهنویسان، بررسی این موضوع خواهد بود که چگونه این نرخ انتقال داده، انواع جدیدی از پرسوجوهای تحلیلی بلادرنگ را در ذخیرهسازهای ستونی ممکن میسازد.



گفتگو