اگر امروز برای هر درخواست بازبینی کد (Code Review) هزینه پرداخت میکنید، احتمالاً بخش بزرگی از بودجه شما صرف مدلهایی میشود که برای کارهای ساده بیش از حد گران هستند. تفاوت هزینه بین دو مدل پیشرو در این حوزه اکنون به ۲۸ برابر رسیده است. هزینه یک بازبینی کد با استفاده از مدل GPT-5.6 Luna تنها ۰.۰۰۴۱ دلار است، در حالی که همین بازبینی از طریق GPT-6 Astra مبلغ ۰.۱۱۳ دلار هزینه دارد. این اختلاف قیمت شدید، ضرورت استفاده از مدلهای پرچمدار برای توسعههای روزمره را به چالش میکشد. این مدل پرچمدار که معماری آن بر پایه جایگزینی فشردهسازی با حافظه پویا طراحی شده است، استانداردهای جدیدی را برای دقت در وظایف پیچیده تعریف کرده است.
طبق گزارش ۱۴ سپتامبر ۲۰۲۶ از entelligence.ai، مدل ارزانتر در شناسایی باگهای رایج عملکردی «به اندازه کافی خوب» است، اما در مواجهه با منطقهای حساس امنیتی بهطور خطرناکی شکست میخورد.
این یافتهها در حالی منتشر میشود که تیمهای توسعه برای ایجاد تعادل بین هزینه گردشکارهای مبتنی بر هوش مصنوعی و دقت خروجیها در تکاپو هستند. همانطور که در تحلیل قبلی ما دربارهی استفاده از دانشآموزان دبیرستانی از Claude و GPT-5 برای حل مسائل پیچیده ریاضی اشاره کردیم، صنعت اکنون از پرسش «آیا هوش مصنوعی میتواند این کار را انجام دهد؟» به سمت «کدام مدل برای این وظیفه خاص بهصرفهترین است؟» حرکت کرده است. برای اکثر توسعهدهندگان، این تفاوت بین ابزاری است که یک بارِ مالی سنگین است و ابزاری که میتوان آن را روی تکتک درخواستهای ادغام کد (Pull Request) بدون نگرانی از بودجه اجرا کرد.
شکاف هزینه و عملکرد
شرکت Entelligence هر دو مدل را روی ۵۰ نمونه بازبینی کد از سازمان AI-Code-Review-Evals آزمایش کرد. این نمونهها شامل ۱۰ مورد از هر یک از پروژههای Sentry، Discourse، Grafana، Cal.com و Keycloak بود که هر کدام نقصهای خاصی را در یک شاخه پاک (Clean Base Branch) ایجاد کرده بودند.
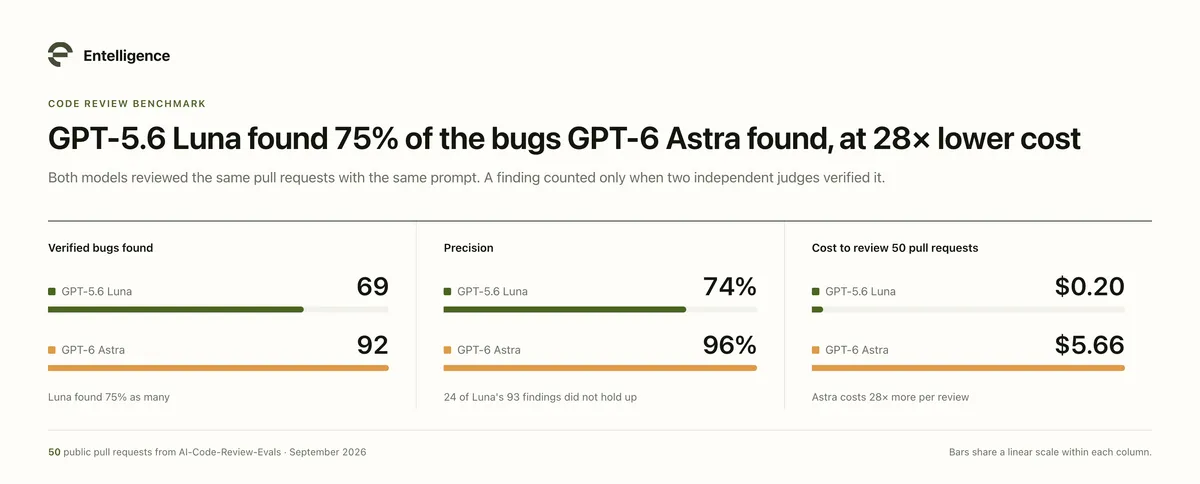
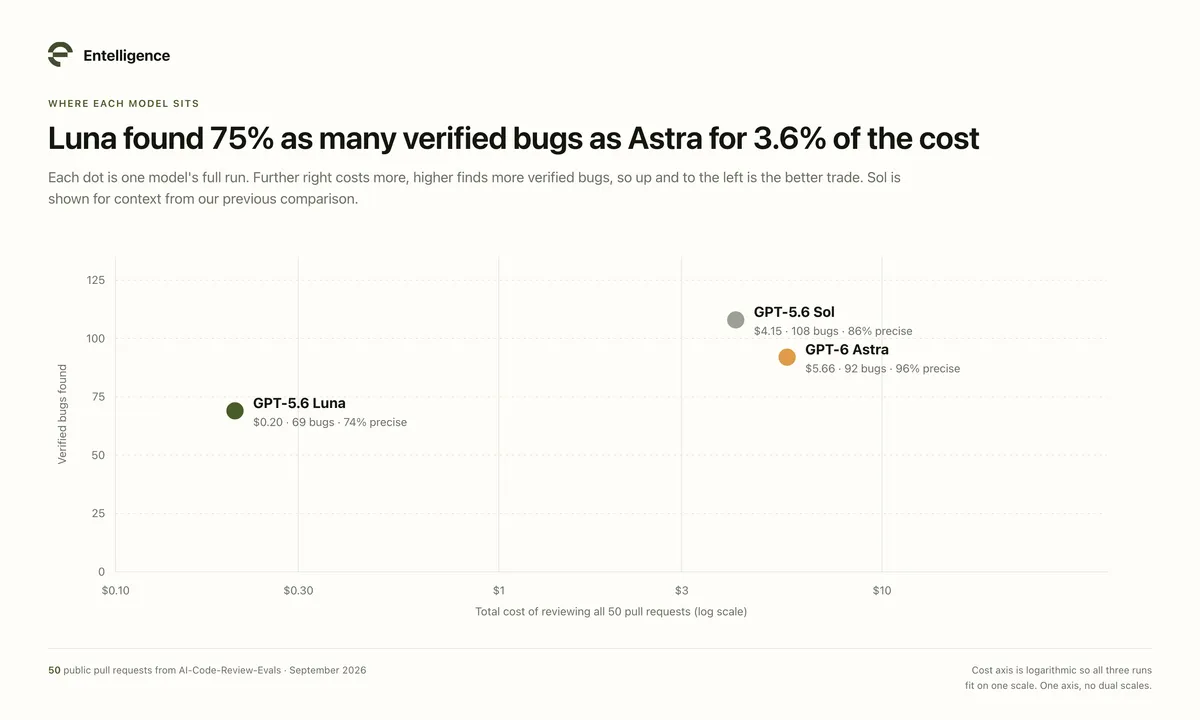
قیمتگذاری Luna بسیار تهاجمی است: ۰.۲۰ دلار بهازای هر میلیون توکن ورودی و ۱.۲۰ دلار بهازای هر میلیون توکن خروجی. در مقابل، Astra برای ورودی ۱۰ دلار و برای خروجی ۵۰ دلار هزینه میگیرد. در اجرای این ۵۰ مورد، هزینه کل Luna تنها ۰.۲۰ دلار بود، در حالی که Astra مبلغ ۵.۶۶ دلار هزینه داشت.
با وجود این اختلاف قیمت، عملکرد Luna بهطور غافلگیرکنندهای مقاوم بود. این مدل ۶۹ باگ تأییدشده را یافت، در حالی که Astra به ۹۲ مورد رسید. این یعنی Luna توانست ۷۵٪ از باگهایی را که مدل پرچمدار یافت، شناسایی کند، در حالی که تنها ۳.۶٪ از هزینه آن را مصرف کرد. به عبارت دیگر، هزینه هر باگ تأییدشده در Astra حدود ۲۰ برابر بیشتر از Luna بود (۰.۰۶۱ دلار در برابر ۰.۰۰۳۰ دلار).
دقت و نویز
جایی که صرفهجویی در هزینه تمام میشود، «نویز» آغاز میشود. دقت (Precision) مدل Luna روی ۷۴٪ بود؛ یعنی تقریباً یکی از هر چهار نظر این مدل اشتباه بود. Astra بسیار جراحگونهتر عمل کرد و نرخ دقت ۹۶٪ را ثبت کرد (تنها ۴ خطا در ۹۶ یافته).
خروجی Luna ممکن است برای توسعهدهندگان کلافهکننده باشد. چون Luna در هر بازبینی ۳.۱ برابر بیشتر از Astra توکن تولید کرد (۲۱۰۴ در برابر ۶۸۸)، متن بیشتری نوشت اما نرخ خطای آن بالاتر بود. این موضوع ریسکی را ایجاد میکند که برنامهنویسان بهدلیل حجم بالای مثبتهای کاذب، پیشنهادهای هوش مصنوعی را بهطور کلی نادیده بگیرند یا سریعاً از روی آنها رد شوند. با این حال، Luna سریعتر بود و بهطور متوسط ۲۳ ثانیه زمان برد، در حالی که Astra ۳۶ ثانیه زمان نیاز داشت.
نقطه کور امنیتی
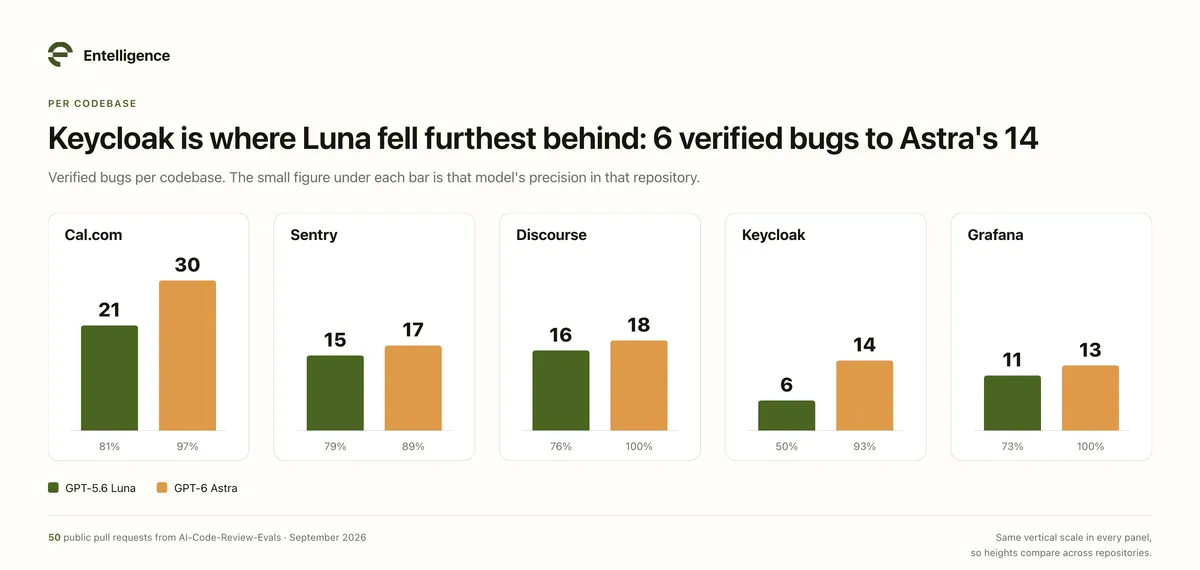
بحرانیترین شکست Luna در کدهای حساس امنیتی رخ داد. در محک Keycloak — که یک سرور مدیریت هویت و دسترسی است — Luna تنها ۶ باگ تأییدشده یافت، در حالی که Astra به ۱۴ مورد رسید. تنها ۵۰٪ از یافتههای Luna در Keycloak درست بودند، در حالی که این رقم برای Astra به ۹۳٪ میرسید.
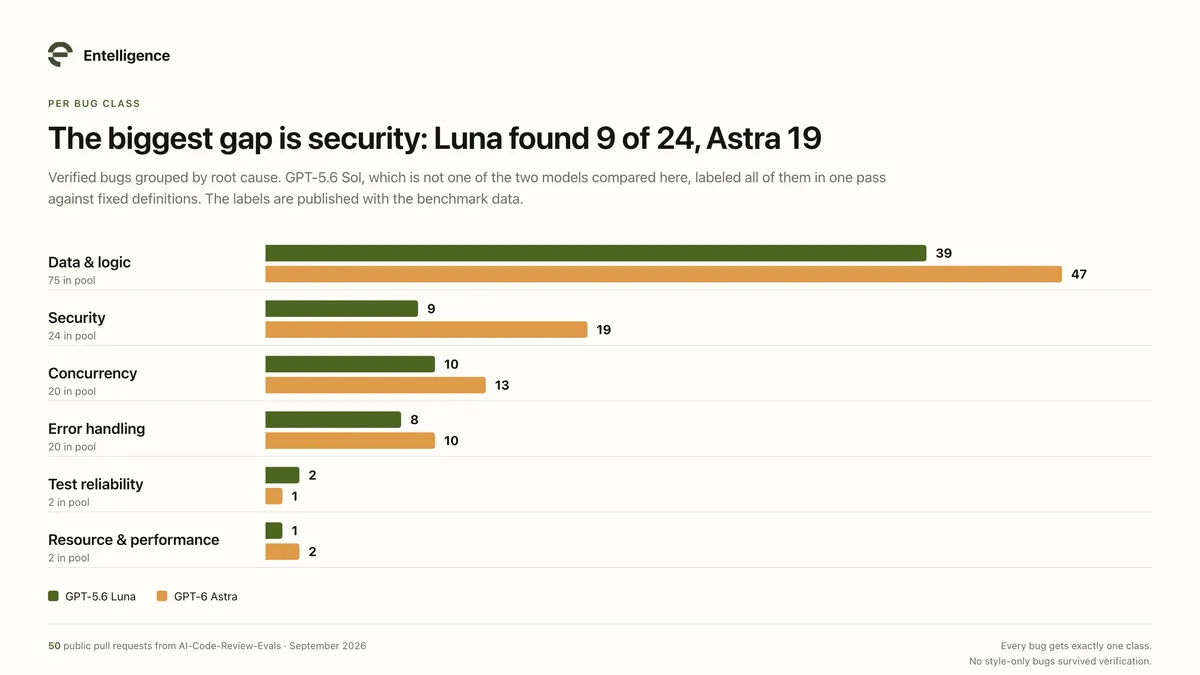
در کل مجموعه داده، Luna تنها ۹ مورد از ۲۴ باگ امنیتی را شناسایی کرد، در حالی که Astra ۱۹ مورد را یافت. باگهای از دست رفته خطاهای ساده تکخطی نبودند، بلکه به مدلهای پیچیده دسترسی مربوط میشدند. دو مثال مشخص که Astra یافت و Luna نادیده گرفت عبارتند از:
- کدهای بازیابی فدرال (Federated recovery codes): این کدها هرگز بهعنوان «استفادهشده» علامتگذاری نمیشدند و اجازه میدادند یک کد بازیابی چندین بار استفاده شود.
- مجوزهای نمای کلی (Global view permissions): یک مجوز کلی، محدودیتهای تعریفشده برای کلاینتهای فردی را لغو میکرد.
هیچکدام از این خطاها در یک خط کد واضح نیستند. شناسایی آنها مستلزم این است که مدل درک کند مدل دسترسی پس از اعمال تغییرات، چه اجازه میدهد و چه نمیدهد.
تحلیل تفکیکی عملکرد
برای درک نقاط ضعف Luna، نتایج بر اساس کدبیس و نوع باگ تفکیک شدند. در حالی که Luna در Sentry، Discourse و Grafana تقریباً همتراز با Astra بود (اختلاف آنها تنها دو باگ تأییدشده بود)، شکاف در Cal.com (۲۱ در برابر ۳۰) بیشتر شد و در Keycloak به اوج رسید.
تحلیل کلاس باگها:
- باگهای داده و منطق: بزرگترین گروه؛ Luna تعداد ۳۹ و Astra تعداد ۴۷ مورد را یافت.
- باگهای همزمانی (Concurrency): Luna تعداد ۱۰ و Astra تعداد ۱۳ مورد را یافت.
- باگهای امنیتی: Luna تعداد ۹ و Astra تعداد ۱۹ مورد را یافت.
زمینه برچسبگذاری باگها
برای اطمینان از دقت دستهبندیها، مدل GPT-5.6 Sol تمام ۱۴۳ باگ تأییدشده را در یک مرحله بر اساس تعاریف مکتوب برچسبگذاری کرد. این برچسبها در کنار دادههای بنچمارک برای تأیید عمومی ثبت شدهاند. این رویکرد ساختاریافته به تیمها اجازه میدهد دقیقاً ببینند استدلال یک مدل اقتصادی در کجا متوقف میشود.
پیروزیهای غیرمنتظره مدل اقتصادی
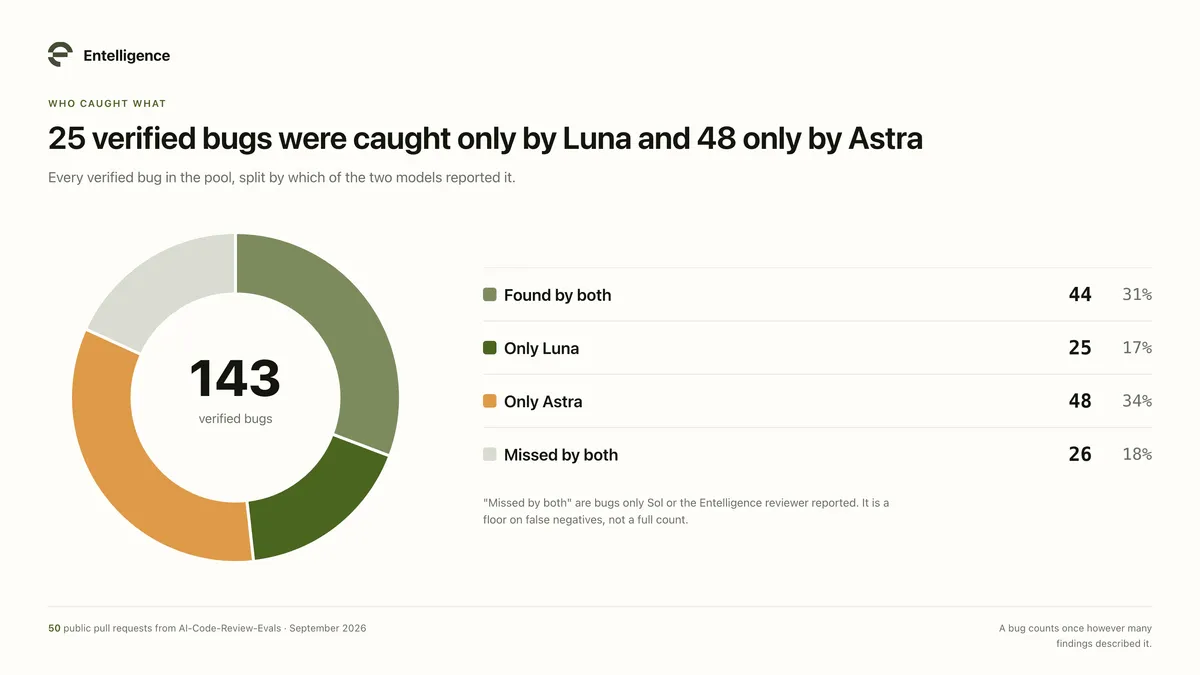
جالب است که Luna صرفاً نسخه ضعیفتری از Astra نیست؛ بلکه باگهایی را یافت که مدل پرچمدار نادیده گرفته بود. از ۱۴۳ باگ تأییدشده در کل مجموعه، ۲۵ مورد فقط توسط Luna شناسایی شدند.
این یافتههای «اختصاصی Luna» عمدتاً باگهای داده و منطق (۱۶ مورد) و همزمانی (۴ مورد) بودند. برای مثال در Discourse، مدل Luna باگی را شناسایی کرد که در آن تکرار درخواست لغو عضویت، سطح اعلانهای کاربر را بهاشتباه کاهش میداد. در Sentry، این مدل یک باگ همزمانی را یافت که در آن رشتههای کاری (Worker Threads) ناسالم بدون متوقف کردن رشتههای قدیمی، جایگزین میشدند.
متدولوژی و محدودیتها
به نقل از مستندات Entelligence، برای تضمین صحت، از یک سامانه داور دوگانه استفاده شد. یافتههای Luna، Astra و GPT-5.6 Sol تجمیع شده و بهطور جداگانه توسط Astra و Sol داوری شدند. یک باگ تنها زمانی «تأییدشده» محسوب میشد که هر دو داور بر واقعی بودن آن توافق کنند. داوران در ۹۱٪ موارد توافق داشتند و ۱۴۳ باگ متمایز از این فیلتر عبور کردند.
وقتی یافتههای Luna به مجموعه اضافه شد، داوران دوباره ارزیابی کردند. تعداد باگهای تأییدشده Astra از ۹۱ به ۹۲ و Sol از ۱۰۷ به ۱۰۸ رسید. Astra هم بهعنوان شرکتکننده و هم بهعنوان داور عمل کرد که ممکن بود باعث سوگیری شود، اما نیاز به توافق Sol این اثر را کاهش داد.
پاسخ به دغدغههای احتمالی
- نشت دادههای آموزشی: برخی پرسیدند آیا مدلها صرفاً اصلاحات را به خاطر داشتند؟ تاریخ PRها از سال ۲۰۱۳ تا ۲۵ ژوئیه ۲۰۲۵ است. چون نقصها بهطور خاص برای این محک ایجاد شده بودند، باگهای دقیق در دادههای آموزشی نبودند، هرچند کد عمومی اطراف آنها موجود بود. ایجاد گروهی از PRها که بعد از تاریخ قطع آموزش مدلها باشند غیرممکن بود زیرا هیچ PRی بعد از تاریخ آموزش مدلها وجود نداشت.
- ثبات: در اجراهای تکراری روی ۱۰ مورد، Astra پایدارتر بود. از ۱۵ باگ تأییدشده، ۱۰ مورد در هر دو اجرای تکراری ظاهر شدند و ۱۴ مورد در حداقل یکی از آنها. اما در Luna، از ۱۵ باگ تأییدشده، تنها ۷ مورد در هر دو اجرا و ۱۲ مورد در حداقل یکی از آنها بازگشتند. این نشان میدهد Luna احتمال بیشتری دارد باگی را که قبلاً یافته، این بار نادیده بگیرد.
- منفیهای کاذب: ۲۶ باگ تأییدشده توسط هر دو مدل نادیده گرفته شد و فقط توسط Sol یا Entelligence یافت شد. این شامل دو باگ امنیتی در Discourse بود: یکی مربوط به بررسی منشأ postMessage با استفاده از تطبیق زیررشته (substring match) و دیگری مربوط به یک fetch از راه دور که ریدایرکتهای بعد از لیست سفید میزبان را دنبال میکرد. تعداد واقعی باگهای از دست رفته بیشتر است، زیرا باگهایی که توسط هیچ بازبینیکنندهای یافت نشوند، هرگز وارد مجموعه داده نمیشوند.
آنچه یک Diff به مدل نمیگوید
در این محک، مدل ارزانقیمت در تغییرات کلی عالی بود اما در کدهای احراز هویت و دسترسی شکست خورد. یک تفاضل کد (Diff) بهتنهایی به مدل نمیگوید که چه نوع تغییری را بازبینی میکند. مدل فاقد این دانش است که آیا یک فایل در مسیر احراز هویت قرار دارد یا یک تابع از جریان ورود (Login Flow) فراخوانی میشود.
دانستن اینکه آیا تغییر مشابهی در فصل گذشته باعث حادثهای در محیط عملیاتی شده است، نحوه بازبینی مدل را تغییر میدهد. سرویس Entelligence با استفاده از زمینه کامل مخزن کد و بازگرداندن رفتار عملیاتی به بازبینیهای بعدی، این نقص را برطرف میکند؛ اطلاعاتی که یک مدل مبتنی بر Diff-only فاقد آن است.
استراتژی ترکیبی
اجرای هر دو مدل روی هر درخواست بازبینی، ۱۱۷ مورد از ۱۴۳ باگ (۸۲٪) را با هزینه کل ۵.۸۶ دلار شناسایی میکرد. این نشان میدهد رویکرد لایهای بهینهترین مسیر است.
با هدایت بررسیهای روتین به Luna و رزرو Astra برای تغییرات مربوط به احراز هویت یا مجوزها، تیمها میتوانند شناسایی باگ را به حداکثر و هزینهها را به حداقل برسانند. اما این کار نیازمند یک «مسیریاب مدل» (Model Router) است که حساسیت کد را تشخیص دهد. Entelligence Model Router همین کار را برای عاملهای کدنویسی انجام میدهد و مراحل روتین را به مدلهای ارزانتر و مراحل دشوار را به مدلهای قویتر میفرستد.
این تغییر در رویه نشان میدهد عصر «یک مدل برای همه کارها» به پایان رسیده است. ما وارد دورانی از مسیریابی تخصصی میشویم که هدف، بالاترین نمره بنچمارک نیست، بلکه کمترین هزینه بهازای هر باگ تأییدشده است.
گام بعدی شما
اگر مخزن کد بزرگی مدیریت میکنید، میتوانید این تست را تکرار کنید:
- ۳۰ تا ۵۰ مورد از PRهای ادغامشدهای را که بعداً نیاز به اصلاح داشتند جمعآوری کنید.
- یک مدل ارزان و یک مدل گران را با پرامپت یکسان روی این دادهها اجرا کنید.
- یافتهها را با داوری مدل سومی که جزو آن دو نیست، یا با نمونهبرداری انسانی تأیید کنید.
- نتایج را بر اساس مخزن و کلاس باگ تفکیک کنید تا نقاط ضعف را بیابید.
- تعدادی از PRها را دوباره اجرا کنید تا میزان تغییرپذیری (Variance) را بسنجید.
- هزینه بهازای هر باگ تأییدشده را مقایسه کنید و روی کلاسهایی تمرکز کنید که از دست دادن باگ در آنها هزینهبر است.
خلاصه: Luna سه چهارم باگهای تأییدشده Astra را با کمتر از ۴٪ هزینه یافت. بیشترین عقبماندگی آن در کدهای احراز هویت و مجوزها بود، جایی که یک باگ از دست رفته معمولاً بیشترین هزینه را به همراه دارد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو