هزینه تولید کدهای با کارایی بالا برای GPU معمولاً هفتهها تنظیم دستی و داشتن مدرک دکترا در معماری سختافزار است. اما ابزار Agentic-CUDA-Optimizer که در ۲۵ سپتامبر ۲۰۲۶ منتشر شد، این فرآیند طاقتفرسا را با یک چرخه خودکار از تولید کد و اصلاح در سطح سختافزار جایگزین میکند.
برای اکثر توسعهدهندگان، بهینهسازی یک هسته CUDA شبیه به یک «جعبه سیاه» است؛ یعنی حدس میزنند چه تنظیماتی جواب میدهد و امیدوارند سرعت اجرا بالا برود. این ابزار بهینهسازی را مانند یک مسئله جستوجو میبیند و از یک عامل (Agent) — شبیه به یک مهندس سختافزار مجازی که مدام کد را امتحان میکند و بر اساس نتیجه تغییر میدهد — استفاده میکند تا سریعترین نسخه تأییدشده را پیدا کند.
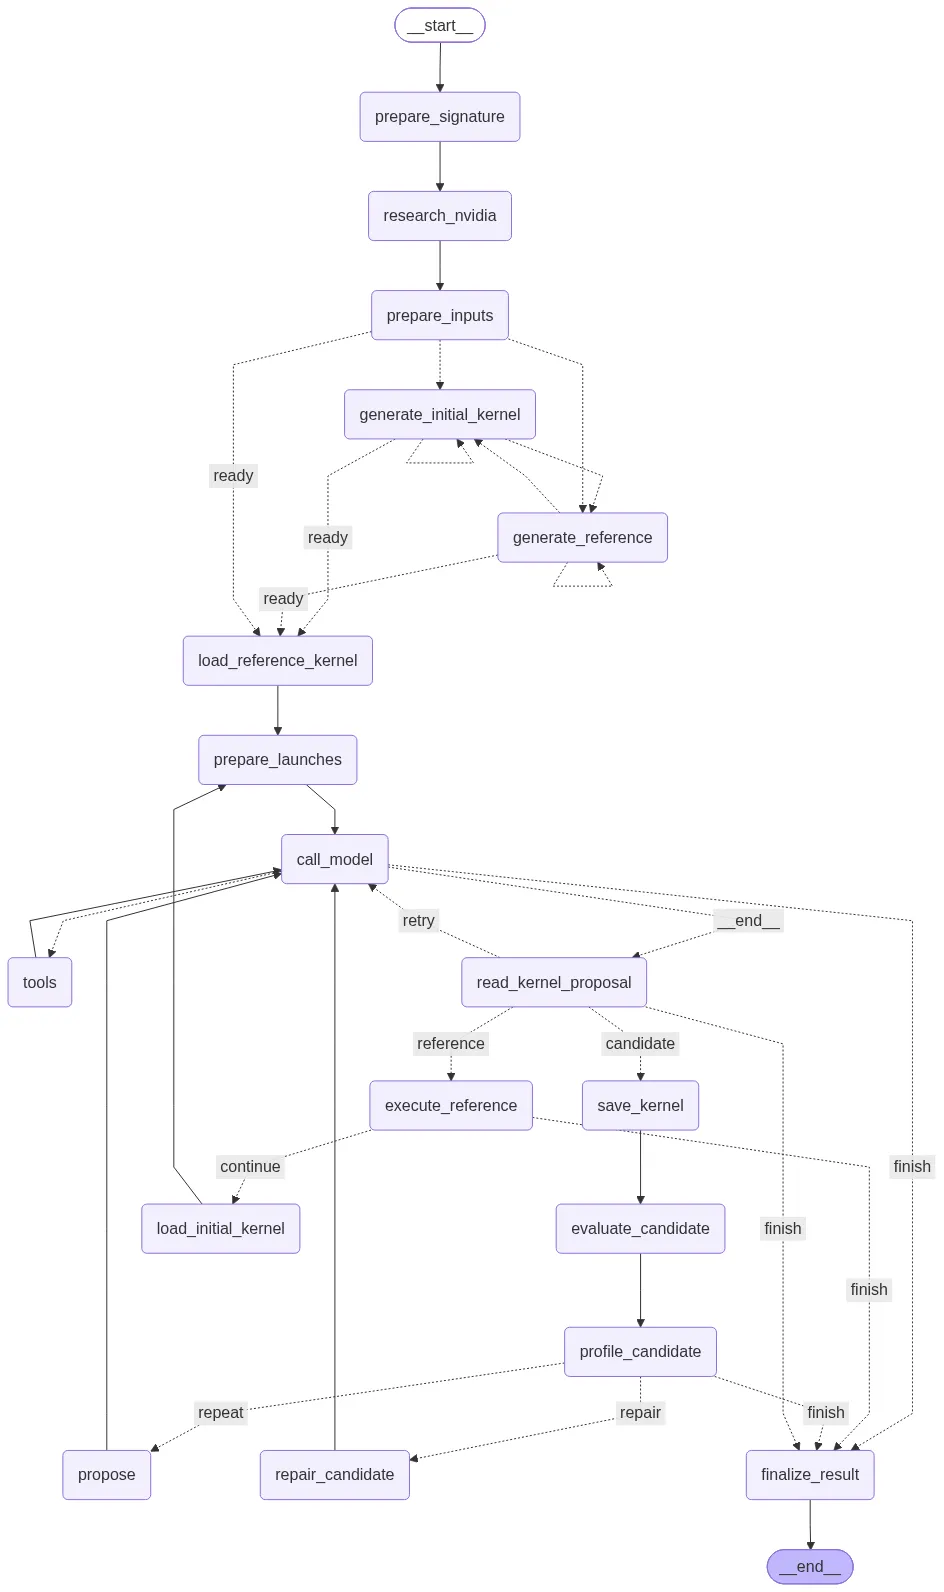
به نقل از مستندات گیتهاب این پروژه، سامانه بر پایه LangGraph و یک محیط اجرایی C++ مستقل بنا شده است. گردش کار در یک حلقه بسته عمل میکند: عامل یک تغییر در هسته پیشنهاد میدهد، آن را با استفاده از NVRTC کامپایل میکند و خروجی را با یک پیادهسازی مرجع در NumPy میسنجد.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، اتکای بیشتر به کدهای تولیدشده توسط AI نیازمند لایههای اعتبارسنجی سختگیرانه است. در این ابزار، بهینهساز توصیفات کاری را از طریق چرخهای از تولید، بررسی صحت، بنچمارک و اصلاح به پیادهسازیهای GPU تبدیل میکند. این سیستم میتواند هم کد هسته و هم تنظیمات اجرای هر مورد را تغییر دهد.
فرآیند با بارگذاری یا تولید یک امضا، موارد ورودی، یک هسته مرجع و یک هسته اولیه آغاز میشود. سیستم ابتدا نسخه مرجع را اجرا میکند تا یک خط مبنا ایجاد کند. اگر یک کاندیدای کد نامعتبر باشد، عامل تلاش میکند در محدوده بودجه تکرارهای تعیینشده، آن را تعمیر کند.
معماری فنی
- یکپارچگی سختافزاری: عامل میتواند ویژگیهای GPU را استعلام کند و در صورت فعال بودن پرچم
--use-nsight، شمارندههای Nsight Compute را بررسی کند تا آزمایش بعدی خود را بر اساس دادههای واقعی سختافزار تنظیم کند. - قابلیتهای پژوهشی: با استفاده از پرچم
--nvidia-research، مدل پیش از تولید کد، راهنماییهای رسمی انویدیا را بازیابی میکند تا از خطاهای رایج دوری کند. - منطق اعتبارسنجی: هر کاندیدا باید تمام موارد صحت را پاس کند؛ سپس رتبهبندی بر اساس میانگین هندسی تأخیر (Latency) در موارد عملکردی تعیین میشود.
- بنچمارک: زمانسنجی بهصورت پیشفرض شامل ۱۰ اجرای گرمکننده و ۱۰۰ اجرای اندازهگیری شده با استفاده از رویدادهای CUDA است.
نصب و پیشنیازها
این سامانه روی ویندوز و با استفاده از یک RTX 3060 Laptop GPU توسعه یافته است و به Python 3.12+، CMake 3.24+ و یک کامپایلر C++17 نیاز دارد. برای تعادل بین هزینه و کیفیت بهینهسازی، بهصورت پیشفرض از مدل gpt-5-mini با تلاش استدلالی متوسط استفاده میکند.
برای ساخت محیط اجرایی، کاربران دستور cmake -S cuda_test_harness -B cuda_test_harness/build -DCMAKE_BUILD_TYPE=Release را اجرا کرده و سپس یک بیلد موازی میگیرند. اجرای عامل از طریق پایتون صورت میگیرد و کاربران میتوانند تعداد تکرارها را با --max-iterations یا یک فایل تنظیمات سفارشی تعیین کنند. این رویکرد خودکارسازی میتواند بسیاری از چالشهای محیطی را حل کند، چرا که ناسازگاریهای CUDA و درایورها اغلب باعث اتلاف زمان و هزینههای اجاره GPU میشوند.
این چرخش به سمت بهینهسازی سختافزاری عاملمحور، معیار برنامهنویسی GPU را تغییر میدهد. بهجای اینکه انسان کد نهایی را بنویسد، نقش توسعهدهنده به تعریف «امضا» و «اوراکل صحت» تغییر میکند. هوش مصنوعی وظیفه خستهکننده نگاشت این منطق به سلسلهمراتب حافظه خاص هر GPU را بر عهده میگیرد.
بر اساس بررسی منابع متعدد، اگرچه این ابزار آزمایشی است و مقایسه مستقیمی با کتابخانههای رسمی مانند cuBLAS ندارد، اما ثابت میکند که مدلهای زبانی بزرگ میتوانند از پروفایلرهای سختافزاری بهعنوان یک حلقه بازخورد استفاده کنند. این توانایی در بهینهسازی، تفاوتهای بنیادین عملکردی را برجسته میکند؛ مشابه آنچه در مقایسه شتابدهی GPU در برابر CPU برای جریانهای کاری cuML مشاهده کردیم.
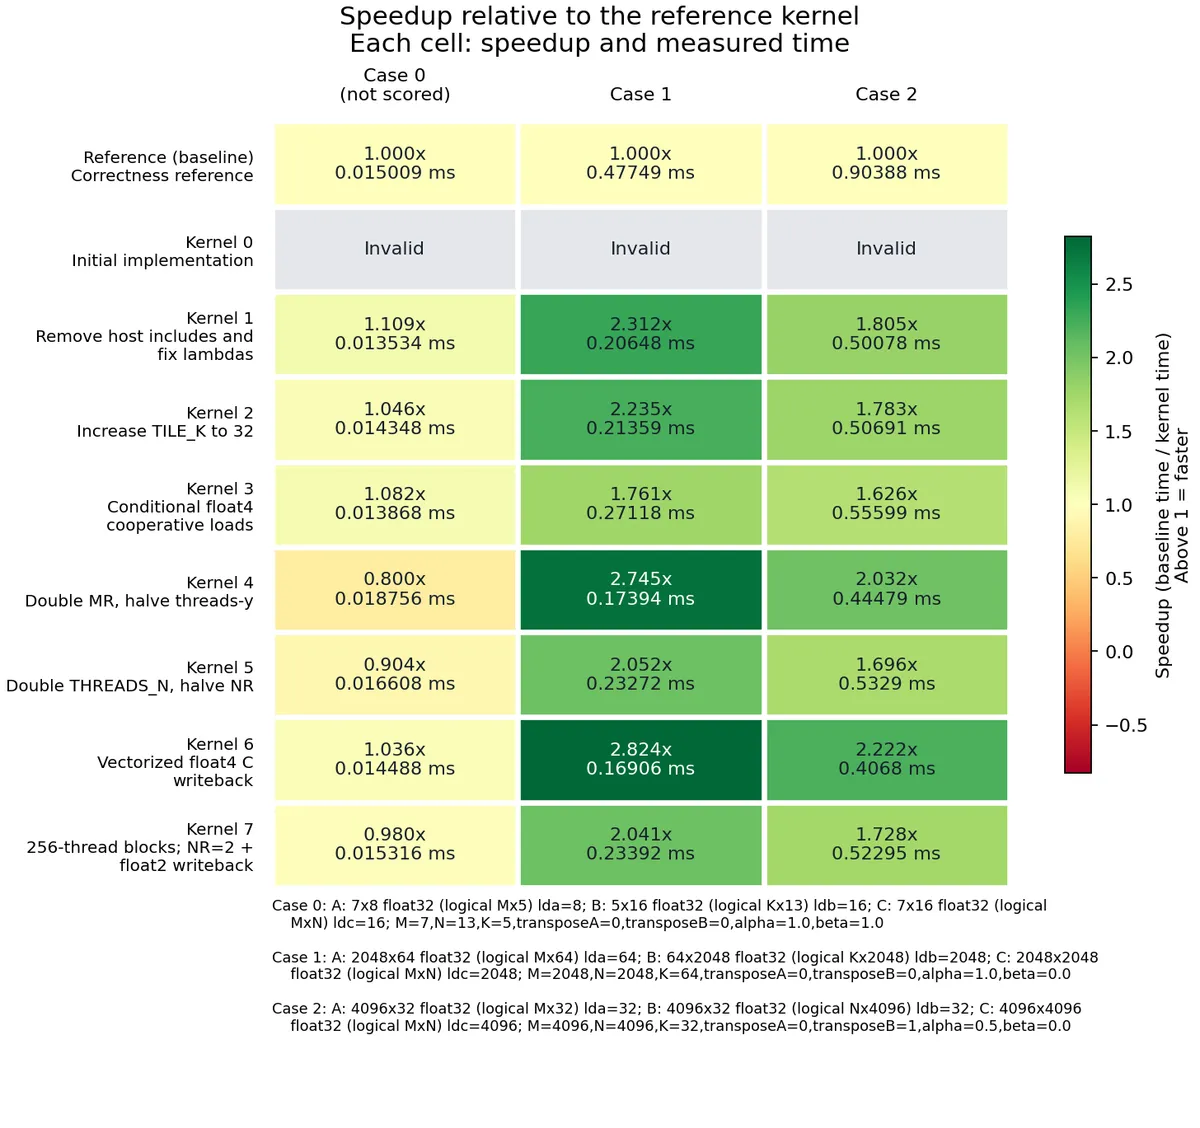
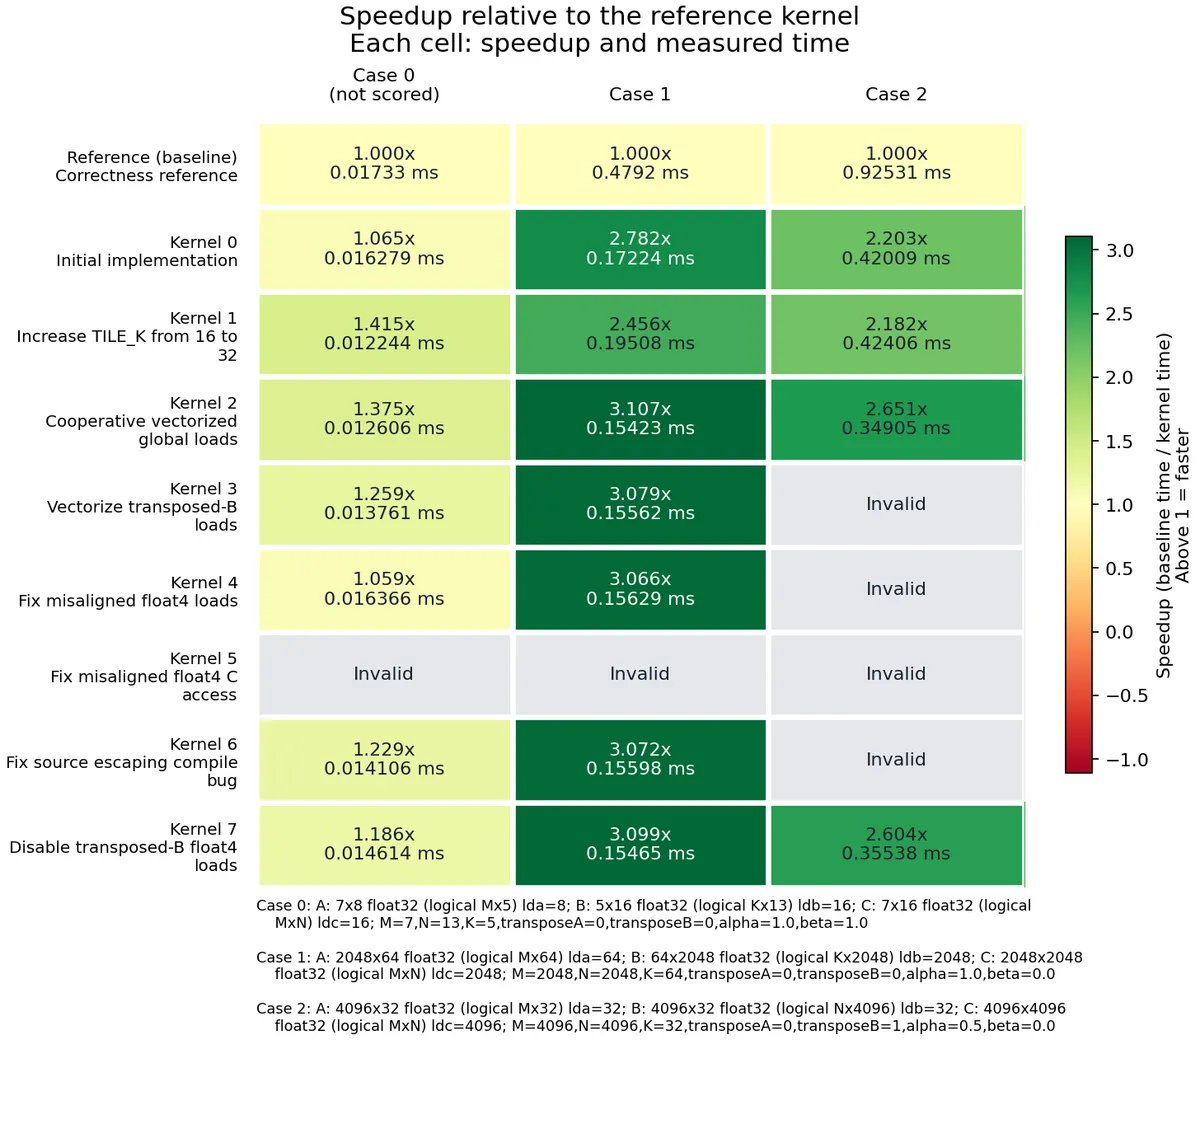
هر جلسه اجرا، تاریخچه خود را در results/run-NNN/ ذخیره کرده و یک فایل best.cu و یک نقشه حرارتی (Heatmap) از زمانها صادر میکند. این موضوع آیندهای را نشان میدهد که در آن هستههای GPU نه فقط توسط یک کامپایلر، بلکه توسط عاملی کامپایل میشوند که عملکرد سختافزار را در لحظه «حس» میکند.
توسعهدهندگان میتوانند با تست مثالهای GEMM (ضرب ماتریسهای عمومی) شروع کنند تا ببینند عامل چگونه روی پیکربندیهای مختلف ماتریسهای مستطیلی تکرار میکند.
گام بعدی شما
- اگر با CUDA کار میکنید، مخزن این پروژه را برای بهینهسازی توابع ریاضی سنگین خود امتحان کنید.
- بررسی کنید که آیا مدلهای استدلالی کوچکتر (مانند gpt-5-mini) میتوانند در محیطهای محلی جایگزین مدلهای غولپیکر شوند.
- روی تعریف «اوراکلهای صحت» دقیقتر شوید تا ریسک توهم مدل در کدهای سطح پایین کاهش یابد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو