تصور کنید یک برنامهنویس برای اتوماسیون کدنویسی روی یک زنجیره از عاملها حساب کرده است، اما سیستم به جای کد نهایی، جمله «من بررسی میکنم» را به عنوان نتیجه تحویل میدهد. این تضاد میان سیگنالهای موفقیت، باعث شکست کامل خط لولههای پردازشی در ابزار any-agents شده بود؛ ابزاری که برای واگذاری وظایف به دستیارهای کدنویسی هوش مصنوعی و جمعآوری خروجیهای آنها طراحی شده است.
طبق گزارشهای فنی منتشر شده در ۱۴ سپتامبر ۲۰۲۶، تحلیلها نشان داد که توزیعکننده (Dispatcher) در any-agents برای تشخیص موفقیت، به سیگنال اشتباهی اعتماد میکرد. در بسیاری از گردشهای کاری، یک ابزار خط فرمان با سرویس ارتباط برقرار کرده و یک «کد خروج» (Exit Code) برمیگرداند که در آن عدد صفر معمولاً به معنای موفقیت است. اما این سیستم محتوای واقعی پاسخ هوش مصنوعی را نادیده میگرفت؛ پاسخی که حتی با وجود کد خروج صفر، حاوی پیامهای خطای صریح بود.
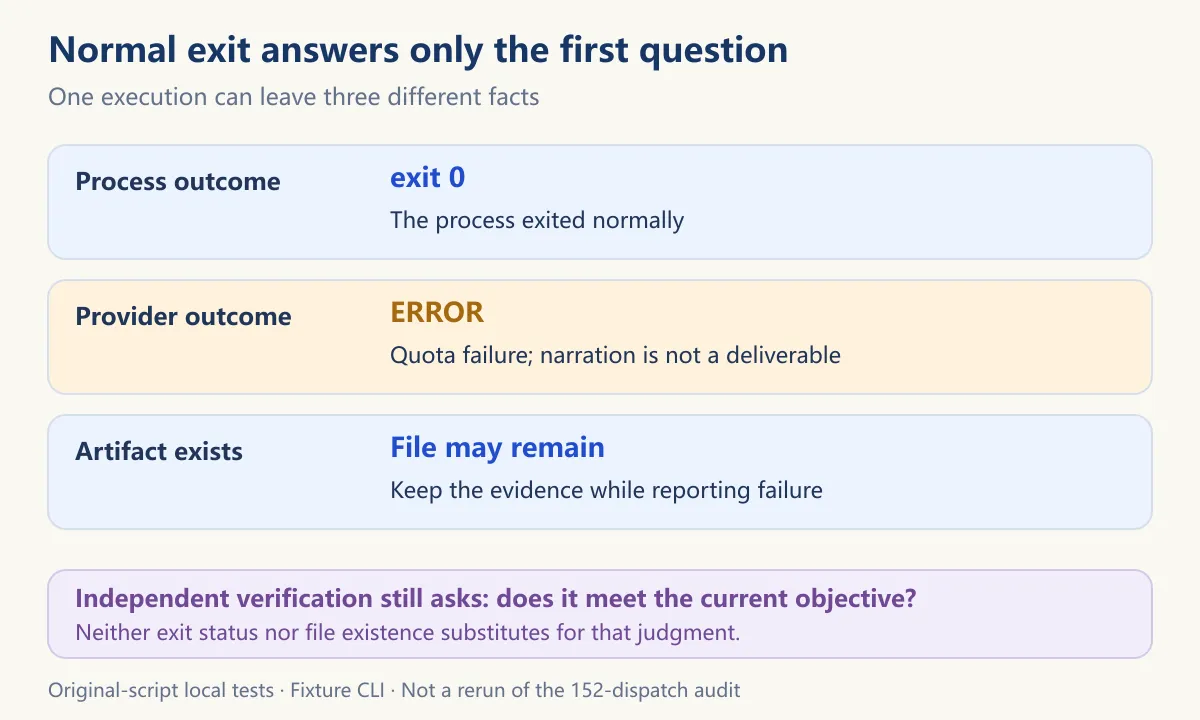
برای درک بهتر، سناریویی را تصور کنید که در آن هوش مصنوعی به سقف سهمیه (Quota Limit) خود میرسد. در این حالت، ابزار ممکن است بهطور عادی بسته شود (کد خروج صفر)، اما سرویس هوش مصنوعی وضعیتی با عنوان «ERROR» را به همراه یک روایت آغازین مودبانه مانند «من نگاهی به آن میاندازم» برگرداند. چون توزیعکننده فقط خروج عادی و وجود هر نوع متنی را بررسی میکرد، آن روایت آغازین را به عنوان محصول نهایی در فایل نتایج ثبت میکرد.
زمینه: تضاد سیگنالها
این نقص زمانی رخ میدهد که یک فراخوانی هوش مصنوعی از چندین لایه عبور میکند: توزیعکننده یک ابزار خط فرمان را اجرا میکند، این ابزار با سرویس هوش مصنوعی ارتباط میگیرد و پاسخ را بازمیگرداند. مشکل دقیقاً زمانی شروع میشود که توزیعکننده به کد خروج فرآیند بیرونی اعتماد میکند و در عین حال، پاسخ داخلی سرویس را نادیده میگیرد.
این موضوع توجه توسعهدهندگان CodeFlowMu — سیستمی برای همکاری میان دستیارهای هوش مصنوعی — را جلب کرد. در فرآیند تحویل کار بین دو عامل (Agent)، مرحله بعدی باید دقیقاً بداند که آیا نتیجهای برای اعتبارسنجی آماده است یا صرفاً خروجیِ یک کار ناتمام است. نقص موجود در any-agents یک مثال عینی از این تضاد بود: کد خروج موفقیت را گزارش میکرد، اما پاسخ سرویس شکست را اعلام مینمود. این چالش با بررسی توهمات عاملهای کدنویس در گزارشهای پیشین همسو است که نشان میدهد چگونه سیگنالهای کاذب موفقیت میتوانند منجر به ورود کد معیوب شوند.
مکانیسمهای شکست و اصلاح
به نقل از مستندات پروژه، توسعهدهندهای به نام Yue Zhao راهکاری را پیاده کرد که توزیعکننده را مجبور میکند بین دو سیگنال متضاد (کد خروج و وضعیت سرویس) مصالحه کند. تیم توسعه برای تایید این اصلاحیه، آزمایشی متمرکز با استفاده از یک «جایگزین تست» (Test Double) برای شبیهسازی پاسخهای هوش مصنوعی در پنج سناریوی خاص اجرا کردند. برای حفظ کنترل بر محتوا، اجرای فرآیند، خواندن رویدادها و نوشتن فایلهای موقت بهصورت محلی مدیریت شد.
- خروج صفر با پاسخ خطا: پیش از اصلاح، سیستم این مورد را موفقیت میدانست زیرا فرآیند به پایان رسیده بود و متنی وجود داشت. اکنون این مورد بهدرستی به عنوان شکست گزارش میشود و یک نشانگر جایگزین (Fallback Marker) باقی میگذارد.
- خطا پس از نوشتن فایل: اصلاحیه جدید، فایلهایی را که بهطور جزئی نوشته شدهاند برای بازرسی نگه میدارد، اما همچنان اجرای برنامه را به عنوان شکست گزارش میکند تا نتایج ناقص به عنوان محصول نهایی ارسال نشوند.
- پیام بدون وضعیت پس از خطا: تجزیهکننده (Parser) اکنون آخرین وضعیت، خطا و متن غیرخالی ارائه شده را بهطور مجزا حفظ میکند. این کار مانع از آن میشود که یک رویداد بعدی که فاقد فیلد وضعیت است، خطای شناسایی شده قبلی را بازنویسی کند.
- موفقیت صریح: سیستم همچنان نتایجی را که صراحتاً با متن نتیجه به عنوان موفقیت علامتگذاری شدهاند، منتقل میکند.
- حالت سازگاری: پاسخهایی که فاقد فیلد وضعیت هستند، طبق یک قانون سازگاری پذیرفته میشوند تا فرمتهای قدیمی پاسخها باعث شکست سیستم نشوند.
مدیریت کارهای ناقص
یکی از ظریفترین بخشهای این اصلاح، نحوه برخورد با فایلهای ایجاد شده پیش از کرش (Crash) است. توسعهدهندگان تصمیم گرفتند فایلها را صرفاً به دلیل شکست اجرای برنامه پاک نکنند، زیرا حذف آنها به معنای دور ریختن کارهای بالقوه مفید است. بنابراین، سیستم اکنون دو حقیقت مجزا را ثبت میکند: «فایل وجود دارد» و «اجرا شکست خورد».
این تفکیک برای توسعهدهندگان حیاتی است؛ زیرا وجود فایل ثابت میکند چیزی برای بررسی وجود دارد، اما ثابت نمیکند که نتیجه درست یا کامل است. با نگه داشتن هر دو سیگنال بهصورت قابل مشاهده، مرحله بعدی در خط لوله میداند که باید محتوا را بهصورت دستی تایید کند، نه اینکه به آن به عنوان محصول نهایی اعتماد کند. این رویکرد یادآور پروتکل سه-مرحلهای MonkeyCode است که با ایجاد لایههای بازرسی متوالی، از نشت باگهای پنهان در کدهای تولید شده توسط هوش مصنوعی جلوگیری میکند.
بهبودهای مسیریابی سهمیه (Quota Routing)
علاوه بر اصلاح توزیعکننده، پروژه یک تغییر در مسیریابی سهمیه معرفی کرد تا از وقوع این خطاها در وهله اول جلوگیری کند. سیستم اکنون پیش از توزیع هر وظیفه، عکسبرداریهایی (Snapshots) از سهمیه گروههای مدل را میخواند. اگر سهمیه گروههای سطح بالا مانند Claude یا GPT تمام شده باشد، سیستم میتواند بهطور خودکار به Gemini سوییچ کند. اما اگر سهمیه Gemini هم تمام شود، سیستم بهطور خودکار به گروههای کمیابتر باز نمیگردد.
برای تایید این سازوکار، تیم هفت تست واحد (Unit Test) را روی موارد خاص اجرا کرد:
- محدودترین حدهای باکت (Bucket Limits)
- مقادیر غیرمتناهی (Nonfinite values)
- اسنپشاتهای قدیمی پس از یک رفرش ناموفق
- زمانهای بازنشانی (Reset times)
- گروههای گزارش نشده
- گروهبندی بر اساس نام مدل
- غیرفعال کردن بررسی سهمیه
تمام این هفت تست در کنار چهار بررسی کمکی با استفاده از حافظههای موقت و جایگزینها، با موفقیت پاس شدند. توسعهدهندگان اشاره کردند که اگرچه بررسی اولیه به انتخاب مسیر کمک میکند، اما اجازه شروع و تکمیل موفقیتآمیز همچنان نیازمند تصمیمات مجزا و صریح است. گروهی که در اسنپشات غایب است ممکن است همچنان امتحان شود، زیرا ظرفیت آن «نامشخص» است و نه لزوماً «ناموجود».
محدوده و بازتولید
این تستها بر نحوه تفسیر ورودیهای مشخص توسط منبع پینشده (Pinned Source) متمرکز بودند. تیم توسعه حسابرسی تاریخی ۱۵۲ توزیعی نویسنده را تکرار نکرد و سهمیه واقعی سرویس را نیز به اتمام نرساند. بازآرایی دلخواه رویدادها و بازپخش آنها خارج از محدوده این تستها بود. تمام پنج مورد قبل/بعد، بررسیهای سهمیه و لاگهای اصلی در بسته شواهد مخزن تحقیقات نگهداری شدهاند.
این بررسی یک قانون بنیادی را برای سازندگان ابزارهای عاملمحور یادآوری میکند: هرگز فرض نکنید کد خروج یک فرآیند به معنای تولید موفقیتآمیز محتوا توسط هوش مصنوعی است. شما باید وضعیت داخلی پاسخ را تایید کنید و بین «موفقیت صریح» و «پذیرش به دلیل سازگاری» (جایی که وضعیت صرفاً غایب است) تفاوت قائل شوید.
یک پرسش طراحی باقیمانده این است که آیا لایههای اعتبارسنجی پاییندستی باید مطلع شوند که یک پاسخ صرفاً به دلیل سازگاری و بدون وضعیت موفقیت صریح پذیرفته شده است یا خیر. اگر بررسیهای پاییندستی فقط یک «پاس» (Pass) را ببینند، ممکن است نتوانند بین این دو نوع شواهد تفاوت قائل شوند. تحقیقات آینده بررسی خواهد کرد که آیا این تفاوت باید در عمل بر اعتبارسنجی اثر بگذارد یا خیر. این نیاز به مستندات دقیقتر از خطاها، با تغییرات اخیر در متدهای مصاحبه فنی همسو است که در آن تحلیل لاگهای خطا جایگزین بررسی سادهی کد نهایی شده است.
اگر شما هم در حال مدیریت عاملهای هوش مصنوعی در محیط عملیاتی هستید، منطق مدیریت نتایج خود را بازبینی کنید تا مطمئن شوید «جملات آغازین» را با «خروجی نهایی» اشتباه نمیگیرید. بررسی کنید که آیا سیستم شما میتواند بین یک اجرای موفق و اجرایی که صرفاً کرش نکرده است، تفاوت قائل شود.
گام بعدی شما
- منطق بررسی خروجیهای API خود را از حالت تکی (فقط کد خروج) به حالت ترکیبی (کد خروج + وضعیت داخلی پاسخ) تغییر دهید.
- در خط لولههای اتوماسیون، مکانیزمی برای تفکیک «فایلهای موجود اما ناقص» از «نتایج تایید شده» ایجاد کنید.
- برای جلوگیری از توقف سیستم به دلیل اتمام سهمیه، یک لایه مسیریابی خودکار بین مدلهای مختلف (مثلاً از GPT به Gemini) پیادهسازی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو