اگر امروز عاملهای هوش مصنوعی شما در برابر درخواستهای پیچیده کند عمل میکنند، احتمالاً با یک گلوگاه اجرایی دستوپنجه نرم میکنید. طبق یک راهنمای فنی که در ۱ اکتبر ۲۰۲۶ در وبسایت dev.to منتشر شد، ترکیب دو ابزار asyncio و Pydantic میتواند نحوه تعامل عاملها با APIهای خارجی و پردازش دادهها را بهطور بنیادین تغییر دهد.
تصور کنید عاملی دارید که باید همزمان دادههای آبوهوا را بگیرد، یک پایگاهداده را جستوجو کند و ایمیلی ارسال نماید. در یک ساختار سنتی و همگام (Synchronous)، پردازنده در حالی که منتظر پاسخ API آبوهوا است، هیچ کاری نمیکند و تا این پاسخ نرسد، سراغ جستوجوی پایگاهداده نمیرود. این چرخه «توقف و انتظار»، زمان محاسبات را هدر داده و تجربه کاربر را بهشدت کند میکند.
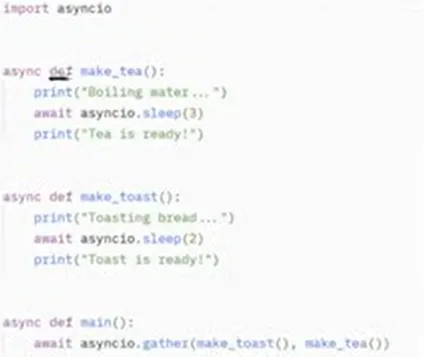
برای حل این مشکل، توسعهدهندگان از asyncio برای پیادهسازی برنامهنویسی ناهمگام (Asynchronous Programming) استفاده میکنند. این ابزار — شبیه به کسی که همزمان با دم کردن چای، نان تست میکند تا زمان را از دست ندهد — به سیستم اجازه میدهد بهجای انتظار برای پایان هر عملیات، «سوئیچ زمینه» انجام دهد و چندین درخواست را بهطور موازی ارسال کند بدون اینکه رشته اصلی برنامه متوقف شود.
اما سرعت بهتنهایی کافی نیست، زیرا دادههای فاسد میتوانند کل سیستم را متوقف کنند. مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — بهطور طبیعی متنهای بدون ساختار تولید میکنند. در محیط پایتون که نوع متغیرها پویا است، این موضوع یک ریسک بزرگ است؛ چون یک متغیر میتواند بدون هشدار از عدد به رشته تغییر کند.
همانطور که در تحلیلهای قبلی ما دربارهی پایداری سیستمهای عاملمحور اشاره کردیم، برای تضمین قابلیت اطمینان، استفاده از Pydantic توصیه میشود. این کتابخانه اعتبارسنجی دادههاست که اجازه نمیدهد دادههای نامعتبر وارد سیستم شوند. این رویکرد سختگیرانه در مدیریت دادهها، مکمل راهکارهای جدیدتری است که برای افزایش پاسخگویی و پایان دادن به خطاهای عملیاتی عاملهای خودکار معرفی شدهاند.
بر اساس مستندات این راهنما، توسعهدهندگان با تعریف یک BaseModel میتوانند خروجیهای مدل زبانی را مجبور به پیروی از یک طرح (Schema) سختگیرانه کنند. برای مثال، با استفاده از کلاس Field میتوان تعیین کرد که سن کاربر حتماً باید عددی بزرگتر از صفر باشد. اگر مدل زبانی یک عدد منفی یا یک متن برگرداند، Pydantic بلافاصله خطا را شناسایی میکند و اجازه نمیدهد برنامه در مراحل بعدی کرش کند.
این تغییر، رویکرد توسعه عاملها را از حالت «پرامپت بنویس و دعا کن» به مهندسی ساختاریافته تبدیل میکند. وقتی خروجیهای مدل را بهجای رشتههای متنی خام، بهعنوان اشیاء اعتبارسنجشده در نظر بگیرید، نیاز به کدهای دستی برای پاکسازی متن (Regex) و بررسیهای تکراری if-else بهشدت کاهش مییابد. این دقت در ساختار دادهها، پیشنیاز اجرای فرآیندهای پیچیدهتری است، مشابه آنچه در شبیهسازیهای معنایی برای شناسایی حفرههای قراردادهای هوشمند مشاهده میکنیم.
در نهایت، این یعنی عاملهای هوش مصنوعی بیشتر شبیه به نرمافزارهای سنتی میشوند: پیشبینیپذیر، سریع و ایمن از نظر نوع داده. دیگر نیازی نیست صدها خط کد بنویسید تا مطمئن شوید مدل دچار توهم (Hallucination) نشده و فرمت دادهای را تولید نکرده که پایگاهداده شما را مختل کند.
گام بعدی شما
- حلقههای اجرایی عاملهای خود را برای شناسایی گلوگاههای همگام (Synchronous await) بررسی کنید.
- پردازش خروجیها را از دستکاری رشتههای خام به طرحهای Pydantic منتقل کنید تا پایداری سطح تولید (Production-grade) به دست آید.
- برای کاهش بیشتر تأخیر، ترکیب این ابزارها را با مدلهای استدلالی سریعتر آزمایش کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو