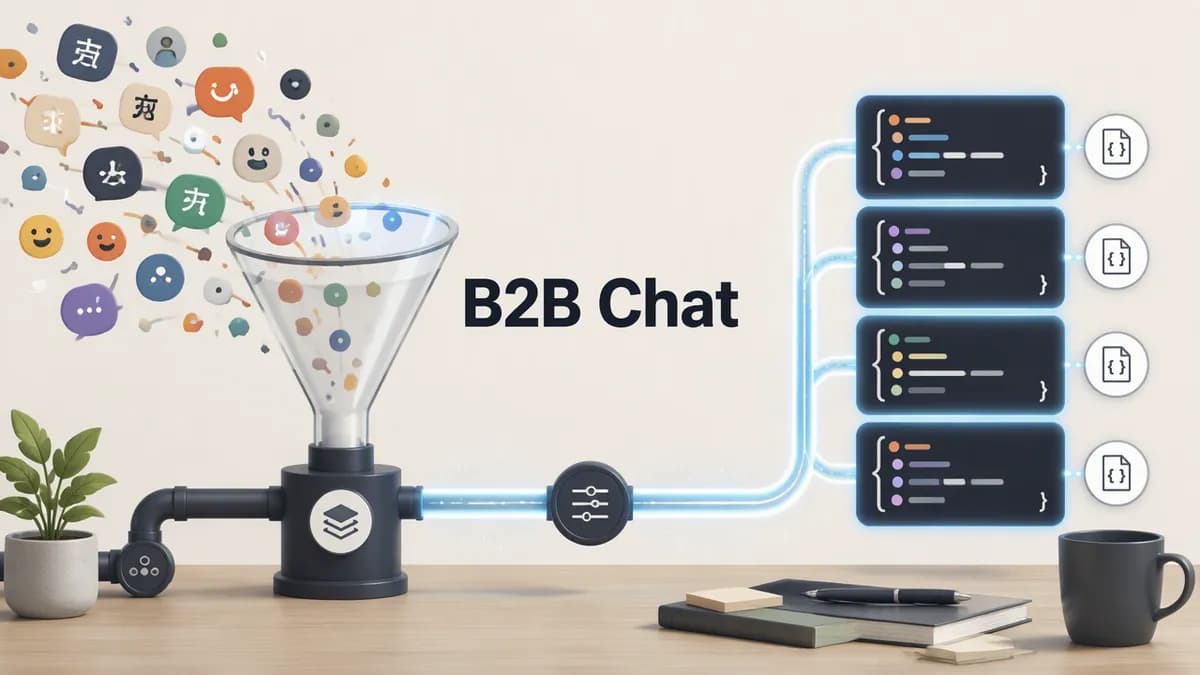
تصور کنید پیامی از مشتری دریافت میکنید که ترکیبی از سه زبان مختلف و پنج ایموجی است؛ چنین ورودیهای نامنظمی میتوانند حتی پیشرفتهترین جریانهای کاری هوش مصنوعی را به کلی مختل کنند. برای مقابله با این هرجومرج، شرکت B2B Chat در ۲۳ سپتامبر ۲۰۲۶ استراتژی استفاده از «تست فیکچر» (Test Fixture) محلی را برای محافظت از موتورهای هوش مصنوعی در برابر این ناپایداریها تشریح کرد.
بیشتر سیستمهای هوش مصنوعی در خدمات مشتری نه بهدلیل ضعف مدل، بلکه بهخاطر آمادهسازی نادرست دادهها شکست میخورند. دادههای کثیف — شبیه به مواد اولیه آلوده در یک آشپزخانه که کیفیت نهایی غذا را خراب میکند — میتوانند منطق تشخیص قصد کاربر یا ترجمه را به شدت مختل کنند. طبق اعلام B2B Chat، توسعهدهندگان میتوانند با ایجاد یک کتابخانه محلی از فایلهای JSON، این موارد خاص (Edge Cases) را بدون به خطر انداختن ترافیک واقعی تولید، شبیهسازی کنند.
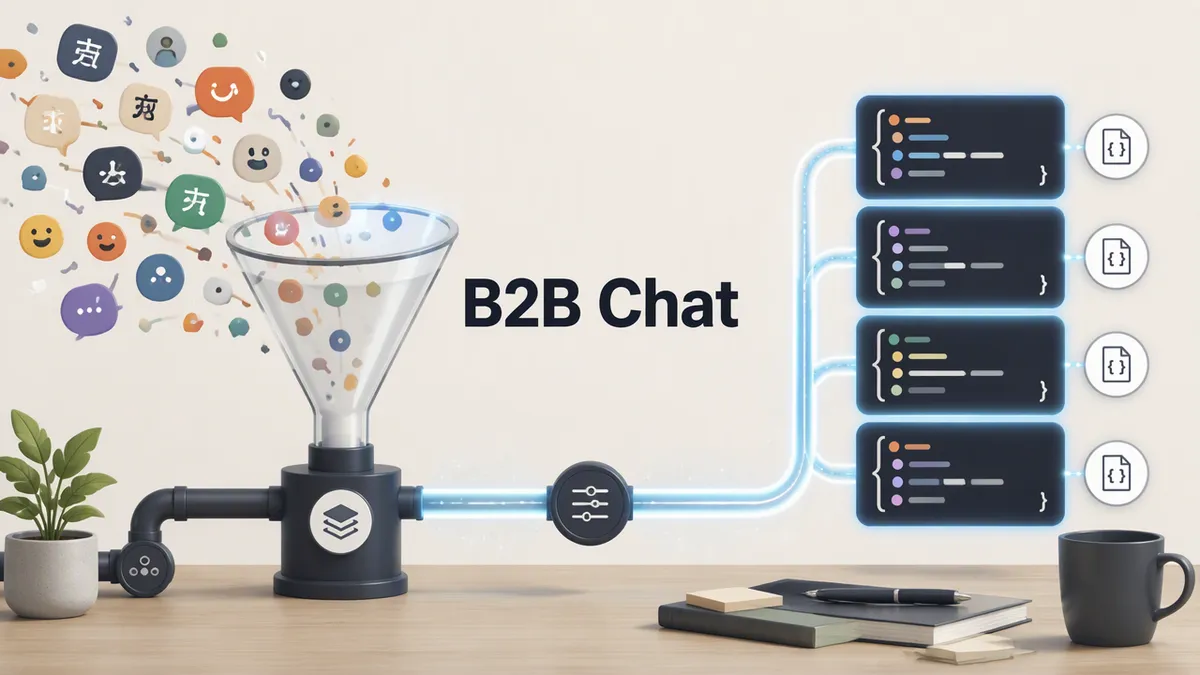
بر اساس مستندات این راهنما، یک کتابخانه فیکچر جامع باید شامل انواع خاصی از دادهها باشد:
- پیلودهای استاندارد: پیامهای ساده با برچسبهای زبانی مشخص (مثلاً پشتیبانی سفارشات به زبان انگلیسی).
- ورودیهای پیچیده: رشتههای متنی با اسکریپتهای ترکیبی (مثلاً ترکیب ژاپنی و انگلیسی) و متونی با تعداد زیاد ایموجی.
همانطور که در تحلیل قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، کنترل ورودیها اولین خط دفاعی در برابر رفتارهای پیشبینیناپذیر است. این رویکرد بهینهسازی ورودیها، مشابه تلاشهایی است که برای کاهش تأخیر در پاسخدهی عاملهای هوش مصنوعی از طریق تغییر فرمت دادهها صورت گرفته است. برای تضمین پایداری، این استراتژی یک چکلیست چهار مرحلهای را اجباری میکند: بررسی نرمالسازی اسکریپت برای جلوگیری از حذف نویسهها، حفظ زمینه (Context) برای تنظیم بیان هوش مصنوعی، حذف نویسههای کنترلی غیرضروری و تایید ساختاری که شناسایی زبان را در بیش از ۲۰۰ زبان پشتیبانی شده ممکن کند.
این چرخش راهبردی، بار مسئولیت قابلیت اطمینان را از دوش مدل هوش مصنوعی برمیدارد و به خط لوله پیشپردازش منتقل میکند. برای توسعهدهنده، این یعنی چرخههای تکرار سریعتر و کاهش چشمگیر هزینههای عیبیابی در محیط عملیاتی. در واقع، هوش مصنوعی از یک «جعبه سیاه» شکننده به یک جزء پیشبینیپذیر در یک سیستم بزرگتر تبدیل میشود. این مدل مدیریت دقیق جریانهای کاری، یادآور استراتژیهای ترکیبی انسان و AI برای ارتقای امنیت در قراردادهای هوشمند است که دقت سیستم را افزایش میدهد.
با جداسازی دادههای آزمایشی از کلاینت زنده، تیمها میتوانند منطق خود را پیش از ارسال حتی یک پیام به API اعتبارسنجی کنند. این کار تضمین میکند که پاسخهای خودکار خط اول، بر اساس دادههای پاک و ساختاریافته باشند، نه ورودیهای خام و غیرقابل پیشبینی کاربران. از سوی دیگر، مدیریت بهینه این فرآیندها میتواند به کنترل هزینههای ابری برای توسعهدهندگان مستقل کمک کند تا از مصرف بیرویه منابع جلوگیری شود.
گام بعدی شما
- خط لوله ورودی فعلی خود را برای نحوه مدیریت متون با اسکریپتهای ترکیبی بازبینی کنید.
- یک کتابخانه کوچک از فایلهای JSON شامل رایجترین خطاهای تایپی و ایموجیهای مشتریان خود بسازید.
- فرآیند پاکسازی (Sanitization) را پیش از ارسال داده به مدل استنتاج قرار دهید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو