اگر امروز از دستیارهای هوش مصنوعی برای توسعه پروژههای بزرگ استفاده میکنید، احتمالاً با پیشنهاداتی مواجه شدهاید که با اطمینان کامل، تغییراتی را در فایلی پیشنهاد میدهند که اصلاً به منطق مورد نظر مربوط نیست. این اتفاق به این دلیل رخ میدهد که مدلها، هرچقدر هم پیشرفته باشند، نمیتوانند پیوندهای معماری منحصربهفرد کد خصوصی شما را بدون راهنمایی صریح استنباط کنند. آنها نقشهی ارتباطات اجزای خاص پروژه شما را نمیشناسند.
این شکاف باعث میشود دستیار هوش مصنوعی به جای تکیه بر شواهد، بر اساس نام توابع یا ساختار پوشهها حدس بزند. در نتیجه، مدل با همان اطمینانی که برای یک مثال کتابخانهای نشان میدهد، اولین فایلی که شبیه به هدف باشد را پیشنهاد میدهد، حتی اگر منطق واقعی دو مرحله دورتر و در فایلی باشد که شما هرگز نامش را نبردهاید.
به نقل از پژوهشی که در سال ۲۰۲۴ توسط Sergeyuk، Golubev، Bryksin و Ahmed منتشر شد، یک شکاف بحرانی وجود دارد: توسعهدهندگان از هوش مصنوعی بسیار بیشتر برای نوشتن و خلاصهسازی کد استفاده میکنند تا برای یافتن محل دقیق جایی که یک تغییر باید اعمال شود. همین موضوع منجر به رایجترین شکستهای AI میشود: پیشنهادهای نادرست، درک ضعیف از پروژه و اعتماد به نفس کاذب مدل. مدلها به جای استفاده از شواهد، بر اساس حدس میزنند، در حالی که هرگز یاد نگرفتهاند کدام بخشهای اپلیکیشن شما به یکدیگر متصل هستند.
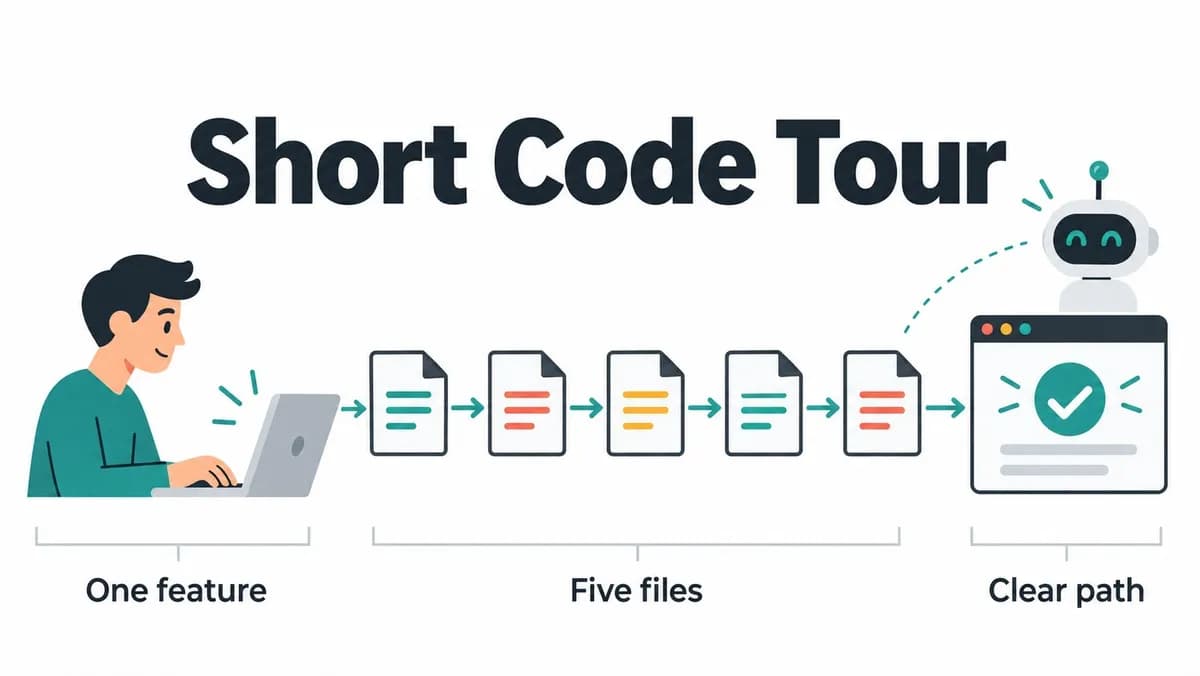
همانطور که در تحلیلهای پیشین ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، تکیه بر حدسهای مدل بدون داشتن زمینهی (Context) دقیق، ریسک خطاهای سیستمی را بالا میبرد. برای حل این مشکل، توسعهدهندگان در حال پذیرش روش «تور کد» (Code Tour) هستند. تور کد یک سند طراحی کامل یا یک مستند جامع نیست؛ بلکه یک ردپای عمدی، محدود و دقیق از یک قابلیت قابل مشاهده است که از لحظهی تحریک توسط کاربر تا نتیجهی نهایی را دنبال میکند.
با ارائه این نقشه به هوش مصنوعی، فرآیند مدل از استنتاج (Inference) — که شبیه به حدس زدن یک آشپز دربارهی مواد اولیه بدون دیدن دستور پخت است — به ویرایش مبتنی بر شواهد تغییر میکند. مدل دیگر حدس نمیزند، بلکه بر اساس شواهدی که شما جمعآوری کردهاید عمل میکند.
کالبدشکافی یک قابلیت محدود
یک تور موفق باید روی یک اقدام واحد با یک نتیجهی قابل مشاهده تمرکز کند. قابلیت را آنقدر محدود انتخاب کنید که در یک جمله قابل توصیف باشد. اگر قابلیت بیش از حد گسترده باشد، مدل ممکن است برای هدف اشتباهی بهینهسازی کند.
مثالهایی از قابلیتهای محدود:
- صفحه پروفایل: دکمهای برای ذخیره که یک نام، یک توصیف کوتاه و یک ارجاع به عکس را مینویسد و سپس یک پیام تأیید نمایش میدهد.
- کادر جستوجو: فیلدی که چند کلمه را میگیرد، نتایج منطبق را واکشی میکند و لیستی را نمایش میدهد.
- سوئیچ ادمین: کلیدی که یک تنظیم را تغییر داده و ثبت میکند چه کسی این تغییر را انجام داده است.
مرز این تور توسط تجربهی کاربر تعریف میشود. اگر کلیک روی «ذخیره» باعث ارسال یک اعلان ایمیلی یا پاک کردن یک فایل موقت هم بشود، اینها رفتارهای جداگانهای هستند. ترکیب این موارد در یک تور واحد باعث سردرگمی مدل میشود. یک تور محدود معمولاً شامل تعداد کمی فایل است؛ مثلاً یک کامپوننت فرم، تابعی که ورودی را بررسی میکند، یک هندلر که درخواست را پردازش میکند، ماژولی که دادهها را در حافظه مینویسد و تکهای کد که پاسخ را فرمت میکند. همین زنجیره کوتاه (مثلاً پنج فایل) و یک جلسه مطالعه سریع، بستر کافی را برای مدل فراهم میکند تا بدون بازنویسی توابع اشتباه، یک فیلد جدید یا یک قانون سختگیرانهتر را پیشنهاد دهد.
ردیابی مسیر اجرا
برای اینکه تور برای دستیار AI مفید باشد، باید توالی سختگیرانهای را دنبال کند:
- محرک (Trigger): از جایی شروع کنید که کاربر اقدام میکند. برای یک رابط کاربری مرورگر، این معمولاً یک دکمه یا ارسال فرم است. برای یک تسک زمانبندی شده، تعریفِ Job است و برای یک درخواست خارجی، نقطه ورودی (Entry Point) است که به تماسهای ورودی گوش میدهد. نام فایل و تابع یا محدوده خطوط را یادداشت کنید. اگر تابع اول صرفاً تابع دومی را فراخوانی میکند، آن فراخوانی را دنبال کرده و فایل دوم را ثبت کنید.
- تصمیم اصلی: جایی را شناسایی کنید که کد یک شرط را بررسی میکند، مسیری را انتخاب میکند یا ورودی را به یک اقدام تبدیل میکند. این میتواند تابعی باشد که در صورت نبودن چیزی خطا برمیگرداند، بررسی مجوزها (Permissions) یا روتینی که دستوری برای ذخیرهسازی میسازد. نام فایل، نام تابع و هر تنظیم، Feature Toggle، نقش کاربری یا تنظیمات محیطی (Environment) که کد به آن وابسته است را ثبت کنید.
- جریان اطلاعات: ردیابی کنید که سیستم کجا داده میخواند و کجا مینویسد. آیا یک ناحیه نگهداری موقت یا فراخوانی به سرویس دیگری وجود دارد؟ مسیر را از طریق مبدلها (Converters) یا مراحل پاکسازی دنبال کنید تا دادهها به ذخیرهساز دائمی برسند یا از اپلیکیشن خارج شوند. هر فایل و تابع کلیدی را ثبت کنید.
- نتیجه قابل مشاهده: تور را جایی به پایان برسانید که کاربر اثر اقدام را میبیند. برای یک فرم وب، این پیام موفقیت، لیست خطاها یا یک Redirect است. برای یک درخواست ورودی، بدنه پاسخ (Response Body) و وضعیت (Status) است. برای یک Job پسزمینه، ممکن است یک ورودی در Log یا تغییری در داشبورد باشد. فایل و خطی که این خروجی را تولید میکند بنویسید.
تفکیک واقعیتها از فرضها
یک هوش مصنوعی تنها به اندازهی دادههایی که دریافت میکند قابل اعتماد است. یک تور باکیفیت، واقعیتهای تأیید شده را از حدسها به طور صریح جدا میکند.
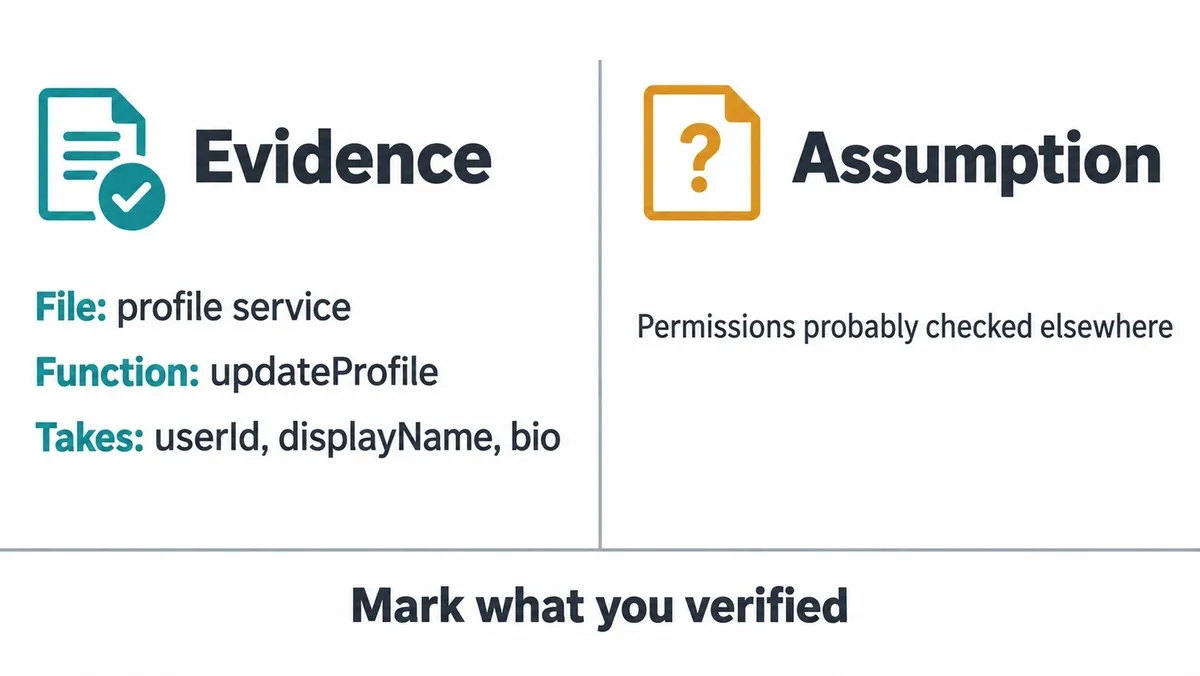
- واقعیتها: نام فایلهایی که باز کردید، امضای توابعی که خواندید و نام متغیرهایی که در کد دیدید. مثال: «دکمه ذخیره در ویرایشگر پروفایل، تابع updateProfile را در سرویس پروفایل فراخوانی میکند».
- فرضها: چیزهایی که از روی یک کامنت، فایل README یا یک الگوی نامگذاری حدس میزنید. مثال: «سرویس احتمالاً مجوزها را بررسی میکند».
هر دو ارزشمند هستند، اما فقط واقعیتها باید هدایتکنندهی ویرایشها باشند. فرضها را به وضوح علامتگذاری کنید. به جای نوشتن «مجوزها در لایههای بالایی مدیریت میشوند»، بنویسید «بررسی مجوز را پیدا نکردم؛ ممکن است جای دیگری باشد یا اصلاً وجود نداشته باشد». مدل باید بداند شما چه چیزی را تأیید کردهاید و از چه چیزی عبور کردهاید.
نام توابع و ورودیهای آنها بسیار قابل اعتماد هستند. اگر تابع updateProfile یک شناسه کاربر، یک نام نمایشی، یک بیوگرافی کوتاه و یک ارجاع به عکس میگیرد، آنها را لیست کنید. اگر یک شیء شامل پرچم موفقیت و لیستی از خطاها برمیگرداند، ساختار را یادداشت کنید. اگر فراخوانی ذخیرهسازی، فیلدهای خاصی را بر اساس شناسه بهروز میکند، این الگو را توصیف کنید. این جزئیات، مدل را به قراردادهای واقعی پروژه شما گره میزند، نه به مثالهای عمومی که در زمان آموزش دیده است.
کامنتها و مستندات در اولویت دوم هستند. کامنتی که میگوید «فرمت ایمیل را بررسی میکند» یک ادعاست؛ اما بدنه تابع، یک دلیل و مدرک است. اگر کامنت با کد در تضاد است، به کد اعتماد کنید و این عدم تطابق را یادداشت کنید. اگر مستندات پروژه قابلیتی را توصیف میکنند که با رفتاری که ردیابی کردید همخوانی ندارد، آن را بنویسید. اطلاعات متناقض اغلب نشان میدهند که تغییر در کجا باعث شکست انتظارات میشود.
بهرهگیری از حفاظهای موجود
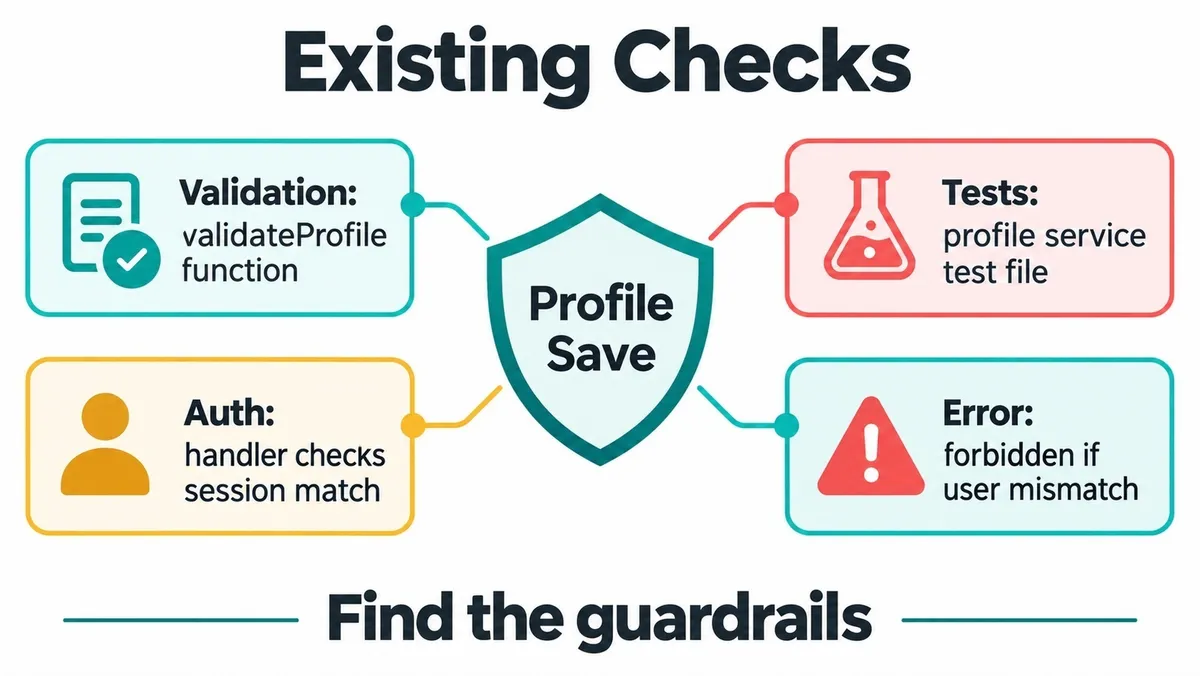
اعتبارسنجیها، شاخههای خطا و تستهای موجود، ارزشمندترین شواهد در یک تور هستند، زیرا لبههای مورد انتظار (Edge Cases) نویسنده اصلی کد را نشان میدهند.
- تستها: تستی با نام «رد کردن بیوگرافیهای طولانیتر از ۵۰۰ کاراکتر» به شما میگوید که یک محدودیت طول وجود دارد. فایل تست و مواردی (Cases) که این قابلیت را میسنجند اضافه کنید.
- اعتبارسنجی: روتینی که بررسی میکند نام نمایشگر حداقل یک کاراکتر داشته باشد، نشان میدهد نامهای خالی مسدود هستند. فایل، تابع و شرط را یادداشت کنید.
- مدیریت خطا: هندلری که در صورت عدم تطابق شناسه با نشست (Session)، وضعیت Forbidden برمیگرداند، نشان میدهد کد مالکیت (Ownership) را اجرا میکند.
اگر پروژه تست ندارد، ذکر این نبودن نیز به همان اندازه حیاتی است. نبودِ تست، نقص در تور شما نیست؛ بلکه اطلاعاتی است که AI نیاز دارد تا یا از سبک موجود پیروی کند یا شکافهای پوشش تست را گوشزد کند.
پیامهای خطا شکل دیگری از شواهد هستند. اگر سیستم برمیگرداند «نام نمایشی الزامی است»، میدانید اعتبارسنجی در سرور اجرا میشود و با کاربر مواجه میگردد. اگر یک ورودی Log میگوید بهروزرسانی پروفایل شکست خورد، میدانید شکستها ردیابی میشوند. اگر مدیریت خطایی وجود ندارد، کد ممکن است به یک مقدار پیشفرض تکیه کند یا در سکوت شکست بخورد. این بررسیها همچنین مرز تغییرات ایمن را مشخص میکنند؛ اضافه کردن یک فیلد به ساختاری که در حال حاضر فیلدهای دیگر را اعتبارسنجی میکند، ریسک پایینی دارد اگر همان الگو را دنبال کنید.
ایجاد یادداشت تحویل (Handoff Note)
پس از تکمیل ردیابی، اطلاعات باید در یک یادداشت ساختاریافته خلاصه شوند. این یادداشت را طوری بنویسید که انگار برای همکاری مینویسید که ماه آینده باید تغییر مشابهی ایجاد کند. از بولتپوینت استفاده کنید و حجم آن را زیر یک صفحه نگه دارید.
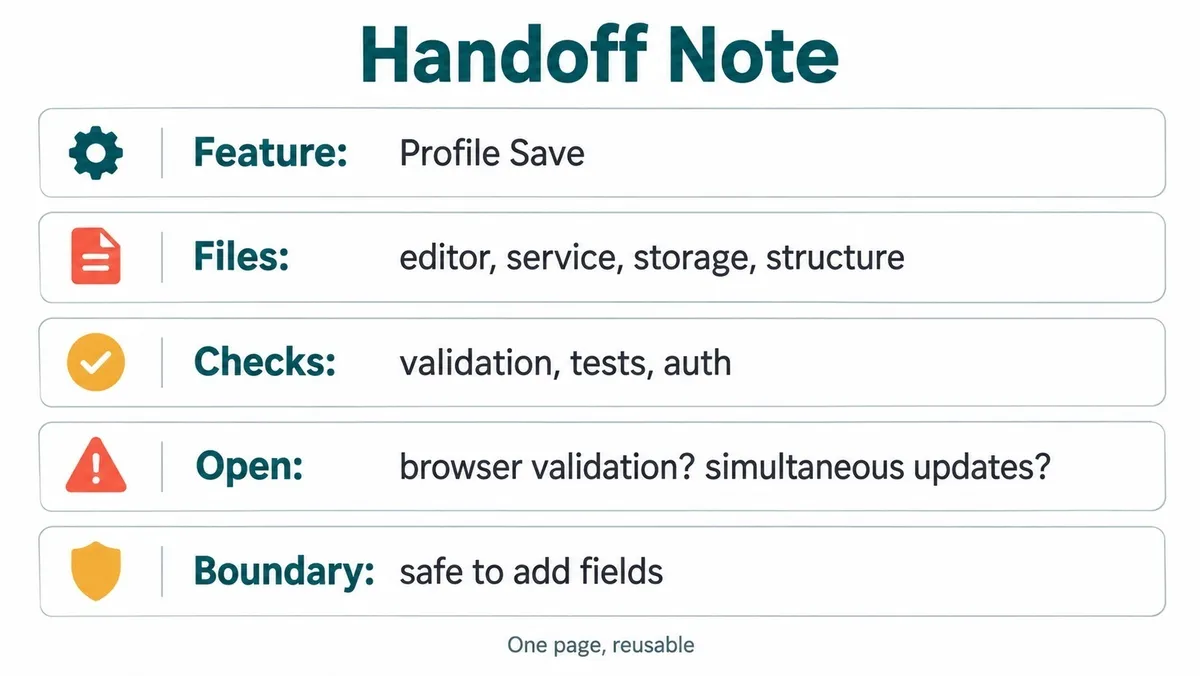
یک یادداشت استاندارد شامل نام قابلیت، جریان فایلها، تعاریف ساختار داده، بررسیهای موجود و پرسشهای باز است. پرسشهای باز — مانند «مقدار قدیمی قبل از بهروزرسانی کجا ثبت میشود؟» یا «اگر دو نفر همزمان یک پروفایل را ذخیره کنند چه اتفاقی میافتد؟» — حیاتی هستند زیرا نقاط کور را آشکار کرده و مناطقی را که نیاز به بررسی دارند برجسته میکنند.
اگر بخواهید فیلد «مکان» را به پروفایل اضافه کنید، تور ممکن است نشان دهد که به تغییر در ذخیرهسازی، یک قانون اعتبارسنجی، بهروزرسانی فرمت پاسخ، رفرش دادههای موقت و یک برچسب جدید در رابط کاربری نیاز دارید. تفکیک گامهای ساده از تصمیمات طراحی، زمانی راحتتر است که لیست کنید چه چیزهایی را نمیدانید. هوش مصنوعی اگر بداند شما نامطمئن هستید، پیشنهادات خود را مشروط میکند؛ اما اگر فکر کند شما بستر کاملی دارید، با اطمینان لایه اشتباهی را ویرایش میکند.
پیادهسازی پرامپت AI
برای استفاده از تور، یادداشت تحویل را به همراه تغییر مورد نظر و محدودیتهای خاص در پرامپت قرار دهید.
ساختار پیشنهادی پرامپت:
«من نیاز دارم [توضیح تغییر] را در این قابلیت اعمال کنم. این تور کد است: [جایگذاری یادداشت]. الزامات: [لیست رفتارها، محدودیتها یا لبههای خاص]. از الگوهای اعتبارسنجی و خطای موجود پیروی کن. تستها را در [نام فایل تست] بهروز کن. تغییرات هر فایل را نشان بده و هر چیزی که الگوی موجود را میشکند یا وابستگی جدیدی اضافه میکند توضیح بده».
این کار باعث میشود مدل محاسبات (Compute) خود را صرف منطق تغییر کند، نه حدس زدن ساختار پروژه. به جای پرسیدن «چطور فیلد مکان را اضافه کنم» و امید داشتن به اینکه AI فایلهای درست را پیدا کند، به او میگویید ذخیره کجا اتفاق میافتد و چه بررسیهایی وجود دارد.
برای تغییرات حساس، اجرای یک تور در دو مدل مختلف میتواند به عنوان بررسی متقابل عمل کند. اگر یک مدل استدلالی (Reasoning Model) — مدلی که قبل از جواب درنگ میکند و مثل شطرنجباز چند حرکت جلوتر را میبیند — یک اعتبارسنجی فراموششده را شناسایی کند که مدلهای تکمیلی نادیده گرفتهاند، یعنی تور نیاز به جزئیات بیشتری دارد. یک مدل استدلالی سوالات شفافکننده میپرسد، در حالی که یک مدل تکمیلی شکافها را با الگوهای رایج پر میکند.
مدیریت این پرامپتها در مدلهای مختلف میتواند هزینهبر باشد. ابزارهایی مانند TTVIBE دسترسی یکپارچه به مدلهایی مثل GPT، Claude، Grok، Gemini، Kimi، DeepSeek و GLM را با قیمتگذاری شفاف و محدودیتهای هزینه فراهم میکنند. کاربران میتوانند حفاظت از قیمت را فعال کرده و سوابق مصرف را بررسی کنند. این دسترسی میتواند هزینهها را تا بیش از ۹۰ درصد نسبت به قیمتهای مستقیم کاهش دهد، هرچند نرخها متفاوت است. این امر مقایسه خروجیها را بدون جابجایی بین حسابها آسان میکند.
تعریف مرز تغییر
آخرین حفاظ، «مرز تغییر» است. تغییری را تعریف کنید که فقط فایلهای نقشهبرداری شده را لمس کند. اگر تور ۵ فایل را پوشش داده، ویرایش AI نیز باید روی ۵ فایل یا کمتر اثر بگذارد. اگر AI پیشنهاد تغییر در لایه احراز هویت یا ابزارهای لاگگیری (که در تور نبودند) داد، یعنی از مرز خارج شده است.
این مرز از گسترش بیرویه دامنه (Scope Creep) جلوگیری کرده و بازبینی انسانی را سریعتر میکند. یک توسعهدهنده که ذخیره پروفایل را ردیابی میکند، ممکن است متوجه شود فیلد ایمیل متفاوت از نام اعتبارسنجی میشود؛ در حالی که این موضوع شایسته یک تور دوم و یک تغییر دوم است، اما نباید در تغییر اول باشد. ترکیب آنها منجر به یک نقشه نامنظم و ویرایشهای ریسکی میشود.
یک Pull Request که همراه با تور کد اصلی باشد، به بازبین اجازه میدهد تأیید کند که کار دقیقاً طبق مسیر مستند شده پیش رفته، هیچ فایل نامرتبطی لمس نشده و پرسشهای باز پاسخ داده شدهاند. بازبینی از «این کد چه میکند» به «آیا این با برنامه مطابقت دارد» تغییر میکند.
با ساخت کتابخانهای از این تورها، تیمها میتوانند توسعهدهندگان جدید و دستیارهای AI را سریعتر جذب کنند. تور زمانی کامل است که بتوانید پیش از نوشتن کد توسط AI، تغییرات را ترسیم کنید. اگر بدانید مدل ساختار داده، تابع اعتبارسنجی، کامپوننت فرم، فراخوانی ذخیرهسازی و فایل تست را ویرایش میکند، میتوانید خروجی AI را با طرح خود مقایسه کنید. ویرایشهای منطبق احتمالاً ایمن هستند و ویرایشهای غیرمنتظره یا اشتباه هستند یا نشاندهنده شکاف در تور. این تورها جایگزین مستندات معماری نیستند، بلکه لایه گمشده بین «این پروژه است» و «این تغییر را اعمال کن» هستند.
گام بعدی شما
- برای پیچیدهترین قابلیت پروژه خود، یک تور کد ۵ فایلی بنویسید و آن را با پرامپت پیشنهادی تست کنید.
- در Pull Requestهای خود، تور کدی که برای هدایت AI استفاده کردید را ضمیمه کنید تا بازبینی کد سریعتر شود.
- تفاوت پاسخ یک مدل استدلالی و یک مدل تکمیلی را روی یک تور کد مشابه مقایسه کنید تا نقاط کور پروژه را بیابید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو