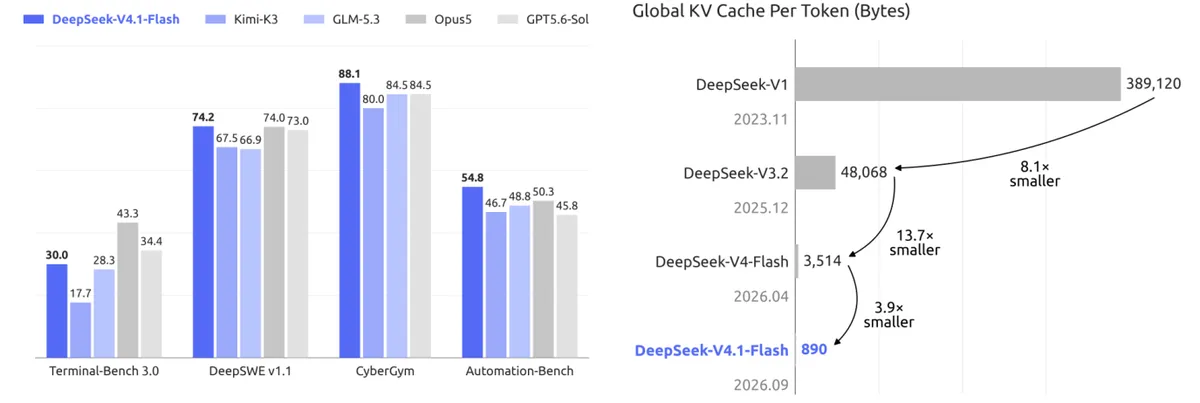
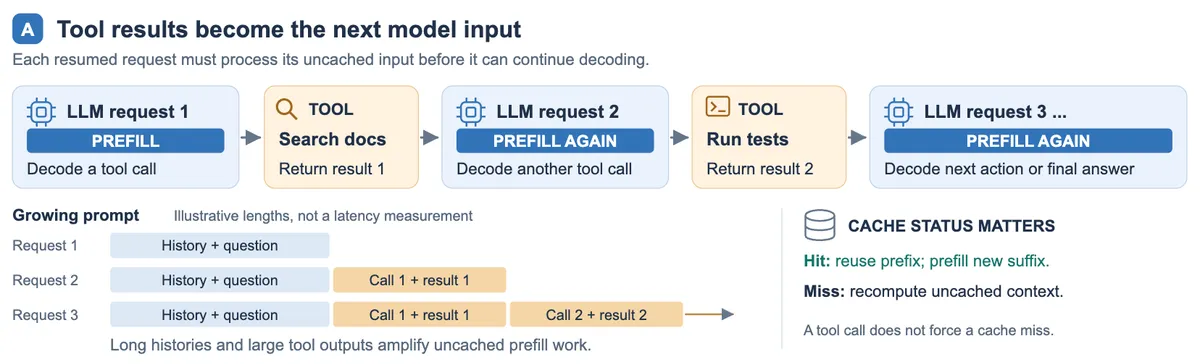
اگر امروز برای اجرای عاملهای هوش مصنوعی با محدودیت حافظه VRAM دستوپنجه نرم میکنید، خبر خوب این است که گلوگاه ذخیرهسازی در حال فروپاشی است. DeepSeek با انتشار گزارش فنی مدل DeepSeek-V4.1-Flash ثابت کرد که میتوان بدون افت کیفیت، ردپای حافظه را به کسری از حالت پیشین رساند. گلوگاه اصلی برای عاملهای هوش مصنوعی با افق زمانی طولانی، تنها قدرت پردازشی خام نیست، بلکه فشار خردکننده ذخیرهسازی KV Cache در حافظههای HBM و SSD است.
طبق اعلام این شرکت، مدل جدید توانسته است فضای مورد نیاز برای KV Cache (حافظه کلید-مقدار) در زمان اجرا را به ۱/۴ و در ذخیرهسازی دائمی به ۱/۸ مدل نسل قبل (V4-Flash) کاهش دهد. این دستاورد در حالی رخ میدهد که مدلهای مدرن در جریانهای کاری عاملمحور، بهدلیل فراخوانیهای مکرر ابزار و رشد سریع زمینه، با فشار شدید در حافظههای HBM (حافظه پهنایباند بالا) و SSD مواجه میشوند که معمولاً مقیاسپذیری را بهدلیل محدودیتهای حافظه غیرممکن میکند. در همین راستا، راهکارهای سختافزاری جدیدی مانند پلتفرم FX100 با مدیریت لایهای حافظه KV تلاش کردهاند تا توان عملیاتی استنتاج را با بهینهسازی مشابه در لایههای ذخیرهسازی افزایش دهند.
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی استنتاج در مدلهای بازمتن اشاره کردیم، صنعت اکنون از مرحلهی بهینهسازی صرفِ محاسبات عبور کرده و وارد نبرد بر سر «جابهجایی دادهها» شده است؛ جایی که ذخیرهسازی دائمی حافظه پنهان، هزینه استنتاج را تعیین میکند. مدل V4.1-Flash با پشتیبانی بومی از پنجره متنی ۱ میلیون توکنی و مقیاس ۵۵۲ میلیارد پارامتر (شامل پارامترهای بدنه و پارامترهای Engram)، پاسخی ساختاری به این بحران است.
معماری رمزگذار-رمزگشای علی (CED)
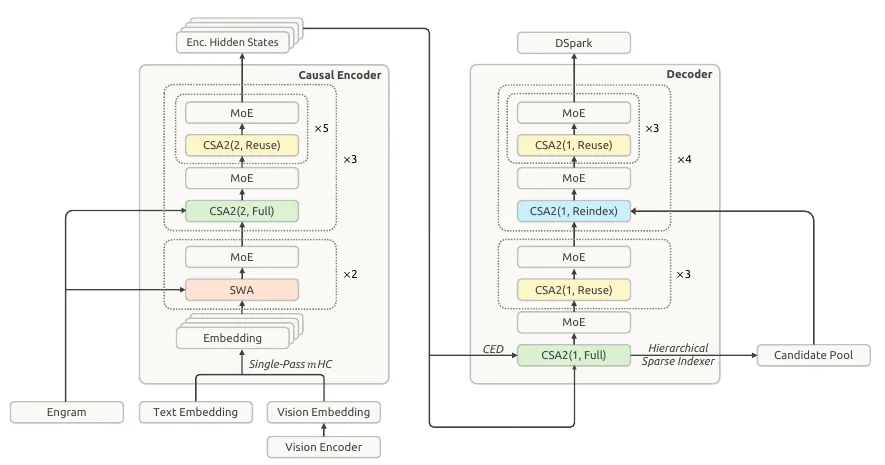
مرکز این تحول، معماری Causal Encoder-Decoder (CED) است که از چارچوب YoCo الهام گرفته شده است. در این ساختار، بهجای آنکه هر لایه حافظه KV خود را تولید کند، ۴۰ لایه مدل به دو بخش تقسیم شدهاند:
- رمزگذار علی (لایههای ۱ تا ۲۰): این لایهها حافظه جهانی را میسازند. دو لایه نخست از SWA (توجه پنجره لغزان) و ۱۸ لایه بعدی از مکانیزم CSA2 استفاده میکنند.
- رمزگشا (لایههای ۲۱ تا ۴۰): این لایهها حافظه KV مستقل تولید نمیکنند، بلکه حالت پنهان نهایی رمزگذار ($h_{20}$) را با استفاده از وزنهای تصویرسازی وابسته به لایه ($W_K^l, W_V^l$) به حافظه KV تبدیل میکنند.
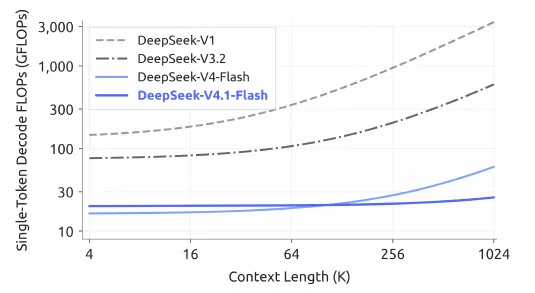
بر اساس مستندات فنی، این طراحی محاسبات مرحله Prefill (پیشپُرکردن) را تقریباً نصف میکند. برای یک شروع سرد (Cold-start) در پرامپتهای طولانی، کل محاسبات کاهش مییابد زیرا رمزگشا تنها نیاز به پردازش موقعیتهای انتهایی (Tail positions) دارد. بهطور مشخص، مدل در زمان پیشپُرکردن تنها ۸ میلیارد پارامتر و در زمان رمزگشایی ۱۶ میلیارد پارامتر را به ازای هر توکن فعال میکند. برای پرامپتی به طول $N$، پیچیدگی از $40N$ به حدود $20N + \text{tail replay}$ کاهش مییابد. برای مثال، در یک پرامپت ۱ میلیون توکنی، محاسبات بهجای ۴۰ میلیون لایه-توکن، به حدود ۲۰ میلیون کاهش مییابد.
برای جبران فقدان حالت محلی در رمزگشا، دیپسیک از روش «بازپخش محدود SWA در رمزگشا» (Decoder SWA Bounded Replay) استفاده کرده است. از آنجایی که لایههای رمزگشا در پیشپُرکردن اصلی نادیده گرفته میشوند، حافظه KV محلی SWA برای آنها وجود ندارد. اگرچه بازیابی دقیق نیازمند ردیابی $L \times W$ موقعیت است (که $L$ عمق رمزگشا و $W$ اندازه پنجره است)، دیپسیک این بازپخش را به جدیدترین موقعیتها محدود کرده است. این کار مانع از آن میشود که هزینه بازیابی وضعیت، مزایای خروج زودهنگام از محاسبات را بهویژه در تعاملات چند-دوری عاملها (که ورودی جدید کوتاه اما تاریخچه طولانی است) از بین ببرد.
CSA2: فشردهسازی چندبعدی
در حالی که CED محاسبات را بهینه میکند، مکانیزم CSA2 (توجه پراکنده فشرده ۲) بر ذخیرهسازی تمرکز دارد. دیپسیک در V4.1-Flash ردپای حافظه KV Cache را از سه بعد ضربی مورد حمله قرار داده است:
- بعد کانال: استفاده از یک بردار نهان ۵۱۲-بعدی برای اشتراک نمایشها بین سرهای توجه. در اینجا RoPE ۶۴-بعدی و NoPE ۴۴۸-بعدی است و Q از یک تصویرسازی کمرتبه با رتبه ۱۲۸۰ استفاده میکند.
- بعد توالی: رمزگذار دو موقعیت مجاور را با استفاده از وزنهای یادگرفتهشده در سطح کانال در یک ورودی حافظه ادغام میکند (نسبت فشردهسازی ۲)، در حالی که رمزگشا ورودیهای هر موقعیت را حفظ میکند (نسبت ۱).
- بعد لایه: چندین لایه از یک حافظه KV جهانی مشترک استفاده میکنند. شبکه تنها سه نسخه از حافظه رمزگذار و یک نسخه از رمزگشا را نگه میدارد.
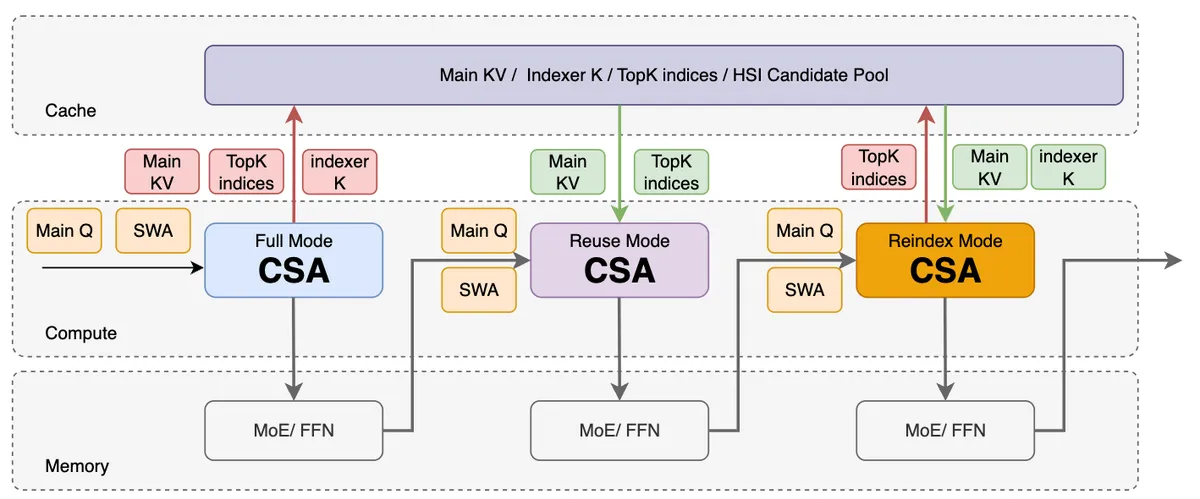
این بازاستفاده از لایهها در سه حالت عملیاتی مدیریت میشود:
- حالت کامل (Full Mode): لایه، Main KV، Indexer Q و Indexer K خود را محاسبه کرده و شاخصهای Top-K جدیدی تولید میکند. این مسیر کامل CSA2 است.
- حالت باز-اندکس (Reindex Mode): لایه از Main KV و Indexer K لایه قبلی استفاده میکند اما Indexer Q خود را محاسبه میکند تا شاخصهای Top-K جدیدی بسازد. این کار اجازه میدهد انتخابهای پراکنده در لایههای مختلف متفاوت باشد.
- حالت بازاستفاده (Reuse Mode): لایه هم Main KV و هم شاخصهای Top-K را از یک لایه قبلی (کامل یا باز-اندکس) به ارث میبرد و تنها پرسوجو (Q) را تغییر میدهد.
اندکسکننده پراکنده سلسلهمراتبی (HSI)
برای جلوگیری از تبدیل شدن فرآیند اندکسگذاری به گلوگاه جدید در زمینههای فوقطولانی، سیستم HSI معرفی شده است. این سیستم از رویکرد «فیلتر کردن در سطح بلوک» استفاده میکند تا سربار امتیازدهی به تمام زمینههای قابل مشاهده را کاهش دهد.
مکانیزم HSI به شرح زیر است:
- ساخت استخر کاندیدا: اولین لایه در حالت Full Mode در رمزگشا، تمام موقعیتها را امتیازدهی میکند. سپس یک کاهش حداکثر-بلوکی (اندازه بلوک = ۸) انجام میدهد تا ۲۰۴۸ بلوک برتر را انتخاب کند. این کار استخری از حداکثر ۱۶,۳۸۴ موقعیت ایجاد میکند.
- جستوجوی محدود: لایههای بعدی در حالت Reindex Mode بهجای جستوجو در کل تاریخچه ۱ میلیون توکنی، تنها موقعیتهای داخل این استخر کاندیدا را امتیازدهی میکنند. تعداد نهایی Top-K برابر ۵۱۲ است.
- آگاهی از آموزش: HSI در مرحله پس-آموزش (Post-training) معرفی میشود. مدل بهگونهای آموزش میبیند که اندکسکنندههای لایههای عمیق بهطور خاص برای دامنه جستوجوی محدودی که در زمان استنتاج استفاده میشود، بهینه شوند تا از عدم تطابق توزیع جلوگیری شود. این احتمالاً شامل یک تابع زیان ترکیبی از تطبیق بدنه و تقطیر (Distillation) اندکسکننده است.
این تغییر، هزینه هر پرسوجو برای اندکسگذاری لایههای عمیق را از رشد خطی نسبت به طول زمینه، به یک سربار ثابت تبدیل میکند.
ادغام چندوجهی و حافظه
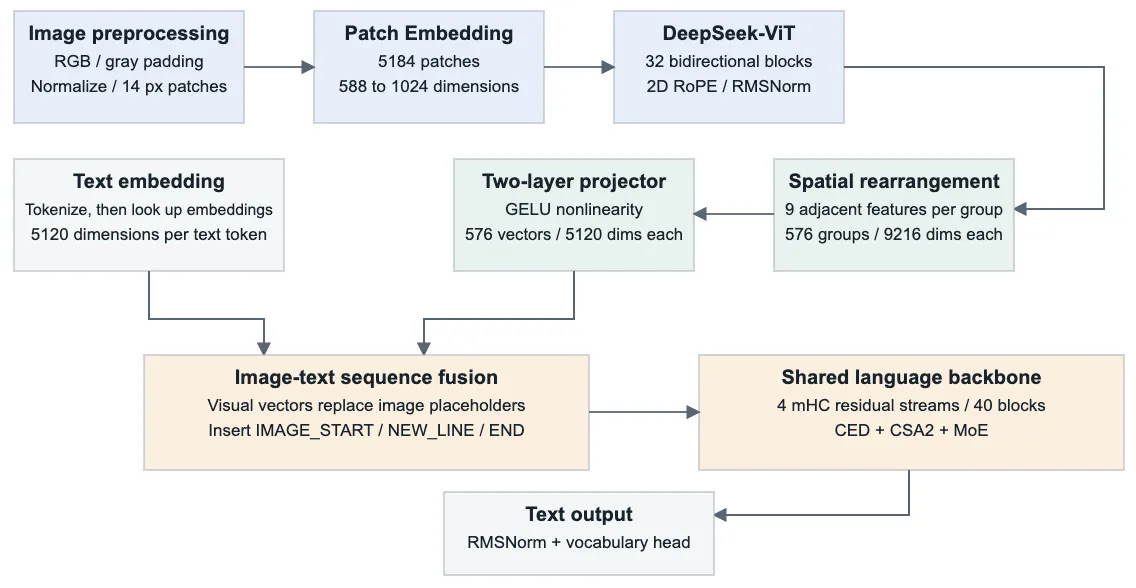
مدل DeepSeek-V4.1-Flash بهصورت بومی چندوجهی است. مسیر بینایی آن از یک ViT ۳۲-لایه با بعد پنهان ۱۰۲۴ و اندازه پچ ۱۴ استفاده میکند.
خط لوله پردازش بینایی:
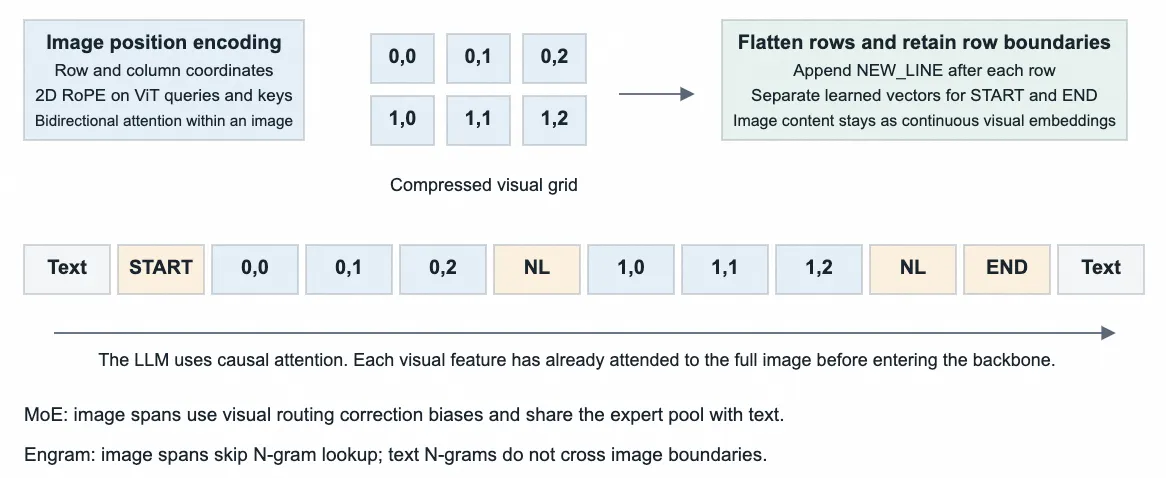
- پیشپردازش: تصاویر به مضاربی از ۱۴ تغییر اندازه یا پد شده میشوند. اگر مساحت اصلی زیر یک آستانه باشد، مقیاس آن افزایش مییابد. بودجه حداکثری ۱۰۲۴ توکن بصری برای هر تصویر است. برای یک تصویر ۱۰۰۸x۱۰۰۸، این مقدار منجر به ۹۹۴ توکن (شامل تگها) میشود.
- رمزگذاری: ViT تعاملات درون-تصویری را انجام میدهد. از 2D RoPE برای Q و K استفاده میشود. هر لایه شامل RMSNorm، توجه و یک شبکه پیشخور SwiGLU است که به ۲۰۴۸ بعد تصویرسازی میکند.
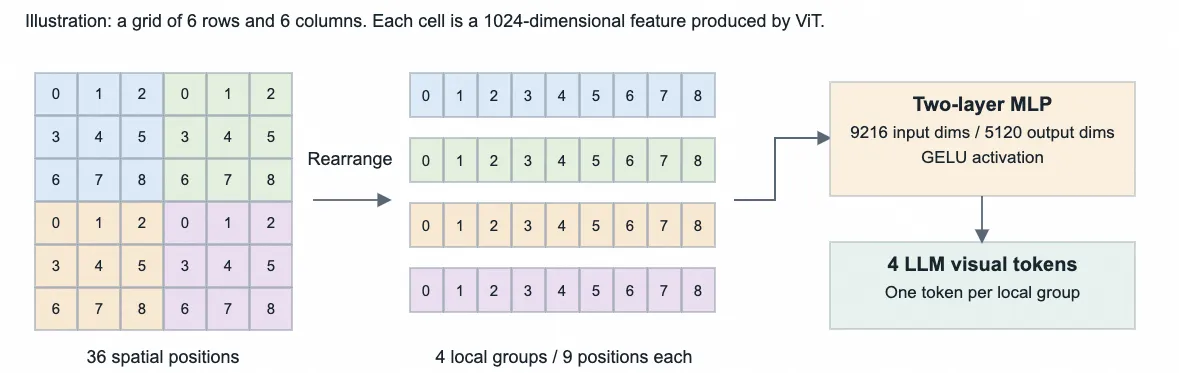
- بازآرایی فضایی: یک نرخ کاهشنمونه ۳x۳ اعمال میشود که ۹ ویژگی مجاور را در یک بردار عریض ادغام کرده و تعداد توکنها را ۹ برابر کاهش میدهد.
- تصویرسازی: یک MLP دو-لایه (Linear, GELU, Linear) ویژگیها را به فضای ۵۱۲۰-بعدی بدنه زبانی منتقل میکند.
برای تضمین پایداری، تیم از توازن بار بدون زیان کمکی (Auxiliary-loss-free load balancing) برای MoE استفاده کرده است. از آنجایی که توکنهای تصویر و متن توزیعهای متفاوتی دارند، ممکن است خبرههای متفاوتی را ترجیح دهند. دیپسیک برای هر مودالیته، بایاسهای اصلاحی مجزایی برای هر خبره نگه میدارد که پس از هر گام آموزشی بهطور مستقل بهروزرسانی میشوند تا استفاده متوازن از خبرهها تضمین شود.
علاوه بر این، مدل حافظه شرطی Engram را در لایههای ۱ و ۱۴ ادغام کرده است. Engram از مرتبههای N-gram (۲، ۳ و ۴) برای کدگذاری الگوهای تکراری عبارات در یک جدول پارامتری عظیم (حدود ۱۶ میلیون ورودی برای هر جدول) استفاده میکند.
- مکانیزم: این سیستم جستوجوی جدول هش (Hash table lookup) را برای N-gramهایی که در موقعیت فعلی پایان مییابند، انجام میدهد. هر مرتبه شامل ۸ سر هش با مجموع بعد جاسازی ۲۰۴۸ است.
- ادغام: اولین لایه SWA گیتینگ زمینهای را برای Engram فراهم میکند و دومین لایه SWA نمایشهای تقویتشده با Engram را ادغام میکند. این کار میدان پذیرش را پیش از شروع CSA2 به ۲۵۶ توکن ($2 \times 128$) گسترش میدهد.
- بهرهوری: آدرسدهی قطعی اجازه میدهد تا جاسازیها از طریق انتقالات پسزمینه RDMA از حافظه میزبان پیشخوانی شوند و با محاسبات اولین بلوک ترنسفورمر همپوشانی داشته باشند.
دقت عددی و بهرهوری سختافزاری
ذخیرهسازی با استفاده از کوانتش FP4 برای Main KV Cache بیشتر فشرده شده است. با پذیرش فرمت MXFP4 استاندارد OCP (E2M1)، دیپسیک ردپای ذخیرهسازی در HBM و SSD را در مقایسه با FP8 که در V4 استفاده شده بود، بهشدت کاهش داد.
برای حفظ دقت، مدل از یک ضریب مقیاس برای هر ۱۶ کانال استفاده میکند. از آنجایی که حداکثر مقدار متغیر نهان KV توسط RMSNorm محدود شده است، تیم توانست ضریب مقیاس جهانی سطح دوم را بدون افت کیفیت محسوس حذف کند.
در نهایت، مدل از رمزگشایی گمانهزنانه DSpark برای شتابدهی به استنتاج استفاده میکند. این رویکرد مشابه بهینهسازیهای DSpark در مدلهای Liquid AI است که با پیشبینی موازی توکنها، سرعت پاسخدهی را در سختافزارهای محلی بهشدت افزایش میدهد.
- مدل پیشنویس: شامل سه بلوک ترنسفورمر با پنجره لغزان ۱۲۸ توکنی و یک MoE مقیاس کوچک (Top-3 از ۱۲۸ خبره) است.
- پیشبینی موازی: این مدل ۵ موقعیت پیشنویس را بهطور موازی محاسبه میکند و از یک سر مارکوف برای مدلسازی وابستگیها و یک سر اعتماد (Confidence head) برای تصمیمگیری درباره طول تاییدیه استفاده میکند.
- آموزش: DSpark در یک مرحله اختصاصی با بدنه منجمد آموزش دیده و سپس در مرحله پس-آموزش بهطور مشترک تنظیم (Fine-tune) شده است، بدون اینکه گرادیانها به بدنه بازگردند.
نتیجه نهایی: ۸۹۰ بایت به ازای هر توکن
وقتی تمام این بهینهسازیها — CED، CSA2، HSI و FP4 — ترکیب شوند، ذخیرهسازی جهانی KV Cache به حدود ۸۹۰ بایت به ازای هر توکن کاهش مییابد. این یک کاهش عظیم نسبت به هزاران بایتی است که در معماریهای لایه-مستقل مورد نیاز بود.
این بهرهوری با تبدیل ۴۱ منبع ذخیرهسازی مستقل (در V4-Flash) به تنها ۴ منبع ذخیرهسازی اصلی از طریق بازاستفاده بین-لایهای و کوانتش FP4 حاصل شده است. معماری کلی مدل توسط پارامترهای کلیدی زیر خلاصه میشود:
- بعد پنهان: ۵۱۲۰
- لایهها: ۴۰ (۲۰ رمزگذار / ۲۰ رمزگشا)
- MoE: ۳۸۴ خبره مسیریابی شده، ۶ خبره فعال به ازای هر توکن
- اندازه واژگان: ۱۲۹,۲۸۰
- mHC: ۴ جریان باقیمانده با تکرارهای Sinkhorn برای ترکیب دو-استوکاستیک.
این تغییر، فرض بنیادی ارائه خدمات زمینه-طولانی را تغییر میدهد. این ثابت میکند که میتوانیم کیفیت بالای تکمیل وظایف را حفظ کنیم در حالی که با ترنسفورمر نه به عنوان مجموعهای از لایههای مستقل، بلکه به عنوان یک معماری بازگشتی که پرسوجوها را تغییر میدهد در حالی که از یک وضعیت حافظه فشرده و مشترک استفاده میکند، برخورد کنیم.
گام بعدی شما
- اگر از مدلهای VLM برای تحلیل اسناد طولانی استفاده میکنید، معماری CED را برای کاهش تأخیر Prefill بررسی کنید.
- برای کاهش هزینههای استنتاج در مقیاس بالا، استانداردهای کوانتش FP4 را در زیرساختهای خود پیادهسازی کنید.
- بررسی کنید که آیا مدلهای فعلی شما از حافظه مشترک بین لایهها استفاده میکنند یا هر لایه حافظه مجزایی میسازد. برای مثال، پیادهسازی حافظه معنایی میتواند با کاهش فراخوانیهای مکرر مدل، فشار روی حافظه را در محیطهای عملیاتی کاهش دهد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell و مدیریت حافظه HBM مراجعه کنید.



گفتگو