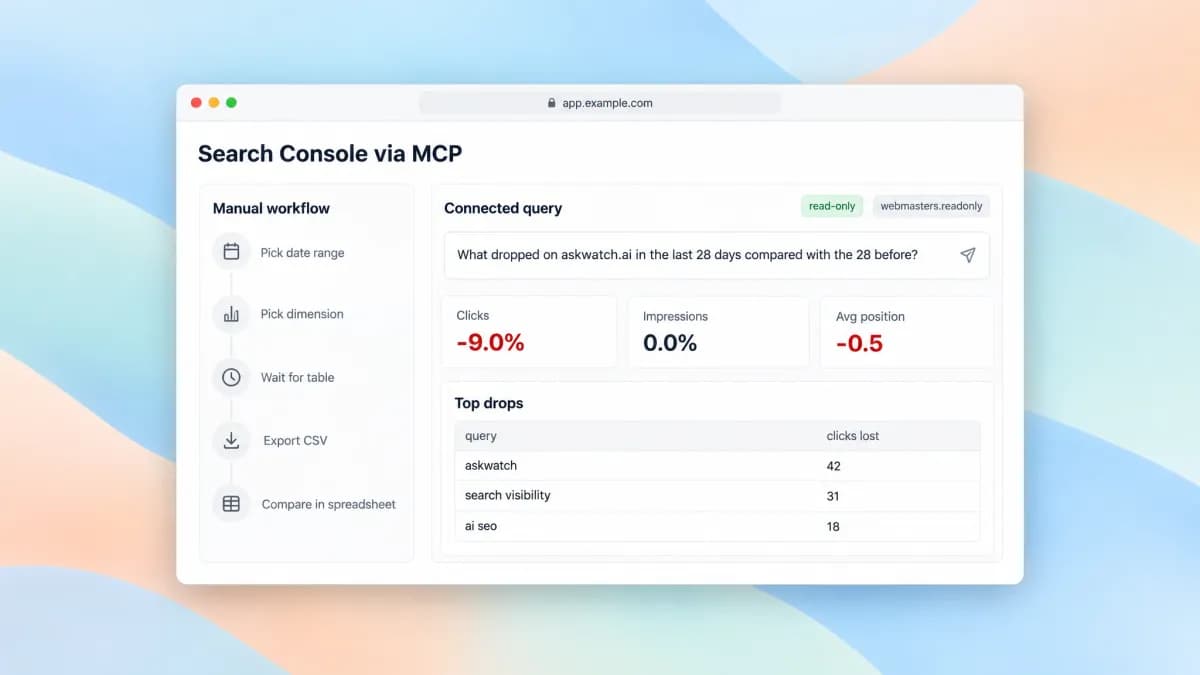
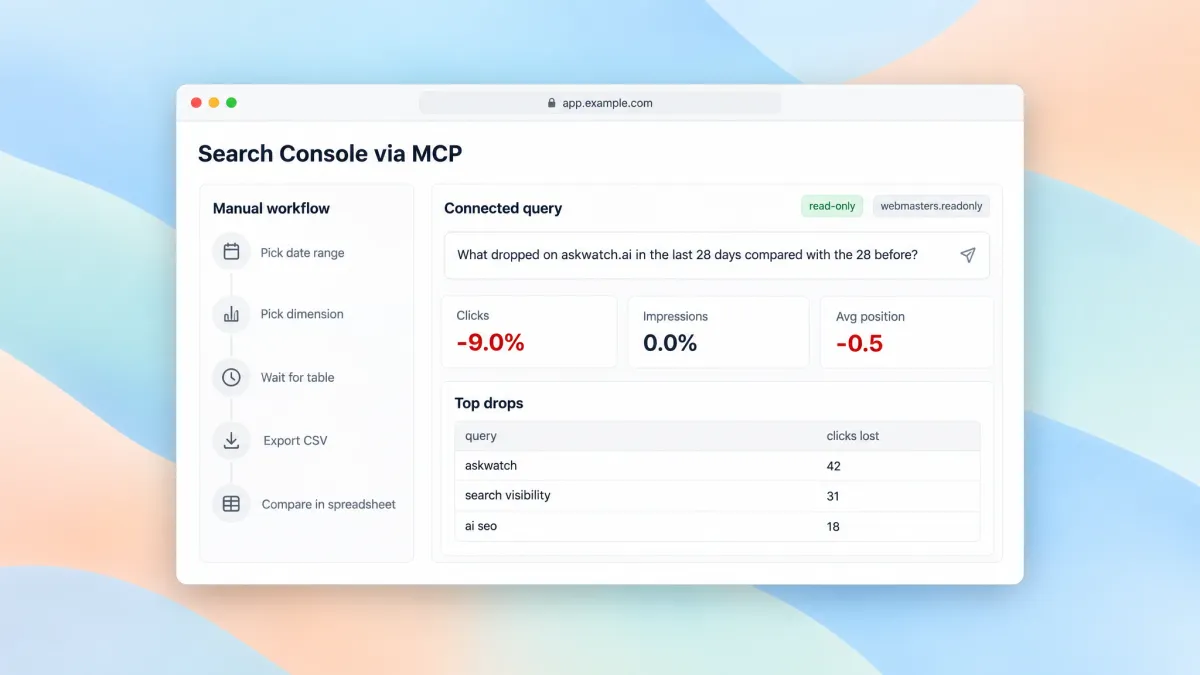
تصور کنید به جای ساعتها کلنجار رفتن با فایلهای اکسل و فیلتر کردن تاریخها، فقط از هوش مصنوعی بپرسید کدام کلمات کلیدی در ۲۸ روز گذشته کلیکهای شما را کاهش دادهاند. این دیگر یک رویای بهرهوری نیست، بلکه نتیجهٔ اتصال مستقیم گوگل سرچ کنسول (Google Search Console) به کلاینتهای هوش مصنوعی است. اتصال مستقیم به سرچ کنسول، فرآیند سئو را از یک عملیات دستی و خستهکننده به یک بازجویی تعاملی تبدیل میکند. در حالت عادی، شما باید بازه زمانی را انتخاب کنید، ابعاد را فیلتر کنید، منتظر بارگذاری جدول بمانید، آن را اکسپورت کنید و سپس مقایسهها را شخصاً در یک صفحه گسترده انجام دهید. اما اکنون کلود (Claude)، ChatGPT یا Cursor میتوانند مستقیماً با API سرچ کنسول صحبت کنند و پاسخها را در لحظه به شما بدهند.
سرچ کنسول تنها رکورد دقیقی است که نشان میدهد مردم قبل از ورود به سایت شما دقیقاً چه چیزی را تایپ کردهاند. پروتکل زمینه مدل (MCP) این چرخه تکراری از دانلود و تحلیل دستی را حذف میکند: کلاینت هوش مصنوعی شما مستقیماً با API سرچ کنسول گفتگو میکند و شما درخواستهای خود را به زبان ساده و کلامی بیان میکنید.
این تحول در حالی رخ میدهد که صنعت به سمت گردشکارهای عاملمحور (Agentic) — یعنی سیستمهایی که مثل یک کارمند متخصص، خودشان ابزارها را مدیریت میکنند — حرکت میکند. همانطور که در تحلیل قبلی ما دربارهی چارچوبهای هزینهای عاملهای کدنویس مانند GPT-6.1 Sol و Astra اشاره کردیم، تمرکز فعلی بر این است که به این عاملها دسترسی مستقیم به دادههای اختصاصی کسبوکار داده شود. برای متخصصان سئو، این یعنی هوش مصنوعی دیگر بر اساس یک عکس قدیمی یا استاتیک از دادهها حدس نمیزند، بلکه روی ردیفهای زنده API استدلال میکند.
سازوکار: سرورهای MCP
پل ارتباطی این سیستم، پروتکل زمینهٔ مدل (Model Context Protocol یا MCP) است. یک سرور MCP مانند یک مترجم عمل میکند که اجازه میدهد کلاینت هوش مصنوعی با API سرچ کنسول ارتباط برقرار کند. این قابلیت به ابزارهایی مثل Claude، ChatGPT، Cursor و Claude Code دسترسی مستقیم خواندنی (Read Access) به دادههای سرچ کنسول شما میدهد.
برای پیادهسازی این اتصال، دو مسیر اصلی وجود دارد:
- میزبانی شخصی (mcp-gsc): یک گزینه متنباز که روی سیستم محلی شما اجرا میشود. این سرور ۲۰ ابزار مختلف را ارائه میدهد، از جمله دسترسی نوشتاری (Write-access) برای ارسال و حذف نقشههای سایت (Sitemaps) یا افزودن و حذف پراپرتیها. به طور پیشفرض، عملیات تخریبی غیرفعال هستند مگر اینکه پرچم
GSC_ALLOW_DESTRUCTIVEرا روی true تنظیم کنید. - میزبانی مدیریتشده (AskWatch GSC MCP): یک سرویس مدیریتشده که در آن ارائهدهنده، مجوز گوگل (Google Grant) را در اختیار دارد. این روش نیاز به ایجاد پروژه در گوگل کلاود یا نصب پایتون در سیستم محلی را از بین میبرد. این سرویس رایگان است، فقط محدوده دسترسی
webmasters.readonlyرا درخواست میکند و ۱۱ ابزار خواندنی را ارائه میدهد. نقطه ضعف این روش این است که یک شخص ثالث توکنی را در اختیار دارد که دادههای سرچ کنسول شما را میخواند؛ بنابراین کاربران باید بررسی کنند که این مجوز چگونه ذخیره میشود و چگونه میتوان آن را متوقف کرد.
مراحل راهاندازی اتصال
برای کسانی که مسیر میزبانی شخصی را انتخاب میکنند، راهاندازی حدود ۲۰ دقیقه زمان میبرد و در محیطی انجام میشود که برای توسعهدهندگان طراحی شده است. شما باید مراحل زیر را طی کنید:
۱. ایجاد یک پروژه در گوگل کلاود (Google Cloud Project).
۲. فعالسازی API سرچ کنسول در داخل آن پروژه.
۳. انتخاب بین متد OAuth یا حساب خدماتی (Service Account).
۴. دانلود فایل اعتبارنامهها (Credentials) و ذخیره دائمی آن.
۵. نصب پایتون نسخه ۳.۱۱ یا جدیدتر.
۶. تنظیم فایل کانفیگ کلاینت برای اشاره به هر دو مورد: سرور و فایل اعتبارنامهها.
در مقابل، تنظیمات میزبانیشده بسیار سریعتر است. کاربران حساب گوگل خود را در صفحه ابزار متصل میکنند، جایی که صفحه رضایت (Consent Screen) فقط دسترسی خواندنی به سرچ کنسول را درخواست میکند و هیچ چیز دیگر را. پس از کپی کردن یک لینک شخصی، کاربر آن را در تنظیمات کانکتور کلاینت هوش مصنوعی خود جایگذاری میکند.
در Claude Code، این کار با یک دستور ساده انجام میشود:claude mcp add --transport http askwatch-gsc https://mcp.askwatch.ai/gsc/YOUR_KEY
سایر کلاینتها مانند Cursor، VS Code، Codex، Windsurf و Gemini CLI نیز همین آدرس را در فایلهای کانفیگ خاص خود دریافت میکنند.
قدرت پرسوجوهای تکرارشونده
وقتی اتصال برقرار شود، هوش مصنوعی به جای جلسات طولانی، روی پرسشهای تکمرحلهای تمرکز میکند. شما میتوانید بپرسید: «کدام کوئریها رتبهای بین ۵ تا ۲۰ دارند اما نمایش (Impression) زیادی دارند ولی نرخ کلیک (CTR) آنها پایینتر از حد نرمال برای آن رتبه است؟» یا «کدام یک از صفحات من برای یک جستجوی مشابه با هم رقابت میکنند؟» یا «آیا این URL ایندکس شده است و گوگل کدام نسخه را به عنوان نسخه اصلی (Canonical) انتخاب کرده است؟»
ارزش واقعی این ادغام در «هزینهٔ پرسش دوم» است. یک بررسی ۱۵ دقیقهای اکنون به یک زنجیره منطقی تبدیل میشود بدون اینکه شما رابط چت را ترک کنید:
۱. روند کلی: «وضعیت سایت در ۲۸ روز گذشته چطور بود؟» (مثال نتیجه: کلیکها ۹٪ کاهش یافته، نمایشها ثابت است و رتبه میانگین نیم رتبه افت کرده است. این نتیجه سقوط دیدهشدن سایت را رد میکند و انگشت اتهام را به سمت عنوانها یا اسنیپتها میبرد).
۲. جداسازی: «کدام کوئریها بیشترین ریزش کلیک را داشتند؟» (مثال نتیجه: سه کوئری مسئول بخش بزرگی از ریزش هستند که همگی تغییراتی از یک عبارت کلیدی اصلی هستند و هنوز در ۵ رتبه اول قرار دارند).
۳. تحلیل صفحه: «صفحهای که برای این کوئریها رتبه دارد چه وضعیتی دارد؟» (مثال نتیجه: یک صفحه با رتبه ثابت ۳.۲، اما CTR آن از ۶.۱٪ به ۳.۴٪ سقوط کرده است).
۴. یافتن الگو: «کدام کوئریهای دیگر در این سایت رتبهای مشابه دارند و ریزش مشابهی را تجربه کردهاند؟» (مثال نتیجه: هیچکدام. این موضوع علت را به چیدمان SERP محدود میکند، مثلاً ظهور یک AI Overview جدید یا بازنویسی عنوان توسط یک رقیب).
در رابط وب استاندارد سرچ کنسول، این توالی نیاز به چهار بازه زمانی مجزا، چهار فیلتر و سه خروجی CSV داشت. با MCP، مدل روی ردیفهای داده استدلال میکند، بنابراین سوالات تکمیلی (مثلاً «چرا آن صفحه کلیکهایش را از دست داد اما نمایشهایش ثابت ماند؟») روی همان دادهها اجرا میشوند بدون اینکه نیاز به اکسپورت مجدد باشد.
چرا ابزارهای «شکلیافته» بهتر از کوئریهای خام هستند؟
یک سرور میتواند سرچ کنسول را به دو روش ارائه دهد: یا API را مستقیماً عبور میدهد تا مدل خودش کوئری را بنویسد، یا مجموعهای از ابزارهای «شکلیافته» (Shaped Tools) را ارائه میدهد که برای پاسخ به سوالات خاص طراحی شدهاند.
ابزارهای شکلیافته برای ثبات و تکرارپذیری برتر هستند. برای مثال، یک ابزار «بررسی ریزش» میتواند طوری برنامهریزی شود که:
- دو پنجره زمانی با طول برابر را با هم مقایسه کند.
- ردیفهایی با نمایش بسیار کم را که از نظر آماری معنادار نیستند، حذف کند.
- بر اساس ریزش مطلق مرتب کند نه درصد (تا مانع از این شود که کوئریای که از ۲ کلیک به ۱ کلیک رسیده، در صدر لیست قرار گیرد).
در مقابل، مدلی که این کار را از ردیفهای خام انجام میدهد، هر بار روش جدیدی را انتخاب میکند. اگر دوشنبه بپرسید و دوباره پنجشنبه بپرسید، ممکن است دو پاسخ متناقض دریافت کنید بدون اینکه مدل دلیلی برای این تفاوت ذکر کند. ابزارهای شکلیافته همچنین در صورت خطا، مفیدتر عمل میکنند؛ زیرا اعلام میکنند کدام پنجرههای زمانی استفاده شده و کدام ردیفها حذف شدهاند، در حالی که کوئریهای خام هیچ «مراحل محاسباتی» (Working shown) را ارائه نمیدهند.
تلههای دادهای و خطاهای احتمالی
کاربران باید از سه نکته فنی آگاه باشند تا دچار توهم (Hallucination) نشوند و بحرانهای ساختگی را گزارش نکنند:
روزهای ناقص (The Fragmented Day): دادههای سرچ کنسول دیر میرسند و حدود دو روز طول میکشد تا تثبیت شوند. API میتواند ردیفهای نهایی شده یا «هر آنچه تا الان هست» را برگرداند که شامل روزی است که هنوز در حال پر شدن است. در یک تست زنده، گنجاندن روز ناقص باعث شد ریزش کلیکها ۱۱.۷٪ گزارش شود در حالی که ریزش واقعی تنها ۱.۱٪ بود. چون هوش مصنوعی این عدد را به عنوان یک حقیقت میپذیرد، ممکن است توصیههای غلطی بر اساس آن ارائه دهد. کاربران باید در پرامپتهای خود صراحتاً ذکر کنند: «فقط از دادههای نهایی (Finalized data) استفاده کن».
پنجرههای زمانی نامشخص (The Unnamed Window): عبارت «ماه گذشته» میتواند به معنای ماه میلادی قبلی یا ۳۰ روز اخیر باشد. مدلها یکی را انتخاب میکنند و به ندرت فاش میکنند کدام است. این موضوع برای سایتهای B2B حیاتی است؛ مقایسه ۲۸ روز در برابر ۲۸ روز قبلی، ساختار مشابه هفتهها را حفظ میکند، در حالی که ۳۰ روز ممکن است در یک پنجره پنج دوشنبه و در پنجره دیگر چهار دوشنبه داشته باشد و نتایج را منحرف کند.
تفاوت در رشتههای Property: رشتههای پراپرتی، دامنه نیستند. سرچ کنسول دو نوع پراپرتی متمایز دارد:
sc-domain:example.com: تمام سابدومینها و هر دو پروتکل (HTTP/HTTPS) را پوشش میدهد.https://example.com/: دقیقاً همان پیشوند را پوشش میدهد.
سایتی که به هر دو روش تایید شده باشد، دو بار با اعداد متفاوت پاسخ میدهد. کاربران باید همیشه ابتدا «لیست پراپرتیهای سرچ کنسول من» (List my Search Console properties) را بخواهند تا رشتههای دقیقی که API انتظار دارد را دریافت کنند. این موضوع برای آژانسها نیز کمککننده است؛ اگر یک فریلنسر فقط به یکی از پراپرتیها دسترسی داشته باشد، ابزار نمیتواند بین «نبود داده» و «نبود دسترسی» تفاوت قائل شود.
محدودیتها و سهمیهها
دسترسیهای Read-only (webmasters.readonly) بهشدت توسط گوگل کنترل میشوند. فارغ از اینکه پرامپت چگونه نوشته شود، یک اتصال فقط-خواندنی نمیتواند نقشههای سایت را ارسال کند، درخواست ایندکس دهد، URL را حذف کند یا پراپرتی را تغییر دهد. این اقدامات نیازمند یک سرور محلی با دسترسیهای Write هستند.
همچنین ذکر این نکته ضروری است که سرچ کنسول نمیتواند پاسخهای AI را ببیند. این ابزار جستجوی گوگل را ثبت میکند، اما هیچ اطلاعی درباره آنچه ChatGPT، Perplexity یا Gemini به خریداران درباره شما میگویند، نمیدهد. در این راستا، درک دلایل فنی نامرئی شدن وبسایتها برای مدلهای زبانی میتواند به شما کمک کند تا تفاوت بین ترافیک جستجوی سنتی و پاسخهای تولیدی AI را بهتر درک کنید. علاوه بر این، کوئریهای ناشناس (Anonymized queries) از گزارشها حذف میشوند و برخی نماها کوتاه شدهاند. هر پاسخی که مجموع کوئریها را با کل ترافیک برابر بداند، از نظر ریاضی غلط است.
در مورد محدودیتهای API، API بازرسی URL (URL Inspection API) بسیار سختگیرانهتر از دادههای کلی جستجو محدود شده است. عاملی که بخواهد تمام نقشه سایت را از طریق بازرسی URL بررسی کند، سریعاً سهمیه روزانه را تمام میکند. دو عادت به مدیریت این موضوع کمک میکند:
۱. ابتدا لیستی از صفحات اولویتدار را بخواهید و سپس فقط همانها (مثلاً ۱۲ صفحه اول) را بازرسی کنید.
۲. ابزارهایی را ترجیح دهید که قابلیت کش (Cache) دارند. یک سرور میزبانیشده میتواند دادهها را کش کند تا پرسش تکراری در یک بعدازظهر، تنها یک بار هزینه فراخوانی API گوگل را داشته باشد.
سوالات متداول (FAQ)
آیا برای استفاده از سرچ کنسول با کلود به پروژه گوگل کلاود نیاز دارم؟
تنها در صورتی که سرور را خودتان اجرا کنید. یک سرور MCP محلی به عنوان شما احراز هویت میکند و به پروژه کلاود و OAuth کلاینت شما نیاز دارد. یک سرور میزبانیشده، این مجوز را از طریق ورود به حساب گوگل مدیریت میکند.
آیا این قابلیت با ChatGPT هم کار میکند یا فقط کلود؟
با هر دو، و همچنین Cursor، VS Code، Claude Code، Codex، Windsurf و Gemini CLI. تفاوت آنها فقط در فرمت فایلهای کانفیگ است.
آیا کلاینت هوش مصنوعی میتواند به اشتباه چیزی را در سرچ کنسول تغییر دهد؟
از طریق مجوز Read-only خیر. این منع از سوی سیستم کنترل دسترسی خود گوگل اعمال میشود. اما سروری با دسترسی Write میتواند این کار را انجام دهد، به همین دلیل دانستن نوع اتصال شما حیاتی است.
آیا دادهها با رابط کاربری سرچ کنسول یکسان هستند؟
بله، از همان API استفاده میکنند. اختلافات معمولاً ناشی از روز ناقصِ جاری یا حذف کوئریهای ناشناس در ردیفهای سطح کوئری است.
چند پراپرتی را میتوانم کوئری کنم؟
هر تعداد که حساب گوگل وارد شده به آنها دسترسی داشته باشد. با لیست کردن آنها شروع کنید تا مطمئن شوید رشتههای درستی را دارید.
گام بعدی شما
- اگر در حال تست کاربردی بودن هستید، از یک سرور Hosted استفاده کنید و زنجیره چهار پرسشی (روند کلی $ \rightarrow $ جداسازی $ \rightarrow $ تحلیل صفحه $ \rightarrow $ یافتن الگو) را اجرا کنید.
- اگر نتایج استراتژی شما را تغییر داد و به دسترسی Write نیاز داشتید یا ترجیح میدادید اعتبارنامههای خود را در اختیار داشته باشید، به سرور متنباز محلی سوییچ کنید. هر دو از یک API میخوانند؛ تنها تفاوت در این است که توکن نزد چه کسی است و شما چقدر زمان در کنسول گوگل کلاود صرف میکنید.
- در پرامپتهای خود صراحتاً درخواست استفاده از «دادههای نهایی» (Finalized Data) را کنید تا دچار خطای تحلیل در روزهای جاری نشوید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو