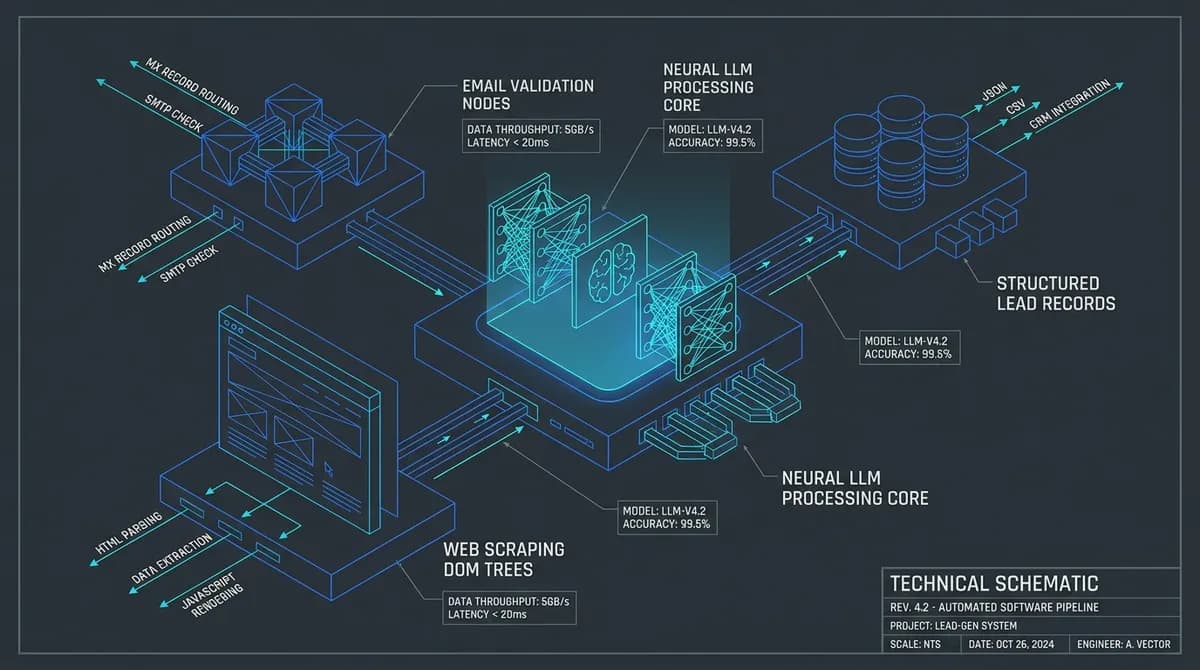
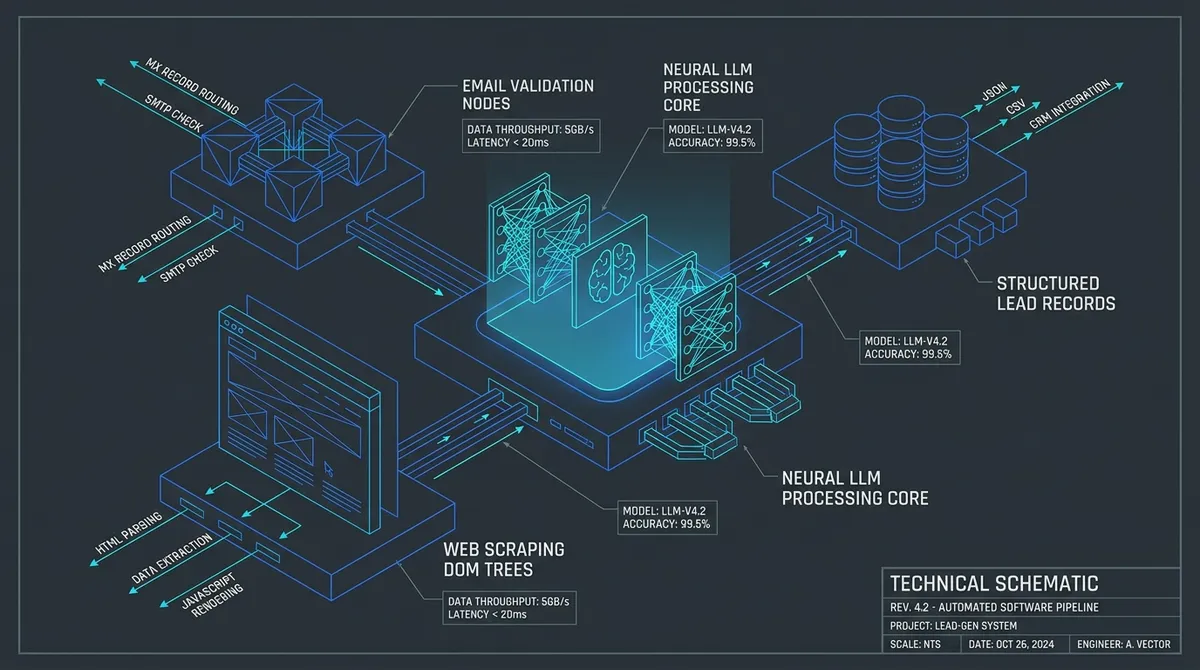
اگر امروز برای هر لید شخصیسازیشده هزینههای دلاری میپردازید، باید بدانید که یک خط لوله تولیدی با پایتون میتواند این هزینه را به ۰.۰۰۱ تا ۰.۰۰۳ دلار کاهش دهد. این کاهش چشمگیر با ادغام مراحل تأیید، استخراج و شخصیسازی در یک جریان کاری ناهمگام (Asynchronous) با استفاده از asyncio، aiosmtplib، trafilatura و instructor ممکن شده است. این رویکرد نیاز به اشتراکهای پراکنده در سرویسهای SaaS را به طور کامل از بین میبرد.
بسیاری از تیمهای فروش در حال حاضر به زنجیرهای از ابزارهای گرانقیمت وابسته هستند؛ آنها برای تأیید ایمیل، استخراج دامنه و رابطهای مدل زبانی مبالغ جداگانهای میپردازند. این ساختار پراکنده اغلب به «خودکشی تحویلپذیری» منجر میشود؛ جایی که ارسال پیام به ایمیلهای تأییدنشده یا آدرسهای catch-all، نرخ پرش (Bounce Rate) را بالا برده، اعتبار دامنه را میسوزاند و باعث میشود صندوقهای ورودی اصلی در لیستهای سیاهی مثل Spamhaus یا Proofpoint قرار گیرند. علاوه بر این، بسیاری در تله «متغیرهای پویا» میافتند و از برچسبهای کلی مثل «سلام {{نام}}، دیدم که شرکت {{نام_شرکت}} در حال رشد است» استفاده میکنند که برای فیلترهای سازمانی مدرن و همچنین گیرندگان انسانی، بوی اسپم الگوریتمیک میدهد. همانطور که در تحلیل قبلی ما دربارهی حل آشفتگی دادهها با Asyncio و Pydantic اشاره کردیم، این خط لوله همان اصول موازیسازی را به لایه شبکه میآورد.
گلوگاه: چرا ساختارهای پراکنده شکست میخورند؟
طبق گزارشهای فنی، مسیر سنتی جذب لید معمولاً چنین است: خروجی CSV $ \rightarrow $ API تأیید ($) $ \rightarrow $ پروکسی استخراج ($) $ \rightarrow $ وبهوک Zapier/n8n ($) $ \rightarrow $ رابط مدل زبانی ($) $ \rightarrow $ CRM. به نقل از بررسیهای معماری، این مدل علاوه بر هزینههای اشتراکی — مثل پرداخت ۰.۰۰۸ دلار برای هر تأیید در ZeroBounce یا صرف صدها اعتبار در Clay یا Apollo برای استخراجهای ساده — سه نقطه ضعف سخت دارد:
- آبشارهای محدودیت نرخ: کندی یک API در زنجیره میتواند باعث Time-out شود و تسکهای وبهوک را در حالت «زامبی» رها کند.
- تزریق بستر ناپالایش: ارسال کدهای HTML خام یا DOMهای سنگین به مدل زبانی بزرگ (LLM) — که شبیه کتابخانهداری است که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — بودجه توکنها را میبلعد و کیفیت را با بنرهای «پذیرش کوکیها» و نوار ابزارهای ناوبری کاهش میدهد.
- بررسیهای جعبهسیاه SMTP: بسیاری از تأییدکنندههای تجاری، دامنههای شرکتی را به دلیل نبود تشخیص دقیق Greylist یا وضعیتهای تکرار SMTP، به اشتباه «ریسکدار» یا «Catch-all» طبقهبندی میکنند.
معماری خط لوله
این سیستم به صورت یک خط لوله چهار مرحلهای با صفهای Worker مدیریت میشود تا یکپارچگی دادهها و جریان آنها حفظ شود:
۱. موتور دستدهی DNS و SMTP ناهمگام: استفاده از aiodns برای تفکیک رکورد MX و aiosmtplib برای دستدهی مستقیم. لیدهای نامعتبر به صف Dead Letter منتقل یا حذف میشوند.
۲. جذب قطعی دامنه: استخراج HTTP بدون سر (Headless) با چرخش اثر انگشت TLS و تبدیل HTML به Markdown.
۳. شخصیسازی تایپشده با LLM: استفاده از Instructor و Pydantic برای تزریق بستر با بودجه توکن محدود و خروجی ساختاریافته.
۴. همگامسازی وضعیت و حافظه پنهان: بهرهگیری از حافظه پنهان محلی SQLite در حالت WAL و فعالسازی وبهوکهای CRM.
موتور تأیید با هزینه صفر
بر اساس مستندات منتشر شده در ۱ اکتبر ۲۰۲۶ در dev.to، مرحله اول این خط لوله، APIهای پولی را با دستدهیهای مستقیم SMTP جایگزین میکند. سیستم به جای پرداخت هزینه برای هر درخواست، از aiodns برای یافتن رکوردهای MX و از aiosmtplib برای انجام یک دستدهی خام استفاده میکند.
- فرآیند: سیستم رکورد MX را مییابد، آنها را بر اساس اولویت مرتب میکند و توالی سختگیرانه HELO $ \rightarrow $ MAIL FROM $ \rightarrow $ RCPT TO را دنبال میکند.
- اعتبارسنجی: اگر سرور مقصد کد ۲۵۰ را برگرداند، ایمیل تأیید شده است. کد ۵۵۰ نشاندهنده عدم تحویل و سایر کدها به عنوان «ریسکدار» علامتگذاری میشوند.
- اجرای نامرئی: سیستم بلافاصله دستورات RSET و QUIT را میفرستد تا مطمئن شود در طول این بررسی، هیچ ایمیلی واقعاً ارسال نمیشود و ردی از پیام باقی نمیماند.
استخراج محتوای پالایششده
برای جلوگیری از اتلاف توکنها، خط لوله از ارسال HTML خام به مدل خودداری میکند. این سیستم از httpx برای درخواستها — همراه با چرخش اثر انگشت TLS و User-Agentهای سفارشی (که مرورگر Chrome 122 را شبیهسازی میکنند) — و از trafilatura برای حذف کدهای تکراری، اسکریپتها و نوار ابزارها استفاده میکند. این کار صفحات وب شلوغ را به Markdown متراکم تبدیل میکند تا استنتاج (Inference) — یعنی همان لحظهای که مدل واقعاً جواب تولید میکند، شبیه به خودِ آشپزی و نه دوره آموزش آشپز — فقط روی دادههای ارزشمند شرکت متمرکز شود. معمولاً این بستر استخراج شده به ۴۰۰۰ کاراکتر محدود میشود تا کارایی سیستم حفظ گردد.
شخصیسازی ساختاریافته با Pydantic
برای جلوگیری از تبدیل شدن خروجی مدل به متون تبلیغاتی کلی، سیستم از instructor و Pydantic استفاده میکند. این ابزارها مدل را — چه GPT-4o-mini باشد، چه یک نمونه محلی Ollama یا مدلهای Anthropic — مجبور میکند از یک طرح (Schema) سختگیرانه پیروی کند. برای کسانی که قصد دارند مدلهای محلی را در مقیاس صنعتی به کار بگیرند، استفاده از FastAPI برای ایجاد APIهای خصوصی دور Ollama راهکاری بهینه برای مدیریت این مدلهاست. خروجی به چهار فیلد محدود میشود:
- عرضه اصلی شرکت: یک خلاصه فنی تکجملهای از آنچه شرکت میسازد یا میفروشد.
- نقطه درد شناساییشده: یک چالش فنی یا عملیاتی احتمالی بر اساس مقیاس و حوزه فعالیت آنها.
- عنوان ایمیل: یک خط کوتاه، غیررسمی و غیر اسپمی زیر ۶ کلمه.
- قلاب یخشکن: یک جمله آغازین متنی که به معماری واقعی محصول یا تمرکز اخیر شرکت اشاره میکند و از تعریفهای کلی مثل «کار شما تحسینبرانگیز است» پرهیز میکند.
مقیاسپذیری عملیاتی و حافظه پنهان
مقیاسدهی این سیستم برای هزاران پرسوجو در ساعت، نیازمند حفاظهای زیرساختی است تا به عنوان بات شناسایی نشود:
- کنترل همروندی: راهنما توصیه میکند از
asyncio.Semaphore(15)استفاده شود تا از اتمام سوکتها و لیستهای خاکستری (Greylisting) سرورهای شرکتی مثل Microsoft Exchange یا Mimecast جلوگیری شود؛ سرورهایی که اغلب در زمان ارسالهای انبوه، کدهای گذار ۴۵۱ یا ۴۲۱ صادر میکنند. - یکپارچگی DNS: ماشین بررسی باید دارای DNS مستقیم و معکوس (رکورد PTR) معتبر باشد تا با نام میزبان اعلام شده در دستور HELO مطابقت داشته باشد.
- حافظه پنهان محلی: برای جلوگیری از هزینه تکراری توکنها و کاهش I/O شبکه، سیستم از SQLite در حالت WAL (Write-Ahead Logging) استفاده میکند. این حالت اجازه خواندن و نوشتن همزمان بدون قفل شدن را برای یک بازه ۳۰ روزه میدهد.
در نهایت، دادههای تأییدشده از طریق HTTP POST به CRMهایی مثل HubSpot، Smartlead یا Instantly و یا ابزارهای اتوماسیونی مثل n8n ارسال میشوند، در حالی که ایمیلهای نامعتبر برای حفظ اعتبار فرستنده، کاملاً نادیده گرفته میشوند.
این تغییر معماری، گلوگاه را از هزینه مالی (اعتبارات SaaS) به پیکربندی فنی (اعتبار IP و DNS) منتقل میکند. برای توسعهدهنده، این به معنای توانایی مقیاسدهی تلاشهای بازاریابی بدون افزایش خطی هزینههای ماهانه است. در واقع، جذب لید از یک وظیفه خرید ابزار، به یک مسئله مهندسی سیستم تبدیل میشود. این رویکرد مهندسیشده در کنار استراتژیهای غنیسازی داده، مشابه آنچه در بهرهگیری از عاملهای Torment Nexus برای افزایش نرخ پاسخدهی دیدیم، میتواند بازدهی کمپینهای سرد را به شدت افزایش دهد.
اگر این سیستم را به صورت محلی مستقر میکنید، باید اعتبار IP خود را به دقت زیر نظر بگیرید تا توسط Mimecast یا سایر فیلترهای سازمانی مسدود نشوید. چالش حیاتی بعدی، مدیریت چرخش دامنههای ارسالی برای حفظ تحویلپذیری در مقیاس بالا است.
گام بعدی شما
- بررسی اعتبار IP و تنظیم رکوردهای PTR برای جلوگیری از مسدود شدن توسط فیلترهای سازمانی.
- پیادهسازی
asyncio.Semaphoreبرای مدیریت نرخ درخواستها و جلوگیری از Greylisting. - جایگزینی تدریجی APIهای تأیید ایمیل با موتور SMTP محلی برای کاهش هزینههای عملیاتی.
اما مدیریت چرخش دامنههای ارسالی برای حفظ تحویلپذیری در مقیاس بالا، چالش بعدی است که در گزارشهای آتی بررسی خواهیم کرد.



گفتگو