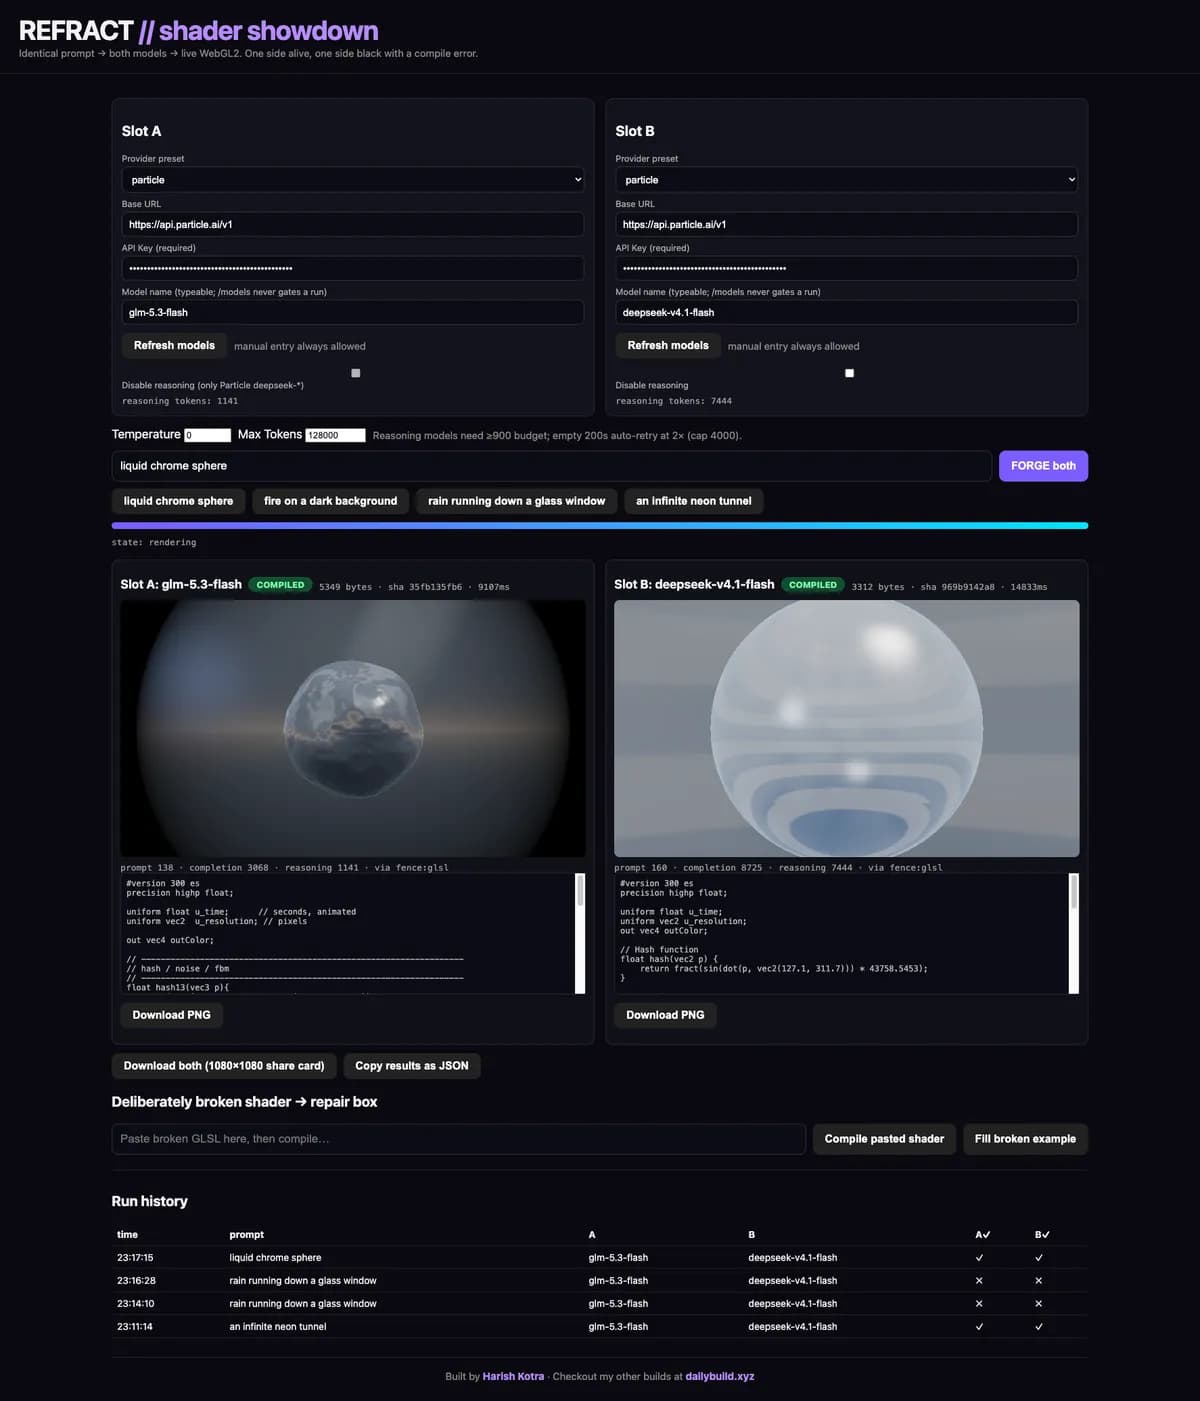
تصور کنید یک برنامهنویس به جای تماشای جداول خشکِ امتیازات، دو مدل هوش مصنوعی را میبیند که در یک نبرد زنده برای خلق یک اثر بصری میجنگند. در این میدان، هیچ جای بلوف زدن نیست؛ یا کد اجرا میشود و تصویر خلق میگردد، یا صفحه سیاه میماند و خطای کامپایلر فاش میشود.
در ۲۲ سپتامبر ۲۰۲۶، پروژهای به نام Refract معرفی شد تا بنچمارکهای کدنویسی را از حالت متنی به نبردهای بصری تبدیل کند. در این سامانه، دو مدل زبانی بزرگ (LLM) — شبیه کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — باید در لحظه شیدرهای GLSL (زبان برنامهنویسی برای گرافیک) بنویسند تا روی صفحه نمایش رندر شوند.
بسیاری از توسعهدهندگان برای سنجش کیفیت مدلها به امتیازات انتزاعی مثل HumanEval تکیه میکنند. اما همانطور که در تحلیل قبلی ما دربارهی تأثیر محدودیتهای نرخ درخواست بر عملکرد سرویسهای ابری اشاره کردیم، شکاف عمیقی میان امتیاز بنچمارک و واقعیت تولید وجود دارد. Refract این شکاف را با اجبار مدلها به تولید کدی که باید فوراً در محیط WebGL2 کامپایل و اجرا شود، پر میکند.
بنچمارک بصری و مکانیسم خطا
در این سیستم، کیفیت مدل به جای عدد، قابل مشاهده است. ممکن است یک مدل تونلی نئونی و متحرک خلق کند، در حالی که مدل مقابل با یک صفحه سیاه و خطای ERROR: 0:12: 'outColor' : undeclared identifier مواجه شود که مستقیماً به کاربر خیره شده است. طبق مستندات پروژه، در اینجا لاگ خطای GPU نقش گزارشگر مسابقه را ایفا میکند و هر نقص فنی را بیپرده نمایش میدهد.
معماری این سامانه از یک بکاند Node.js برای مدیریت ترافیک به ارائهدهندگانی چون Particle.ai، Ollama و OpenRouter استفاده میکند. این طراحی باعث میشود کلیدهای API هرگز به کلاینت نرسند و سرور بتواند محتوای استدلالی (reasoning_content) را پیش از ارسال به مرورگر حذف کند. هسته رندرینگ نیز بسیار سبک است و تنها با حدود ۴۰ خط کد خام WebGL2 و بدون استفاده از کتابخانههایی مثل three.js اجرا میشود.
جزئیات فنی هسته رندرینگ
شیدر ورتکس در این سیستم یک مثلث تمامصفحه بدون بافر است که از gl_VertexID برای مدیریت تمام عملیات استفاده میکند. یک حلقه requestAnimationFrame هر دو بوم را مدیریت کرده و متغیرهای u_time و u_resolution را در هر فریم با در نظر گرفتن DPR-aware viewports بهروز میکند. از آنجا که هر بوم کانتکست (Context) مجزایی دارد، شکست در کامپایل یک مدل تأثیری بر اجرای مدل دیگر نمیگذارد.
بر اساس بررسی فنی سازوکارها، ویژگیهای کلیدی این سیستم عبارتند از:
- کامپایل زنده: مرورگر خروجی متنی خام مدل را مستقیماً در یک کانتکست واقعی WebGL2 کامپایل میکند. اگر عملیات شکست بخورد، لاگ اطلاعاتی (info log) درایور دقیقاً همانطور که هست نمایش داده میشود و هرگز بازنویسی یا خلاصه نمیشود.
- مرحله اصلاح (Repair Pass): مدلهای شکستخورده دقیقاً یک فرصت برای اصلاح کد دارند. سیستم شیدر خطادار و لاگ دقیق و کلمه-به-کلمه کامپایلر را به مدل بازمیگرداند تا تلاش دوم را برای رفع باگ انجام دهد.
- سیستم تأیید (Verification Rig): برای اطمینان از اینکه این سیستم واقعیت را میسنجد، سه آزمایش طراحی شده است: یک پرامپت تونل برای اطمینان از وجود انیمیشن، یک شیدر عمداً خراب برای تأیید دقت لاگها، و یک «بررسی نانس اجرای دوگانه» (double-run nonce check) که در آن اگر دو خروجی از نظر بایتی یکسان باشند، سیستم متوجه استفاده از کش (Cache) شده و تولید تازه را تضمین میکند.
- پورتینگ پویا: برای جلوگیری از کرش در سیستمهای شلوغ، بکاند پورتهای ۳۰۰۱ تا ۳۰۲۰ را اسکن کرده و در صورت اشغال بودن، پورت را بهطور خودکار تغییر میدهد. پروکسی Vite در اینجا به جای کش کردن پورت ۳۰۰۱ در هنگام استارتآپ، فایل
.backend-portرا در هر درخواست مجدداً میخواند.
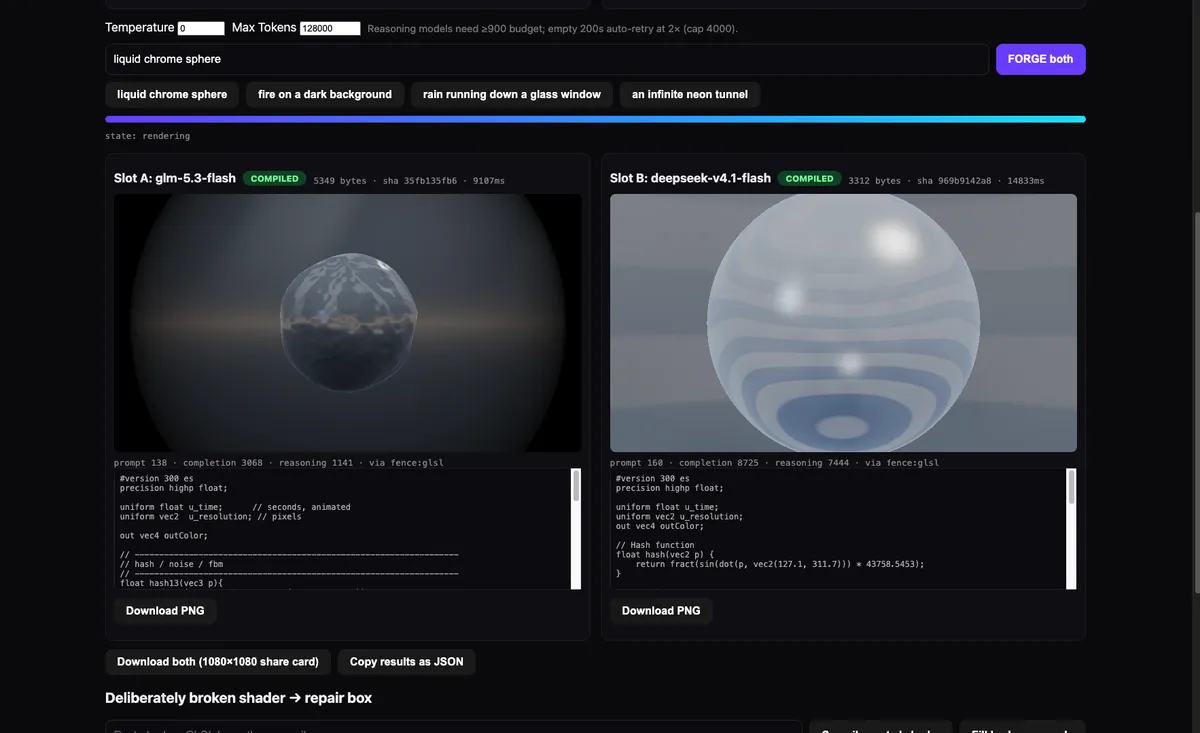
یکی از یافتههای بحرانی در ساخت Refract مربوط به نحوه مدیریت توکنهای استدلالی توسط ارائهدهندگان مختلف است. به گزارش توسعهدهندگان، ارائهدهندگان محلی مثل LM Studio و Ollama توکنهای استدلالی را گزارش نمیکنند؛ بنابراین رابط کاربری به جای چاپ عدد صفر (که گمراهکننده است)، عبارت "n/a" را نشان داده و دکمه تغییر وضعیت تفکر (thinking toggle) را مخفی میکند.
منطق لایه مدل
تشخیص قابلیتها در این سیستم بسیار سختگیرانه است. فیلد chat_template_kwargs: {enable_thinking: false} تنها برای مدلهای deepseek-* شرکت Particle ارسال میشود تا از رد شدن درخواست جلوگیری شود. بودجه استدلال در سطح ۹۰۰ توکن تنظیم شده است. اگر پاسخ HTTP 200 محتوای خالی برگرداند، سیستم یک بار با دو برابر کردن بودجه تلاش مجدد میکند؛ زیرا معمولاً پاسخهای خالی به این معناست که زنجیره تفکر (Chain-of-Thought) — مثل وقتی شاگرد ریاضی پای تخته بلند بلند فکر میکند تا به جواب برسد — تمام پنجره متنی را اشغال کرده و جایی برای پاسخ نهایی باقی نگذاشته است.
علاوه بر این، انتخابگر مدلها بهگونهای طراحی شده که اگر نام مدلی در لیست پیشنهادی GET {base}/models نبود، کاربر بتواند آن را دستی تایپ کند. این موضوع برای مدلهای خاصی مثل deepseek-v4-flash-0731 که اغلب در لیستهای رسمی ارائهدهندگان ظاهر نمیشوند، ضروری است.
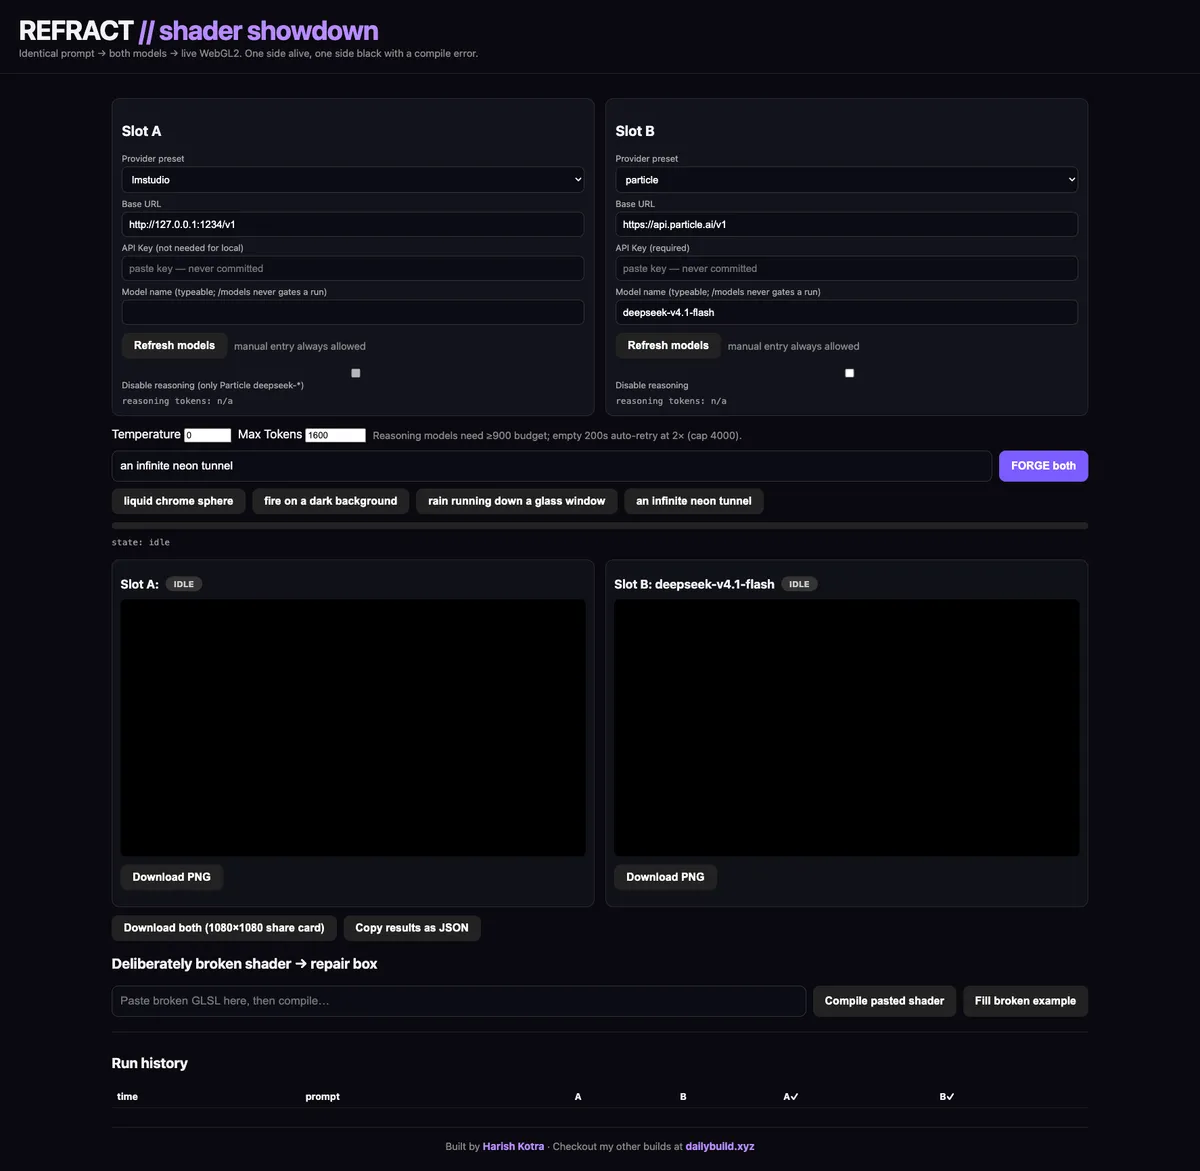
چرخش از بنچمارکهای ایستا به اجرای زنده، این فرض را که «امتیاز کدنویسی بالا برابر با قابلیت اطمینان است» به چالش میکشد. Refract با تبدیل لاگ خطا به یک ابزار نظارتی، توانایی مدل در خوداصلاحی را میسنجد؛ معیاری که جداول ردهبندی سنتی قادر به ثبت آن نیستند. برای کاربر، این فرآیند یک ارزیابی فنی را به محتوایی جذاب برای ضبط صفحه (screen-record bait) تبدیل میکند، جایی که تفاوت بین یک تونل نئونی و یک صفحه سیاه، مطلق و غیرقابل انکار است.
نسخههای آینده این پروژه قصد دارند یک سیستم ELO تورنمنتی برای مدلهای مختلف، نمای Diff برای مقایسه شیدرهای اصلی و اصلاحشده، امتیازدهی مبتنی بر هش ادراکی (perceptual-hash) برای رایگیری خودکار «جالبترین اثر» و همچنین نسخهای مبتنی بر WebGPU/WGSL را پیادهسازی کنند تا حالتهای شکست را در زبانهای مختلف شیدر مقایسه نمایند.
گام بعدی شما
- اگر از مدلهای استدلالی برای کدنویسی استفاده میکنید، خروجیهای خود را در محیطهای ایزوله (Sandbox) اجرا کنید تا نرخ خطای واقعی را بسنجید.
- برای کاهش توهمات در کدنویسی، از متد «ارسال لاگ خطا به مدل» برای اصلاح خودکار (Self-healing) استفاده کنید.
- بررسی کنید که آیا مدل انتخابی شما در پاسخهای طولانی، دچار مشکل مصرف تمام توکنها در لایه استدلال میشود یا خیر.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو