تصور کنید عروسکی دارید که نه تنها احساسات شما را میفهمد، بلکه دربارهی معنای زندگی با شما بحث میکند، بدون اینکه حتی یک بایت از دادههای خصوصی شما به سرورهای گوگل یا OpenAI ارسال شود. این تجربه اکنون با هزینهای کمتر از ۱۲۰ یورو و با استفاده از سختافزارهای در دسترس ممکن شده است.
پروژهای به نام Philosopher Plush که در ۲۳ سپتامبر ۲۰۲۶ منتشر شد، نشان میدهد که سختافزارهای محلی چگونه میتوانند تعاملات چندوجهی (Multimodal) — یعنی مدلی که همزمان متن، عکس و صدا را میفهمد، شبیه ما که با چند حس دنیا را میخوانیم — را بدون وابستگی به ابر مدیریت کنند. در حالی که اکثر اسباببازیهای هوشمند بر پایه اشتراکهای ماهانه و APIهای بسته هستند، این پروژه از رویکردی غیرمتمرکز استفاده میکند.
همانطور که در تحلیلهای قبلی ما دربارهی هوش مصنوعی حاکمیتی (Sovereign AI) اشاره کردیم، تمایل کاربران برای بازپسگیری کنترل دادههای شخصی در حال افزایش است. این عروسک با جداسازی «حواس» از «مغز»، این استقلال را به سطح اسباببازیها میآورد.
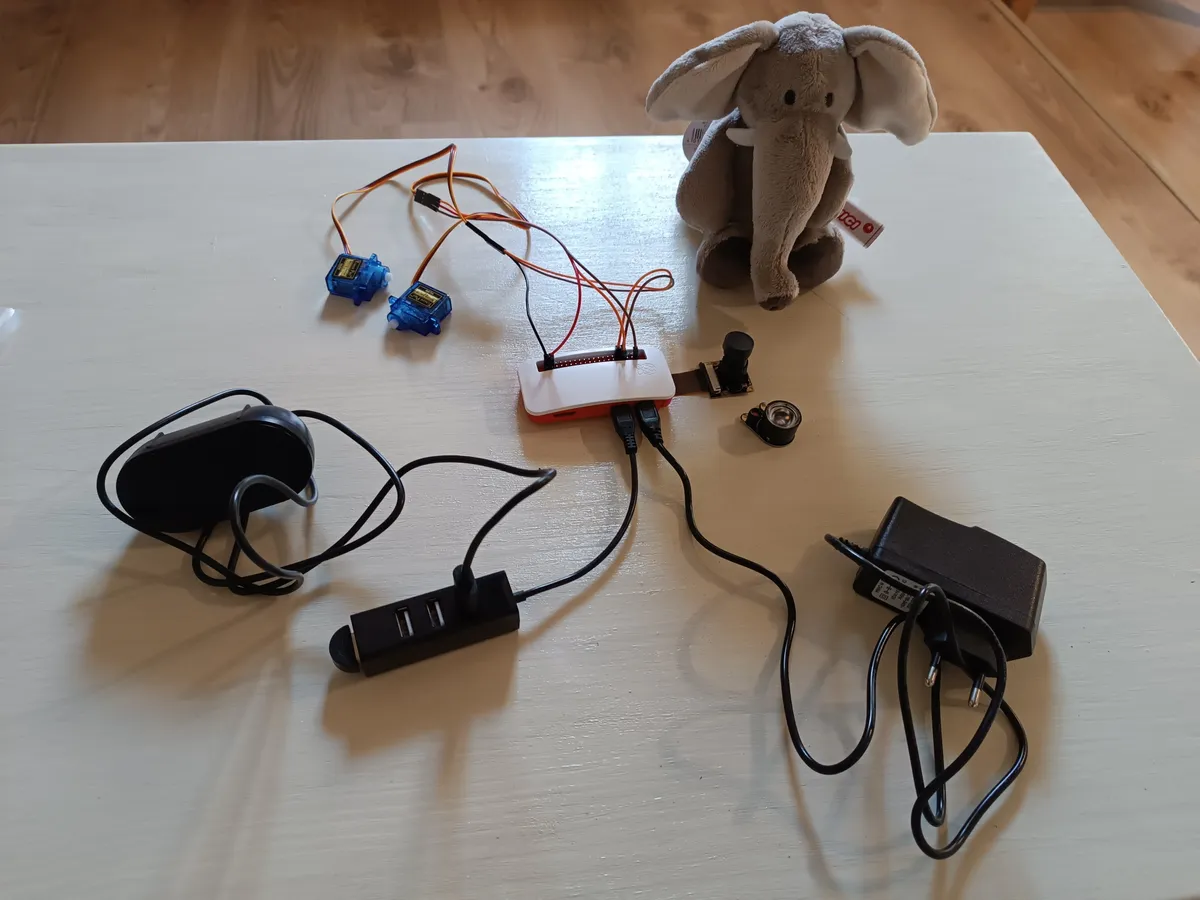
طبق مستندات منتشر شده در dev.to، این سیستم از یک Raspberry Pi Zero WH به عنوان مرکز ورودی و خروجی استفاده میکند که به دوربین CSI، میکروفون USB و بلندگو متصل است. لیست سختافزاری این پروژه شامل موارد زیر است:
- Raspberry Pi Zero WH و کارت حافظه (۴۰ یورو)
- پوسته عروسکی (۱۵ یورو)
- هاب USB، میکروفون و بلندگو (۳۰ یورو)
- دوربین CSI و سروو موتور برای حرکت سر (۲۰ یورو)
- کابلهای جامپر (۵ یورو)
برای بخش «مغز»، عروسک از طریق WebSocket به کامپیوتری متصل میشود که یک سرور استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، مثل خودِ آشپزی و نه دورهی آموزش آشپز — سازگار با OpenAI را اجرا میکند. سازنده پروژه استفاده از ابزارهایی مانند Ollama، vLLM یا LM Studio را توصیه میکند. به نقل از توسعهدهنده، برای مدیریت منطق گفتگو، یک مدل ۸ میلیارد پارامتری (مانند 8B Hermes) روی سروری با ۱۶ گیگابایت VRAM (حافظه ویدیویی) ایدهآل است.
این کامپیوتر وظیفه تبدیل گفتار به متن (STT)، بازشناسی چهره و احساسات، و تبدیل متن به گفتار (TTS) را بر عهده دارد و سپس سیگنالهای صوتی و حرکتی را به عروسک بازمیگرداند. از آنجا که این پروژه تحت مجوز MIT منتشر شده، کاربران میتوانند شخصیت «فیلسوف» را با هر کاراکتر یا زبان دیگری جایگزین کنند.
این ساختار ثابت میکند که مدلهای کلاس 8B اکنون به اندازه کافی بهینه شدهاند تا بدون تأخیر محسوس، یک هوش مصنوعی تجسمیافته را در محیط خانه مدیریت کنند.
گام بعدی شما
- اگر یک GPU بلااستفاده در خانه دارید، کدها و دستورالعملهای کامل را در GitHub دریافت کنید.
- مدلهای مختلف 8B را در Ollama تست کنید تا بهترین شخصیت را برای عروسک خود بیابید.
- برای کاهش تأخیر، از مدلهای کوانتیده (Quantized) استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است؛ برای درک اینکه چگونه مدلهای کوچکتر در حال بلعیدن مدلهای غولپیکر میشوند، به تحلیل ما دربارهی مدلهای زبانی کوچک (SLM) مراجعه کنید.



گفتگو