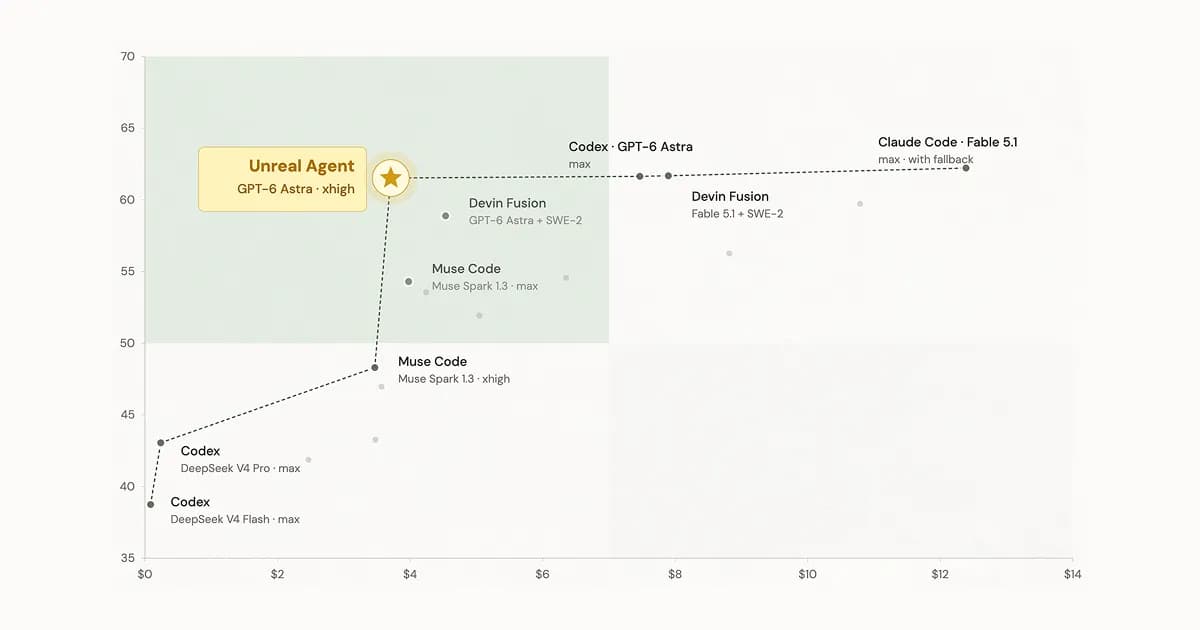
اگر امروز برای اجرای عاملهای هوش مصنوعی هزینه پرداخت میکنید، احتمالاً بخش بزرگی از بودجه شما صرف «مالیات توکن» شده است؛ یعنی توکنهایی که مدل فقط برای منتظر ماندن یا چک کردن وضعیت یک ابزار مصرف میکند. Unreal Labs با معرفی یک معماری جدید، این هزینههای عملیاتی را تا ۴۰٪ در مقایسه با Codex کاهش داد.
طبق اعلام این شرکت در ۲۲ سپتامبر ۲۰۲۶، Unreal Agent با حذف وظایف مدیریتی از دوش مدل زبانی بزرگ (LLM) — که شبیه کتابخانهداری است که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — هزینهها را به شدت پایین آورده است. در معماری فعلی، اکثر عاملهای هوش مصنوعی در یک حلقه همگام (Synchronous) عمل میکنند؛ یعنی مدل باید فعالانه چرخهٔ حیات یک فراخوانی ابزار را مدیریت کند. این وضعیت باعث ایجاد یک «مالیات توکن» میشود که در آن بخش قابل توجهی از پنجره بافت (Context Window) به جای حل مسئله، صرف هزینههای اداری و مدیریتی میشود. این وضعیت شبیه آشپزی است که باید ده دقیقه مقابل فر بایستد و فقط تماشا کند تا بتواند خرد کردن سبزیجات را شروع کند.
Unreal Agent این روند را با پیادهسازی یک «هارنس» (Harness) یا لایهٔ سازماندهندهٔ مجزا و گسسته تغییر داد. وقتی عامل دستوری برای استفاده از ابزار صادر میکند، سیستم بلافاصله وضعیت ابزار را به عنوان «در حال اجرا» (in-progress) ثبت کرده و اجرای عملیات را در پسزمینه ادامه میدهد. مدل زبانی تنها زمانی دوباره فراخوانی میشود که ابزار واقعاً کارش تمام شده و نتیجه به تاریخچهٔ جلسه (Session Log) اضافه شده باشد. تیم مهندسی اشاره کرد که پیادهسازی این سازوکار بدون خراب کردن حافظه پنهان (Cache)، یکی از چالشهای فنی اصلی در این پروژه بوده است. همانطور که در تحلیل قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، جداسازی لایههای اجرایی از لایههای استدلالی، کلید مقیاسپذیری در سیستمهای پیچیده است.
زمینه: محدودیتهای SDKهای فعلی
به نقل از Unreal Labs، ابزارهای توسعه (SDK) فعلی، مانند SDK عاملهای Claude، بیش از حد برای محیطهای خط فرمان (CLI) طراحی شدهاند و در مقاس تولیدی (Production) شکست میخورند. این ابزارها مکرراً فرض میکنند که جلسات محلی هستند و پیشفرضهایی درباره فرآیندهای فرعی (Subprocesses) و محدودیتهای منابع دارند که در مقیاس بالا کارایی ندارند. این چالشها در واقع بخشی از مشکل بزرگتری هستند که در آن بسیاری از تغییرات مهندسیشده در عاملها در محیطهای جدید دچار شکست در تعمیم میشوند و پایداری سیستم را به خطر میاندازند.
بر اساس مستندات این شرکت، مدیریت قابل اعتماد قابلیتهایی مثل تکمیل عملیات (Completion)، لغو (Cancellation) و کارهای پسزمینه، اغلب توسعهدهندگان را مجبور میکند تا سیستمهای مدیریت چرخهٔ حیات اختصاصی خودشان را بسازند. علاوه بر این، تغییر حالتهای API میتواند باعث خرابی ابزارها یا فرآیند فشردهسازی (Compaction) شود. همچنین، بهروزرسانیهای SDK اغلب فرمت پیامها را تغییر میدهند و این امر بازنویسیهای گرانقیمت در بخش یکپارچهسازی را تحمیل میکند.
در لایههای زیرین، درختهای وابستگی سنگین (Heavy dependency trees) ریسکهای نگهداری و ریسکهای زنجیره تأمین را به محیطهای اجرایی اضافه میکنند که توسعهدهندگان پیش از این نیاز به وصله کردن (Patch) آنها داشتند. Unreal Labs دریافت که تکیه بر قلابهای هارنس (Harness hooks) برای امنیت، بسیار ضعیفتر از محدودیتهای محیطی قطعی (Deterministic) است؛ محدودیتهایی مانند میزبانهای مجاز/غیرمجاز، توکنهای دسترسی دقیق و پروکسیهایی که دارای دروازههای تأیید هستند.
عملکرد فنی و بنچمارکها
گزارش وبسایت unreallabs.ai نشان میدهد که این رویکرد به عامل اجازه میدهد چندین فراخوانی ابزار ناهمگون را همزمان زمانبندی کند. برای مثال، مدل میتواند در حالی که محیط توسعه را آماده میکند (که ممکن است دقایقی زمان ببرد)، همزمان کدها را بررسی کرده و در وب جستوجو کند، بدون اینکه فشار شناختی یا هزینه توکن روی مدل زیاد شود.
در تستهای رودررو با مدل GPT-6 Astra xhigh، نتایج زیر به دست آمد:
- بهینگی هزینه: کاهش هزینه تا ۴۰٪ نسبت به Codex و ۲۰٪ نسبت به Pi در بارهای کاری واقعی و بنچمارکهای عاملمحور.
- کاهش توکن: در یک بنچمارک Harbor، Unreal Agent از ۱.۷۳ میلیون توکن ورودی استفاده کرد، در حالی که Pi برای نرخ موفقیت مشابه (۵۵.۰٪ در مقابل ۵۷.۹٪)، به ۲.۸۳ میلیون توکن نیاز داشت.
- بهینهسازی نوبتها: سیستم به نتایج با نوبتهای کمتر مدل و کمترین ردپای پرامپت (Prompt footprint) دست مییابد و از بهکارگیری عاملهای فرعی (Sub-agents) یا جریانهای کاری پیچیده اجتناب میکند.
- شاخصهای مقایسهای: در یک تست غیر-Harbor، Unreal Agent به نرخ موفقیت کامل ۳۰.۰٪ با میانگین امتیاز ۵۹.۷ و هزینه کل ۲۱۷ دلار رسید، در حالی که Codex نرخ موفقیت ۲۹.۰٪ و هزینه ۲۹۲ دلار داشت.
- نسبت کارایی: در اجرای دیگری از Harbor، این سیستم با هزینه ۹۳۶ دلار و ۸۹۸ هزار توکن ورودی به نرخ موفقیت ۶۵.۸٪ رسید، در حالی که Codex برای رسیدن به نرخ ۶۳.۳٪، به ۱,۳۰۳ دلار و ۱.۶۹ میلیون توکن نیاز داشت.
جزئیات پیادهسازی
این صرفهجوییها مدیون دو عامل اصلی است: اثر حداقلی لایه سازماندهنده (Minimal harness footprint) و مهندسی دقیق نحوه استفاده از خروجی ابزارها. سیستم از پرامپتهای ساده و نتایج ابزارهایی استفاده میکند که از نظر توکن بهینه شدهاند.
از آنجا که مدل ناهمگام بودن فراخوانی ابزارها به طور واضح برای LLM توضیح داده شده است، عامل میتواند در هر نوبت دستورات «سنگینتری» صادر کند بدون اینکه توکنها را صرف نظارت (Polling) یا وضعیتهای انتظار کند. اگرچه تیم بیشتر روی بنچمارکهای کدنویسی تمرکز کرده است (به دلیل سهولت در بازتولید نتایج در Harbor)، اما این هارنس به گونهای طراحی شده که مستقل از دامنه (Domain-agnostic) باشد.
این تغییر نشان میدهد که مرز بعدی هوش مصنوعی عاملمحور، لزوماً مدلهای بهتر نیست، بلکه «هارنسهای» بهتر است. برای کسانی که به دنبال جایگزینهای مشابه هستند، بررسی ۱۱ چارچوب متنباز برای مدیریت عاملهای محلی در سال ۲۰۲۶ میتواند دید جامعتری از ابزارهای موجود در بازار ارائه دهد. با تبدیل لایه ارکستراسیون به یک حوزه پژوهشی مجزا، توسعهدهندگان میتوانند از هر توکن بیشترین بهره را ببرند. برای کاربر نهایی، این یعنی عاملهایی که سریعتر پاسخ میدهند، چون حتی هنگام اجرای کارهای سنگین در پسزمینه، میتوانند فوراً پیامهای هدایت کاربر را بپذیرند.
برای توسعهدهندگان، این یعنی کاهش مستقیم صورتحساب ماهانه API. انتقال مدیریت ابزارها از پرامپت به لایه زیرساختی، مدل زبانی را از یک «مدیر پروژه» به یک «موتور استدلال» خالص تبدیل میکند.
برای تست این کاراییها، تیم موارد زیر را در گیتهاب منتشر کرده است:
- یک کتابخانه Go برای ادغام مستقیم در کد.
- یک فایل اجرایی Runner مشابه
claude -pیاcodex exec. - یک اجرای بنچمارک سازگار با Harbor.
گام بعدی شما
- اگر از عاملهای پیچیده استفاده میکنید، بررسی کنید چه مقدار از توکنهای شما صرف پیامهای «در حال انتظار» یا «بررسی وضعیت» میشود.
- کتابخانه Go منتشر شده در گیتهاب Unreal Labs را برای پیادهسازی معماری ناهمگام در پروژههای خود بررسی کنید.
- در طراحی عاملهای جدید، مدیریت ابزارها را از پرامپت سیستمی به لایه زیرساختی منتقل کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو