اگر برای توسعه دستگاههای اینترنت اشیا (IoT) یا رابطهای مغز و رایانه (BCI) برنامهنویسی میکنید، احتمالاً با سد پهنایباند در انتقال دادههای هوش مصنوعی روبرو شدهاید. حالا پروتکل YOalphabet ادعا میکند با تبدیل متن به کدهای مستقیم سختافزاری، این بنبست را شکسته است.
طبق گزارش فنی منتشر شده در ۲۱ سپتامبر ۲۰۲۶ در وبسایت dev.to، این سامانه هندسه بصری را بهطور کامل با کدهای باینری همراستا میکند. این یعنی برای خواندن متون پایه، دیگر نیازی به شبکههای عصبی سنگین نیست.
اکثر سامانههای فعلی از یک زنجیره پیچیده استفاده میکنند: پیکسلها به متن، سپس به یونیکد و در نهایت به بردار معنایی (Embedding) — که شبیه کارت معرفی عددی برای هر واژه است و میگوید این کلمه همسایه چه کلمات دیگری است — تبدیل میشوند. این فرآیند برای دستگاههای کممصرف بسیار هزینهبر است. تصور کنید ماشینی بتواند یک نویسه را «ببیند» و بدون هیچ لایه ترجمهای، بلافاصله مقدار باینری آن را تشخیص دهد.
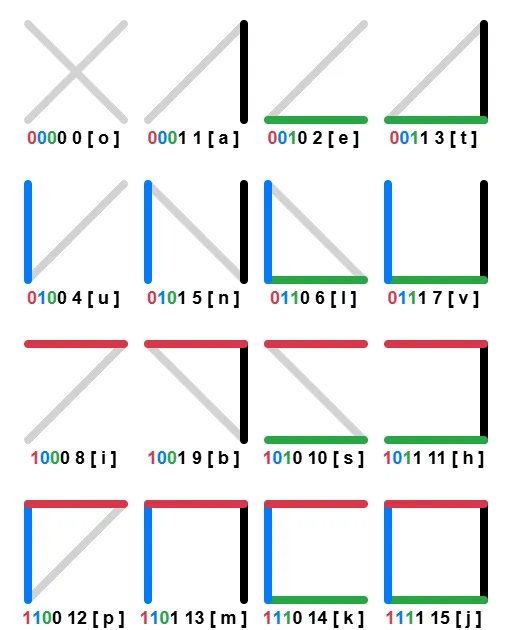
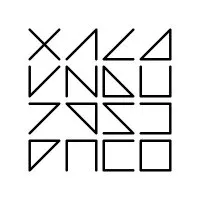
پروتکل YOalphabet و زبان همراه آن یعنی YOconlang، این قابلیت را از طریق یک اسکریپت ثباتی فضایی ۴ بیتی اجرا میکنند. بر اساس مستندات dev.to، این سیستم از یک جعبه محصور مربعی استفاده میکند که چهار لبه بیرونی آن بهعنوان ثباتیهای فیزیکی بیت (2⁰, 2¹, 2², 2³) عمل میکنند. این معماری فشردهسازی دادهها را به سطح عجیبی میرساند: این رویکرد به نوعی یادآور بهینهسازیهای معماری زمینه مکانی در مدل Atlas است که دقت بازسازیهای ساختاری را ارتقا داد.
- ذرات و ضمایر: تنها در ۱ بایت (۸ بیت / ۲ گلیف) جای میگیرند.
- افعال و صفتها: در ۱.۵ بایت (۱۲ بیت / ۳ گلیف) فشرده میشوند.
- اجرا: نگاشت مستقیم یکبهیک در ثباتیهای سختافزاری، بدون نیاز به جداول جستجوی یونیکد.
همانطور که در تحلیلهای پیشین ما درباره بهینهسازی رایانش لبه اشاره کردیم، حذف لایههای میانی کلید افزایش سرعت است. این تغییر، هوش مصنوعی را از «خواندن مبتنی بر استنتاج (Inference)» — یعنی همان لحظه آشپزی و تولید جواب — به «اجرای بومی» منتقل میکند. با حذف توکنسازی (Tokenization) — که شبیه بریدن کیک متن به تکههای کوچک برای بلعیدن توسط مدل است — و بردارهای معنایی، پهنایباند انتقال تا ۹۰٪ کاهش مییابد. برای کاربر، این به معنای ارتباط بدون تأخیر در شبکههای ماشینبهماشین (M2M) است. این تلاش برای حذف پیچیدگیهای پردازشی، در واقع پاسخی به شکاف بهرهوری داده میان انسان و هوش مصنوعی است که در آن مدلهای فعلی برای یادگیری مفاهیم ساده به حجم عظیمی از داده نیاز دارند.
این رویکرد این فرض را به چالش میکشد که زبان طبیعی حتماً باید از طریق بردارهای با ابعاد بالا پردازش شود. اگر این استاندارد پذیرفته شود، صنعت به سمت محیط ارتباطی «پیشینی» (a priori) میرود که در آن انسانها از یک اسکریپت خنثی استفاده میکنند و ماشینها آن را مستقیماً بهعنوان بایتکد اجرا میکنند. این تحول میتواند راهکاری بنیادین برای حل نقاط کور زبانی در پردازش اسناد پیچیده باشد که پیشتر با چالشهای توکنسازی در زبانهای خاص روبرو بودند.
گام بعدی شما
- ادغام اسکریپتهای فضایی در سختافزارهای کممصرف M2M را دنبال کنید.
- بررسی کنید آیا «بینایی بدون استنتاج» میتواند جایگزین OCRهای سنتی در پروژههای شما شود.
- مستندات YOconlang را برای درک نحوه نگاشت هندسی به باینری مطالعه کنید.
اما تأثیر این حذف لایهها بر مصرف انرژی تراشههای NPU حتی تکاندهندهتر است — به تحلیل ما درباره معماریهای جدید پردازش عصبی مراجعه کنید.



گفتگو