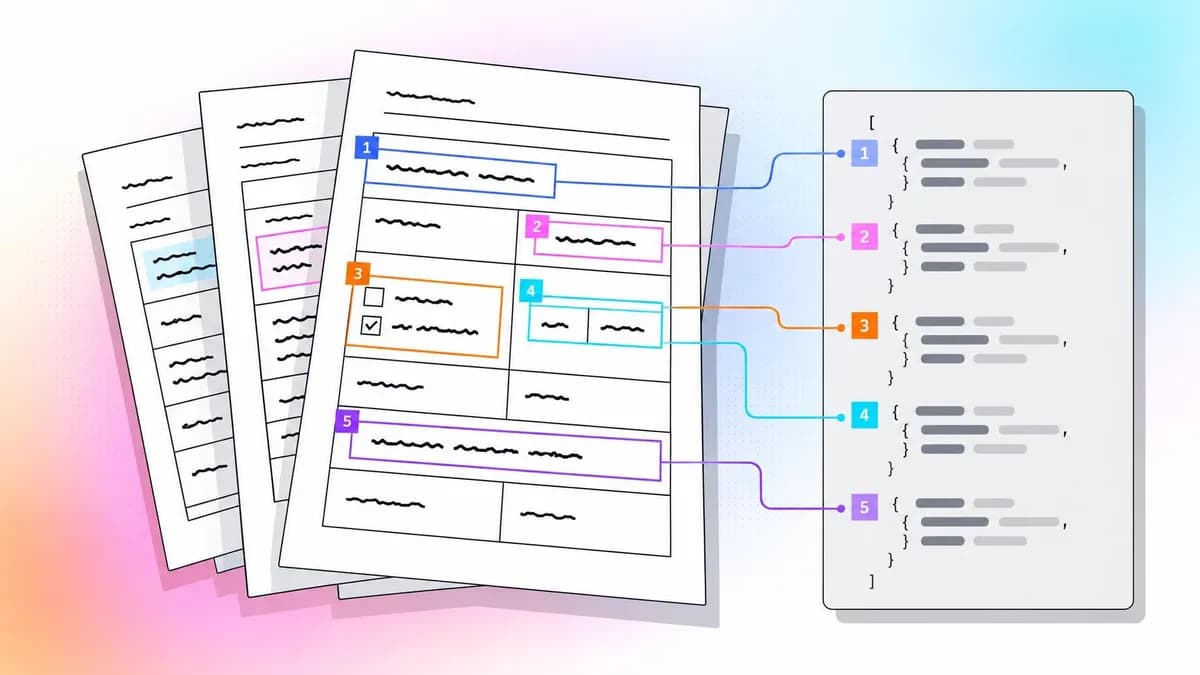
اگر امروز برای استخراج داده از هزاران سند PDF هزینه میپردازید، احتمالاً از این به بعد با هزینهای کمتر، نتایجی بسیار دقیقتر دریافت خواهید کرد. شرکت LlamaIndex در ۱ اکتبر ۲۰۲۶ نسخه ۲.۵ ابزار Extract را منتشر کرد تا کابوس پاکسازی دستی دادههای استخراجشده از فرمهای اسکنشده و اسناد پیچیده را به پایان برساند. این نسخه جدیدی از عاملهای مبتنی بر طرح (Schema-based agents) است که هدف آن حذف مراحل دستی اصلاح دادههاست.
به نقل از پست وبلاگی آدرین لایاک و الی استوارت، این بهروزرسانی باعث شده لایهی «مقرونبهصرفه» (Cost Effective) در دقت از لایهی «عاملمحور» (Agentic) نسل قبل پیشی بگیرد. این یعنی کفِ بهرهوری برای پردازش اسناد سازمانی بهطور کامل جابهجا شده است. نکته حائز اهمیت این است که این بهبودهای دقت در هر سه لایه استخراج، بدون هیچگونه افزایش در قیمت هر صفحه ارائه شده است. این روند کاهش هزینهها در راستای تحولات اخیر صنعت است؛ برای مثال، شرکت LandingAI نیز پیشتر توانست هزینههای استخراج داده از اسناد را تا ۸۰٪ کاهش دهد که نشاندهنده رقابت شدید برای بهینهسازی اقتصادی این ابزارهاست.
بسیاری از کسبوکارها در مسیر تبدیل نمونههای اولیه تولید بازیابیافزا (RAG) — که شبیه دانشآموزی است که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — به محیط عملیاتی با مشکل مواجهاند. همانطور که در تحلیل قبلی ما دربارهی بهینهسازی موتورهای استنتاج محلی اشاره کردیم و بررسی کردیم که چگونه همروندی (Concurrency) انتخاب موتورهای LLM محلی مانند Ollama و vLLM را دیکته میکند، اکنون مشخص شده که گلوگاه اصلی برای بسیاری از شرکتها تنها سرعت استنتاج نیست، بلکه کیفیت اولیه استخراج دادهها از اسناد نامنظم و چندصفحهای است.
معماری جدید عاملها
طبق اعلام این شرکت، نسخه ۲.۵ بر پایه یک زیرساخت جدید برای عامل (Agent) — موجوداتی نرمافزاری که میتوانند برای رسیدن به هدف، تصمیم بگیرند و ابزارها را به کار بگیرند — اجرا میشود. این سیستم با الهام از جدیدترین عاملهای کدنویسی طراحی شده و بهطور خاص برای مدیریت حالتهای شکست (Failure modes) در زمینههای بینایی، استدلال و تایید تنظیم شده است. نتیجه این است که عامل میتواند اطلاعات را بین چندین صفحه تطبیق دهد و مقادیر را دقیقاً به منابع اصلی متصل کند.
این سیستم از «استدلال ساختاری» (Structural Reasoning) استفاده میکند تا نمایش سند را تحلیل کرده و استخراج را بر اساس نوع سند، چیدمان و تراکم اطلاعات شخصیسازی کند. در واقع، مدل برای اسناد پیچیده زمان و تلاش بیشتری میگذارد و اسناد ساده را با تأخیر کمتری پردازش میکند. LlamaIndex برای نسخه ۲.۵، زیرساختی را که پیشتر منحصراً برای لایهی Agentic Plus رزرو شده بود، به لایههای Cost Effective و Agentic آورده و ابزارها و استراتژیها را متناسب با محدودیتهای هزینه هر لایه تطبیق داده است.
مدیریت پیچیدگی طرحها
دقت عاملها در پیروی از دستورالعملهای استخراج و طرحهای داده (Schemas) نیز بهبود یافته است. این سیستم اکنون میتواند وظایفی را مدیریت کند که تا ۳۲۰۰ فیلد دارند. شرکت به کاربرانی که شناسههای رکورد (Record IDs) برای آنها جهت تطبیق دادههای استخراجشده با پایگاه داده حیاتی است، توصیه میکند که این موضوع را صراحتاً در پرامپتهای خود ذکر کنند تا از صحت کامل استخراج اطمینان حاصل شود.
جهش در بنچمارکها
بر اساس دادههای محک ExtractBench که ۳۷۰ سند سازمانی (در مجموع ۴۸۶۹ صفحه) را در ۸ حوزه تجاری و ۶۷ نوع سند مختلف (که هر کدام طرح خاص خود را دارند) بررسی میکند، امتیاز F1 (معیاری برای سنجش دقت و بازخوانی) جهش قابلتوجهی داشته است. LlamaIndex از این مجموعه داده عمومی و ابزار ارزیابی برای تست مدلهای VLM پیشرو، عاملهای کدنویسی و APIهای تخصصی استخراج استفاده کرده است:
- لایهی مقرونبهصرفه: از ۸۷.۱ به ۹۳.۹ رسید (و حالا از لایهی Agentic قبلی بهتر است).
- لایهی عاملمحور: از ۸۹.۸ به ۹۵.۸ رسید (و اکنون از لایهی Agentic Plus قبلی پیشی گرفته است).
- لایهی Agentic Plus: از ۹۵.۱ به ۹۶.۴ رسید.
این پیشرفت در وظایف «لیستهای طولانی» (Long-list tasks) مشهودتر است؛ جایی که امتیازات در لایه Cost Effective از ۸۲.۰ به ۹۲.۶، در لایه Agentic از ۸۶.۱ به ۹۵.۵ و در لایه Agentic Plus از ۹۴.۵ به ۹۶.۳ افزایش یافت. برای مثال در یک سند ۱۷ صفحهای مربوط به گزارش یک صندوق سرمایهگذاری، لایهی اقتصادی نسخه قبلی تنها ۸۷ مورد از ۲۳۸ دارایی را شناسایی کرده بود، اما نسخه ۲.۵ تمام ۲۳۸ مورد را استخراج کرد و امتیاز سند را از ۵۲.۸ به ۹۸.۷ رساند.
حل مشکل «شکست صفحه»
یکی از بزرگترین و مداومترین نقاط ضعف هوش مصنوعی در پردازش اسناد، پدیده «شکست صفحه» (Page Break) است؛ زمانی که یک رکورد در یک صفحه شروع و در صفحه بعد تمام میشود. LlamaIndex مدعی است نسخه ۲.۵ با استفاده از نمایشهای میانی (Intermediate representations) برای کار با کل مجموعه داده و اعتبارسنجی خروجی در برابر طرح کاربر، این مشکل را حل کرده است.
امتیازات گزارششده برای رکوردهایی که بین صفحات پخش شده بودند، در لایه Cost Effective از ۸۰.۳ به ۹۲.۰، در لایه Agentic از ۸۵.۵ به ۹۶.۵ و در لایه Agentic Plus از ۹۳.۶ به ۹۶.۷ افزایش یافته است. در یک مورد واقعی از اسناد Schedule I مربوط به United Way Worldwide، عامل نسخه ۲.۰ در نقطه شکست صفحه متوقف میشد و هدف و آدرس یک کمک مالی را ناقص میگذاشت، اما نسخه ۲.۵ با موفقیت ادامه متن را از صفحه بعد گرفته و در همان رکورد ادغام کرد.
فرمهای اسکنشده و یادداشتها
در مورد فرمهای اسکنشده، امتیازات از ۸۹.۶ به ۹۳.۹ (Cost Effective)، از ۹۰.۹ به ۹۵.۷ (Agentic) و از ۹۴.۴ به ۹۶.۱ (Agentic Plus) افزایش یافت. لایهی Agentic اکنون قادر است مقادیر اصلی را از یادداشتهای دستنویس (Annotations) جدا کند. پیش از این، سیستم اغلب یادداشتهای بازبین را با دادههای واقعی ترکیب میکرد؛ برای مثال در یک مجوز دفع پسماند W-14، سیستم تاریخ بازبین را با شماره مجوز ترکیب میکرد و یادداشتی را به عمق آب شیرین میچسباند. اما نسخه ۲.۵ این موارد را دقیقاً در فیلدهای مجزای درخواستی در طرح قرار میدهد.
مبنیسازی و استنادهای پیشرفته
این نسخه قابلیت «استنادهای پیشرفته» (Advanced Citations) را برای لایههای Agentic و Agentic Plus معرفی کرده است. این ویژگی دقیقاً کادرهای محیطی (Bounding Boxes) شواهد را پیدا میکند، حتی برای مقادیری که عیناً کلمه به کلمه در متن نوشته نشدهاند. امتیاز مبنیسازی (Grounding) — یعنی متصل کردن جواب به منبع واقعی برای جلوگیری از توهم — در لایهی Agentic از ۴۶.۸ به ۸۰.۶ و در لایهی Agentic Plus از ۴۶.۴ به ۸۲.۲ جهش کرد.
در مقایسه با سایر مدلها، امتیاز مبنیسازی به شرح زیر است:
- Agentic Plus: ۸۲.۲
- GPT-6 SOL: ۷۷.۶
- Opus 5.5: ۷۷.۵
- Sonnet 5.5: ۶۳.۲
- Cost Effective: ۵۴.۳
- Reducto Deep Extract: ۵۰.۸
- Extend Max: ۲۱.۸
این استنادها در کنار امتیازات اطمینان (Confidence scores)، به بازبینهای انسانی اجازه میدهد تا در یک گردشکار «انسان در حلقه» (Human-in-the-loop)، مقادیر پرچمگذاری شده را بهسرعت تایید کنند.
قابلیتهای جدید و دسترسی
نسخه ۲.۵ همچنین «حالت صفحهگسترده» (Spreadsheet Mode) را اضافه کرده تا عاملها بهجای نمایش تخت (Flattened)، مستقیماً با سلولهای ورکبوک کار کنند. کاربران میتوانند این حالت را در پیکربندی استخراج فعال کنند.
این آپدیت از طریق LlamaCloud، یک ابزار خط فرمان مبتنی بر زبان Go به نام llp و یک سرور MCP برای کلاینتهای عامل (شامل Claude Code و Codex) و همچنین SDK پایتون llama-cloud در دسترس است. در SDK، کاربران میتوانند نسخه ۲.۵ را انتخاب کرده و گزینههای citesources و confidencescores را فعال کنند.
برای کاربران تجاری، این یعنی «مالیات» پاکسازی دستی دادهها در حال کاهش است. وقتی ارزانترین لایه یک ابزار، از لایه متوسط نسل قبل بهتر عمل میکند، سد اقتصادی برای خودکارسازی جریانهای کاری با حجم بالا عملاً از بین میرود. این بهینهسازیهای هزینهای در سایر بخشهای هوش مصنوعی سازمانی نیز دیده میشود؛ چنانکه پلتفرم Accio توانست هزینههای عملیات هوش مصنوعی در تجارت الکترونیک را بیش از ۵۰٪ کاهش دهد. کاربران اکنون باید نسخه ۲.۵ را در برابر مشکلسازترین اسناد قدیمی خود تست کنند تا ببینند آیا استدلال ساختاری جدید، نیاز به Regexهای سفارشی یا مداخلات دستی را حذف میکند یا خیر.
گام بعدی شما
- اگر از Regexهای پیچیده برای استخراج داده استفاده میکنید، اسناد مشکلدار خود را با نسخه ۲.۵ تست کنید تا ببینید آیا استدلال ساختاری نیاز به کدنویسی دستی را حذف میکند یا خیر.
- در SDK پایتون، گزینههای
citesourcesوconfidencescoresرا فعال کنید تا مسیر اعتبارسنجی دادهها را شفاف کنید. - برای اسناد دارای جداول پیچیده، حالت Spreadsheet Mode را در پیکربندی استخراج فعال نمایید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو