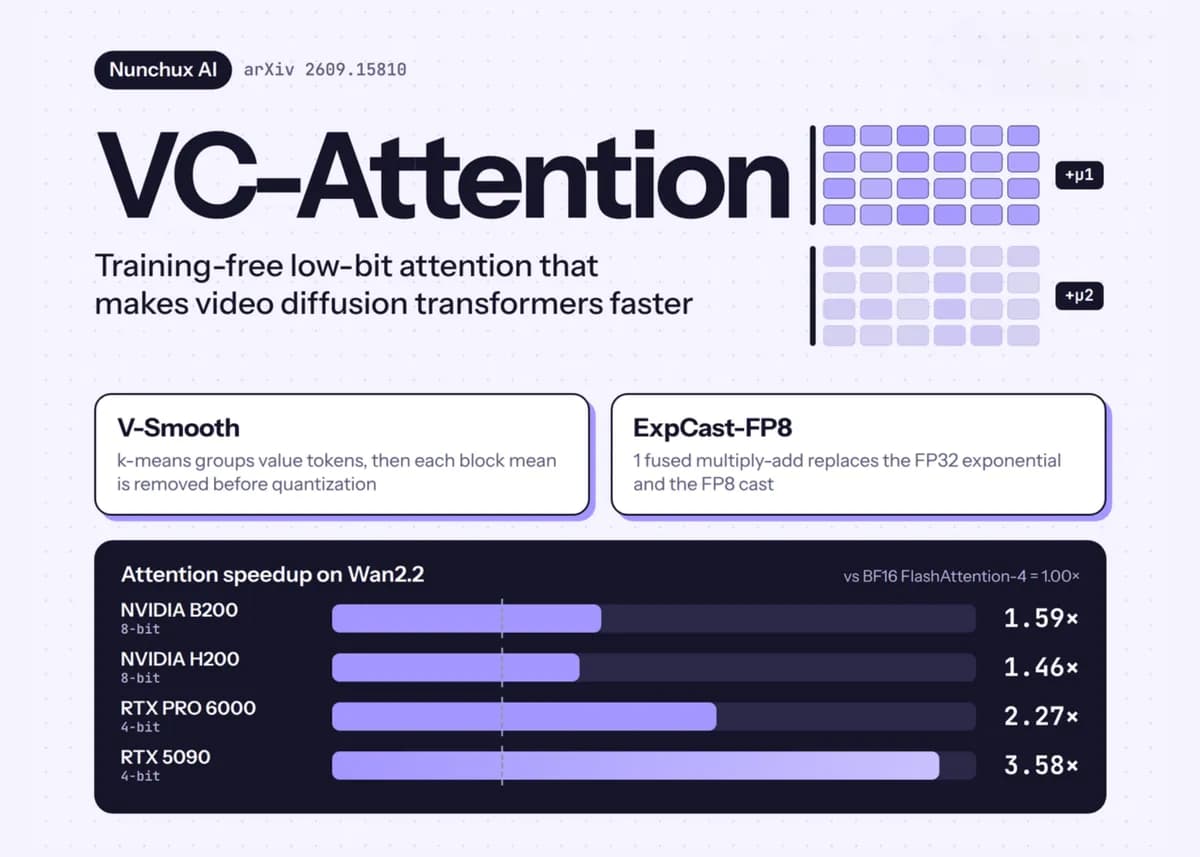
بیش از ۶۴٪ از زمان تولید کلیپهای ویدیویی ۷۲۰p روی کارت گرافیک RTX 5090 صرف مکانیزمهای توجه میشود؛ این یعنی بخش اعظم توان سختافزاری شما در یک گلوگاه محاسباتی هدر میرود. برای حل این بحران، Nunchux AI هسته VC-Attention را معرفی کرد؛ یک هسته توجه کمبیت و بدون نیاز به آموزش (Training-free) که هر دو مرحله سافتمکس و کوانتش مقادیر (Value Quantization) را بهینه میکند تا استنتاج را بدون نیاز به بازآموزی مدل شتاب دهد.
این پیشرفت در حالی رخ میدهد که صنعت با انفجار توکنهای مکانی-زمانی در ویدیوهای باکیفیت دستوپنجه نرم میکند. برای درک ابعاد موضوع، تصور کنید یک کلیپ ۵ ثانیهای با مدل Wan2.2-14B حدود ۷۰,۰۰۰ توکن تولید میکند. در حالی که پیشتر بررسی کردیم که چگونه ترنسفورمرهای حلقوی بازگشتی (Recurrent Looped Transformers) عمق استدلال را از طریق مسیرهای زمانی افزایش میدهند، چالش فوری برای تولید ویدیو همچنان هزینه خام محاسباتی لایه توجه در مراحل حذف نویز (Denoising) است. این نیاز به پردازش حجم عظیم دادههای ویدیویی، ابزارهای جدیدی را برای مدیریت محتوا ایجاد کرده است؛ برای مثال، استارتاپ Clipto با هدف تبدیل ترابایتها از ویدیو به پایگاههای دانش قابل جستجو در حال تغییر نحوه تعامل ما با دادههای بصری است.
کالبدشکافی گلوگاههای ویدیویی
در مدلهای ترنسفورمر انتشار ویدیو (Video DiTs)، کلیپها به توالیای از توکنهای مکانی-زمانی تبدیل شده و در هر لایه، عملیات خودتوجهی (Self-attention) کامل اجرا میشود. طبق گزارش فنی Marktechpost، این فرآیند بهشدت هزینهبر است؛ بهطوری که در مدل MiniMax-H3 روی پردازنده B200، حدود دو-سوم از هر مرحله حذف نویز صرفاً مربوط به لایه توجه است.
اگرچه هستههای Tensor Core کمبیت میتوانند دو ضرب ماتریسی اصلی (QK و PV) را تسریع کنند، اما دو مانع اساسی باقی میماند. نخست، متدهای پیشین مانند SageAttention2 کوئریها و کلیدها را هموار (Smooth) میکنند، اما حتی پس از هموارسازی QK و چرخش، ترم مقدار (Value) همچنان ۸۲٪ از خطای خروجی در مدل Wan2.2 را تشکیل میدهد. دوم، عملیات سافتمکس بین ضربها معمولاً در دقت FP32 اجرا میشود. در سختافزارهای B200 و H200، عملیات نمایی و تبدیل (Cast) بعدی به FP8 طولانیترین بخش خط لوله است.
VC-Attention برای رفع این دو مشکل، دو مکانیزم کلیدی را پیادهسازی کرده است:
V-Smooth: مدیریت مقادیر پرت
مقادیر پرت (Outliers) در توکنهای محدودی متمرکز شدهاند و کانالهای آنها در سرها (Heads)، لایهها و مراحل مختلف جابهجا میشوند. از آنجا که چرخش هادامارد (Hadamard rotation) نرم توکنها را حفظ میکند، نمیتواند این مقادیر پرت را حذف کند؛ در واقع چرخش V تنها خطای مقدار را ۰.۲٪ تغییر میدهد. V-Smooth بهجای چرخش ساده، از یک فرآیند سهمرحلهای استفاده میکند:
- گروهبندی (Grouping): با استفاده از الگوریتم کی-میانگین (k-means) آنلاین، توکنهای مقدار را به ازای هر بچ و سر خوشهبندی میکند. کلیدها و مقادیر با هم جایگشت (Permute) میشوند تا خروجی توجه غیر-علی (Non-causal) بدون تغییر باقی بماند. این گروهبندی تنها در ۲۵٪ نخست مراحل حذف نویز اجرا شده و جایگشت در چهار مرحله متوالی مجدداً استفاده میشود که هزینه آن تنها ۳ تا ۴٪ از کل زمان توجه است.
- حذف میانگین (Demean): در هر بلوک سختافزاری ۱۲۸ توکنی، میانگین کسر میشود و تنها باقیمانده (Residual) کوانتیده میشود. این کار با استفاده از E4M3 ۸ بیتی یا NVFP4 ۴ بیتی به صورت per-channel انجام میگیرد. این روش ۸٪ از انرژی بلوک را در ترتیب توالی، ۱۲٪ تحت مکعب استاتیک DeltaQuant و ۳۶٪ پس از مرتبسازی حذف میکند. هر میانگین تنها ۰.۱۲۵ بیت برای هر المان مقدار هزینه دارد.
- بازگردانی (Restore): میانگین را با استفاده از مجموع سطری که سافتمکس آنلاین در اختیار دارد، بازمیگرداند. این کار نیاز به گذر دوم یا بافر اضافی را کاملاً از بین میبرد.
ExpCast-FP8: بهینهسازی سافتمکس
برای حذف گلوگاه FP32، مکانیزم ExpCast-FP8 مسیر نمایی و تبدیل را با یک عملیات تکمرحلهای ضرب-جمع (Fused Multiply-Add) جایگزین میکند. این امکان به دلیل این واقعیت فراهم شده که یک بایت E4M3 به لگاریتم مقداری که ذخیره میکند نزدیک است؛ اگر به عنوان یک عدد صحیح خوانده شود، تقریباً برابر با $8 \log_2(v) + 56$ است.
ExpCast-FP8 بایت را مستقیماً از امتیاز دامنه لگاریتمی مینویسد. این سیستم از یک ثابت $\beta = -0.35$ برای مرکز کردن خطای باقیمانده استفاده میکند تا نیازی به برازش یک ثابت برای هر مدل نباشد. این مسیر مستقیم در ۷۹.۶٪ از هر دوبرابر شدن، دقیقاً همان بایت مسیر FP32 را مینویسد و در سایر موارد تنها یک کد فاصله دارد. مقاله ثابت میکند که کران تغییرات کل (Total Variation Bound) در هر سطر زیر ۳.۶۴٪ است و میانگین اندازهگیری شده در ۲۰۴.۸ هزار سطر توجه مدل Wan2.2 تنها ۱.۶٪ است. لازم به ذکر است که ExpCast-FP8 فقط برای هسته ۸ بیتی اعمال میشود، زیرا NVFP4 فاقد یک نگاشت خطی تکگانه از لگاریتم به کد است.
برای بهینهسازی بیشتر، ادغام دستی کدهای CUDA/CuTe در زنجیره پیشپردازش باعث شد زمان فراخوانی V-Smooth روی B200 از ۴۲.۲ میلیثانیه به ۴.۸ میلیثانیه کاهش یابد.
بنچمارکهای عملکرد
آزمایش روی چهار مدل با وزنهای باز (Open Weights) شامل Wan2.2-T2V-A14B، LongCat-Video، HunyuanVideo-1.5 و MiniMax-H3 نتایج خیرهکنندهای را نشان داد. کیفیت (Fidelity) در برابر خروجیهای BF16 FlashAttention-4 روی ۱۰۰ پرامپت سنجیده شد:
- B200 (۸ بیت): ۱.۵۹ برابر شتاب در توجه / ۱.۱۹ برابر شتاب کلی (End-to-End).
- H200 (۸ بیت): ۱.۴۶ برابر شتاب در توجه / ۱.۱۳ برابر شتاب کلی.
- RTX PRO 6000 (۴ بیت): ۲.۲۷ برابر شتاب در توجه / ۱.۳۶ برابر شتاب کلی.
- RTX 5090 (۴ بیت): ۳.۵۸ برابر شتاب در توجه / ۱.۷۰ برابر شتاب کلی.
در پردازنده B200، سیستم VC-Attention حدود ۶.۰۲ برابر سریعتر از SageAttention2 عمل میکند. از نظر کیفیت، V-Smooth در مدل Wan2.2 حدود ۲.۳ دسیبل (dB) و در HunyuanVideo-1.5 حدود ۲.۸ دسیبل به معیار PSNR اضافه میکند. افزودن ExpCast-FP8 این مقدار را ۰.۷ تا ۲.۱ دسیبل کاهش میدهد اما همچنان در هر چهار مدل از SageAttention2 بهتر عمل میکند. در دقت ۴ بیتی، V-Smooth در مدل Wan2.2 حدود ۲.۹ دسیبل و در LongCat-Video حدود ۳.۶ دسیبل از SageAttention3 پیشی میگیرد.
این دستاورد فرضیه قدیمی را که «کوانتش کمبیت لزوماً منجر به افت شدید کیفیت در ویدیوها میشود» به چالش میکشد. Nunchux AI ثابت کرد که با هدف قرار دادن باقیماندهها بهجای مقادیر خام، میتوان حتی از توجه برقآسا (FlashAttention-4) با دقت BF16 پیشی گرفت. برای مثال، در مدل MiniMax-H3 با رزولوشن ۱۳۴۴×۷۶۸، توجه روی B200 با سرعت ۱.۶۰ برابر بیشتر و PSNR معادل ۲۰.۲ دسیبل اجرا میشود (در مقابل ۱۹.۹ دسیبل برای SageAttention2). در مورد B300، مقاله شتاب ۱.۴۷ برابر را در مقابل ۱.۳۱ برابر برای یک هسته FP8 ساده گزارش میکند، در حالی که وبلاگ عدد ۱.۵۱ برابر را ذکر کرده است. افزونه اختصاصی Nunchux به شتاب ۱.۹۱ برابر روی B200 و ۱.۸۳ برابر روی B300 برای MiniMax-H3 دست مییابد.
به دلیل ساختار ماژولار و اینکه VC-Attention تنها هزینههای هر تعامل (Per-interaction) را تغییر میدهد، با متدهای توجه پراکنده (Sparse Attention) مانند Sparse VideoGen و Radial Attention سازگار است. این قابلیت اجازه میدهد تا بدون تغییر در معماری مدل، در استکهای اجرای چند-GPU، جریانهای کاری distillation و معماریهای گستردهتر ادغام شود. این رویکرد بهینهسازی لایههای پایین، مشابه تلاشاتی است که در سایر حوزههای استنتاج سریع دیده میشود؛ برای نمونه، زیرساخت Preterview با بهینهسازی استریم توانست تأخیر عاملهای صوتی را به شدت کاهش دهد تا تجربه کاربر در لحظه بهبود یابد.
در حالی که تحقیقات اصلی VC-Attention عمومی شده است، Nunchux AI در حال حاضر یک افزونه اختصاصی را در استک خود اجرا میکند. کاربران میتوانند برای تجربه این بهینهسازیها در مدل MiniMax-H3، از طریق لیست انتظار Modelverse این شرکت درخواست دسترسی دهند.
گام بعدی شما
- اگر از مدلهای Wan2.2 یا HunyuanVideo استفاده میکنید، بررسی کنید که آیا هستههای بهینهشده برای RTX 5090 در کتابخانههای استنتاج شما فعال است یا خیر.
- برای تجربه این بهینهسازیها در مدل MiniMax-H3، میتوانید در لیست انتظار Modelverse شرکت Nunchux ثبتنام کنید.
- در پروژههای تولید ویدیو، اولویت را بر استفاده از کوانتش ۴ بیتی با متد V-Smooth بگذارید تا تعادل بهینه بین سرعت و کیفیت (PSNR) برقرار شود.
اما بهینهسازی نرمافزاری تنها نیمی از داستان است؛ اثر سختافزارهای نسل جدید بر استنتاج مدلهای چندوجهی را در گزارش بعدی بررسی خواهیم کرد.



گفتگو