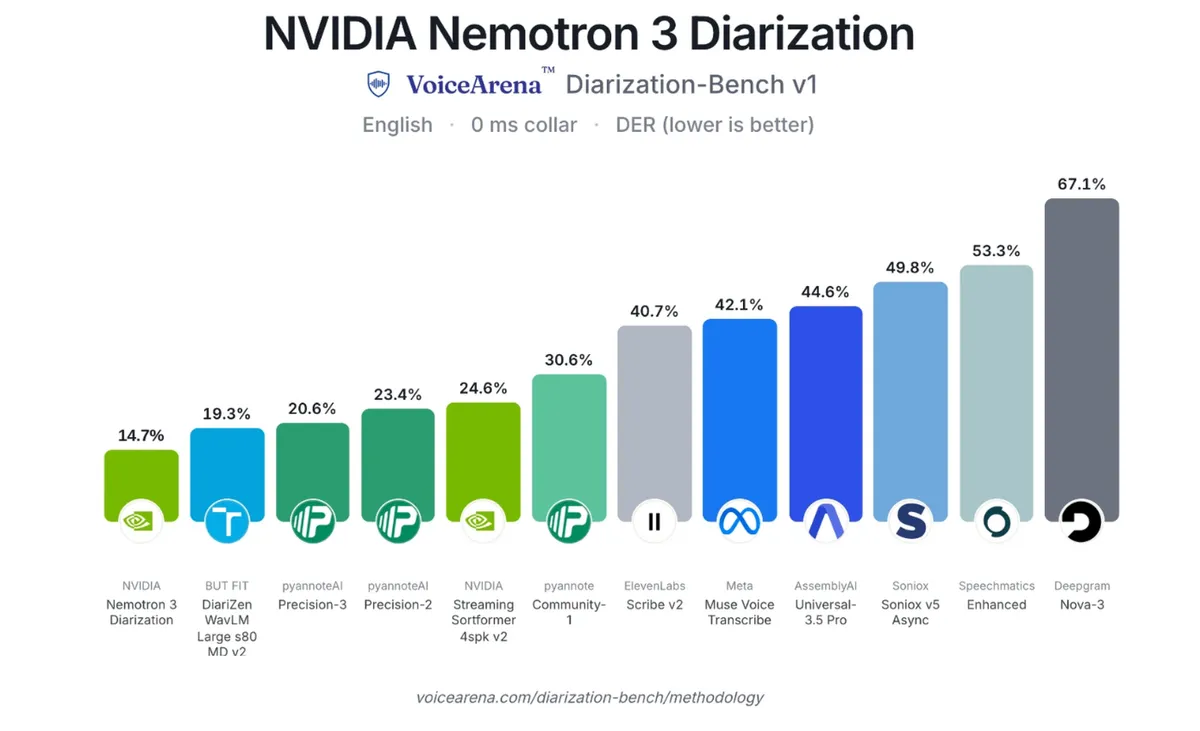
اگر در حال مدیریت جلساتی با چندین شرکتکننده هستید، احتمالاً میدانید که تبدیل گفتار به متن بدون دانستن اینکه «چه کسی چه گفت»، عملاً بیفایده است. مدل Nemotron 3 Diarization (تفکیک گوینده) دقیقاً همین شکاف را پر میکند تا متنها از یک توده کلمات به یک گفتگوی سازمانیافته تبدیل شوند. این مدل با نرخ خطای ۱۴.۷۲٪ (DER)، جایگاه نخست جدول VoiceArena Diarization-Bench را به دست آورده است.
این مدل با ۱۰۰ میلیون پارامتر و وزنهای باز (Open Weights) — یعنی دستور پخت مدل علناً منتشر شده تا هر کسی بتواند آن را اجرا کند — مشکل تخصیص هر جمله به گوینده درست را حل میکند. هدف اصلی این است که ترنسکریپتها نهتنها کلمات را ثبت کنند، بلکه آنها را بهدرستی به شرکتکننده مربوطه نسبت دهند.
بسیاری از سامانههای بازشناسی گفتار فقط «چه چیزی» گفته شد را میفهمند، اما در تشخیص «چه کسی» گفت، شکست میخورند. بدون تفکیک گوینده، صورتجلسات شبیه به دیواری از متن میشوند که در آن تعهدات و اعتراضات ناشناس میمانند. شما میتوانید کلمات را بخوانید، اما نمیتوانید با اطمینان بگویید چه کسی تعهدی داده، چه کسی اعتراضی کرده یا کدام شرکتکننده حرف دیگری را قطع کرده است. این موضوع باعث میشود جستجو، خلاصهسازی، استخراج موارد اقدام (Action Items)، تحلیلهای گفتگو و حافظه عاملهای صوتی بهطور قابلتوجهی کمفایده شوند. همانطور که در تحلیل قبلی ما دربارهی پشتههای چندوجهی و ترجمهٔ بلادرنگ برای رباتیک اشاره کردیم، این پیشرفت لایه حیاتی «هویت» را به جریان صوتی اضافه میکند. در همین راستا، رقابت برای کاهش نرخ خطای تبدیل گفتار به متن شدت یافته است، بهطوری که مدل Muse Voice متا توانست این نرخ را به ۳.۱٪ برساند.
به نقل از گزارش فنی منتشر شده در ۲۳ سپتامبر ۲۰۲۶، این مدل واقعیتهای پیچیده گفتگوهای انسانی، از جمله صحبتهای همزمان (Overlapping Speech) و وقفههای طولانی بین نوبتهای صحبت را مدیریت میکند. این سیستم از حداکثر ۸ گوینده در هر دو حالت پخش زنده (Live) و فایلهای ضبطشده پشتیبانی میکند.
معماری ورود
مدل Nemotron 3 از رویکرد Sortformer برای حفظ پایداری گوینده استفاده میکند. بهجای اختصاص شناسههای تصادفی، گویندگان را بر اساس زمان اولین حضورشان در صوت مرتب میکند؛ اولین صدای شناسایی شده تبدیل به speaker_0، دومین صدا به speaker_1 و به همین ترتیب ادامه مییابد. این روش ترتیببندی بر اساس زمان ورود، نیاز به حل جایگشتهای جدید گوینده برای هر تکه (Chunk) از صوت را از بین میبرد. این یک نقطه شکست رایج در سیستمهای استریمینگ است، جایی که ممکن است یک گوینده پس از یک دوره سکوت، بهاشتباه به کانال متفاوتی اختصاص یابد.
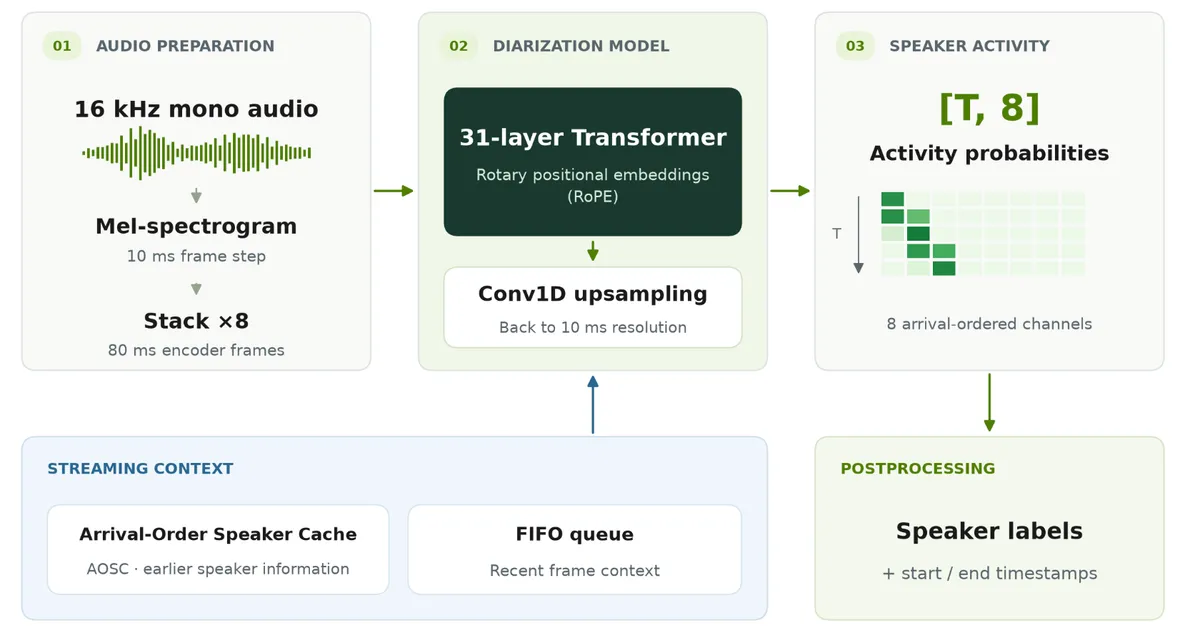
این مدل صوت تککاناله ۱۶ کیلوهرتزی را پردازش کرده و آن را به ویژگیهای طیفنگاشت مل (Mel-spectrogram) با گام فریم ۱۰ میلیثانیه تبدیل میکند. این ویژگیها با ضریب ۸ روی هم انباشته میشوند تا فریمهای ۸۰ میلیثانیهای برای یک رمزگذار ترنسفورمر ۳۱ لایه با رمزگذاریهای موقعیتی دورانی (RoPE) تولید شود. در بالای ترنسفورمر، یک لایه Conv1D پیشبینیها را دوباره به رزولوشن ویژگیهای ورودی ارتقا (Upsample) میدهد. خروجی پیشفرض یک تنسور اعشاری [T, 8] است که T گام زمانی در مقابل ۸ کانال احتمالی گوینده را نشان میدهد و هر مقدار، احتمال فعال بودن یک گوینده در آن لحظه است.
برای مدیریت پخش زنده (Streaming)، سیستم از دو مکانیسم حافظه خاص استفاده میکند:
- حافظه موقت گوینده بر اساس ترتیب ورود (AOSC): اطلاعات مفید درباره گویندگان مشاهده شده در تکههای قبلی را نگه میدارد که بر اساس کانالهای ترتیب ورود سازماندهی شدهاند.
- صف FIFO: بستر متنی فریمهای اخیر را که بلافاصله پیش از تکه فعلی قرار دارند، فراهم میکند.
علاوه بر این، بافر ورودی شامل «بستر متنی راست» (Right Context) است؛ یعنی صوتی که بلافاصله پس از تکه فعلی میآید. بستر متنی راستِ بیشتر به مدل کمک میکند تا انتقال بین گویندگان را بهتر تفسیر کند، در حالی که بستر کمتر، زمانی را که سیستم باید پیش از تولید نتیجه منتظر بماند، کاهش میدهد. ترکیب تکه فعلی، بستر راست، صف FIFO و حافظه گوینده، این امکان را فراهم میکند که یک مدل در چندین نقطه تأخیر (Latency) مختلف عمل کند. استنتاج تکهای (Chunked Inference) باعث میشود محدودیت حداکثری مدل برای مدت زمان صوت از بین برود.
دادهها و آموزش
مدل Nemotron 3 Diarization با ترکیبی از دادههای گفتاری عمومی و لایسنسشده آموزش دیده است. بخش قابلتوجهی از این دادهها شامل گفتگوهای واقعی با برچسبهای چندگوینده بود که از شرکت David AI خریداری شدهاند.
پشتیبانی زبانی و دادههای شبیهسازی شده:
- پشتیبانی زبانی: دادههای لایسنسشده David AI مواد اولیه لازم برای شبیهسازیهای مقیاس بزرگ انگلیسی و ترکیبی از ۲۱ زبان مختلف را فراهم کرد.
- تأثیر بر دقت: اضافه شدن دادههای David AI باعث شد نرخ خطای ترکیبی تفکیک (DER) به میزان ۰.۷۷ نقطه مطلق کاهش یابد و از ۱۱.۱۹٪ به ۱۰.۴۲٪ در هر دو نقطه عملیاتی (سبک آفلاین و تأخیر فوقکم) برسد.
باید توجه داشت که مدل برچسبهای ناشناس (مثل speaker_2) میدهد، نه نام واقعی افراد. برنامههای کاربردی پاییندستی باید این شناسهها را با استفاده از متادیتای جلسه، پروفایلهای کاربر یا مدلهای تأیید هویت صوتی فعال، به افراد واقعی نگاشت کنند.
محکها و عملکرد
در ارزیابی VoiceArena که شامل ۱۳۹ گفتگوی انگلیسی به مجموع ۲۲ ساعت صوت بود، Nemotron 3 به DER ۱۴.۷۲٪ رسید. این رقم نشاندهنده یک کاهش نسبی ۲۴ درصدی در خطا نسبت به سیستم رتبه دوم است که امتیاز ۱۹.۳٪ را کسب کرده بود. این مدل همچنین در هر دو نوع ضبطهای حضوری و آنلاین رتبه اول را به دست آورد و برتری خود را با استفاده از کالرهای (Collars) ۱۰۰ میلیثانیه و ۲۵۰ میلیثانیه حفظ کرد.
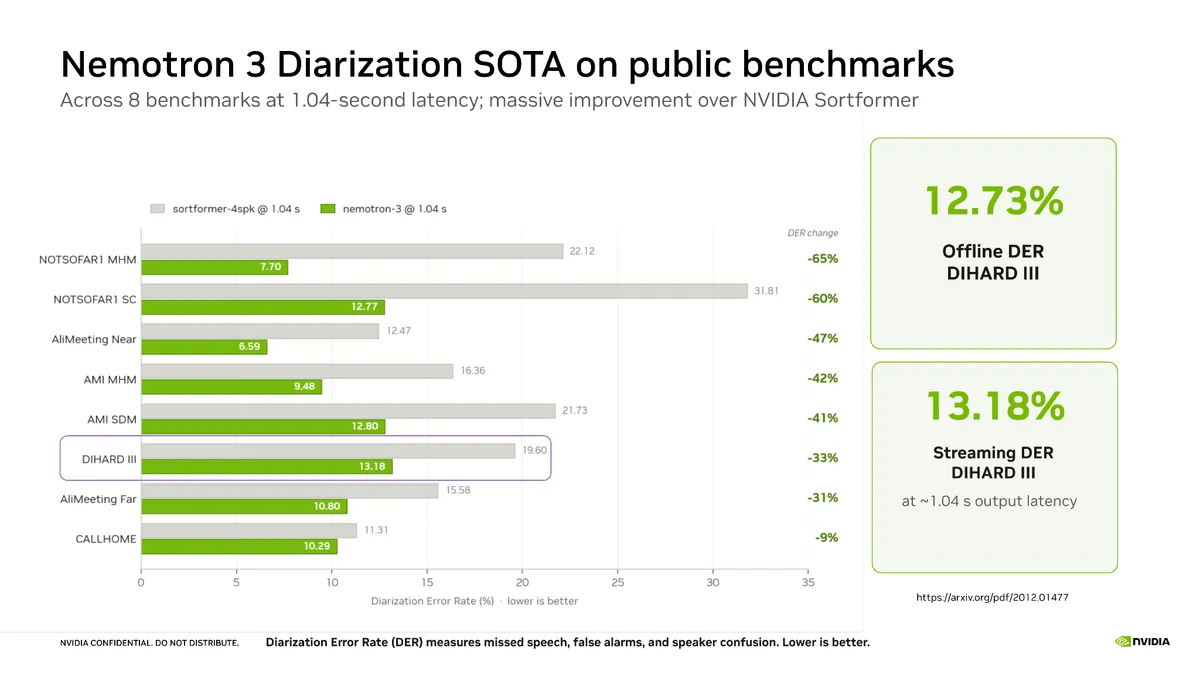
مقایسه با نسل قبلی انویدیا (Streaming Sortformer 4spk - نسخه v2.1) نتایج خیرهکنندهتری دارد. در تأخیر بافر ورودی ۱.۰۴ ثانیه، این مدل بهطور میانگین ۴۱٪ کاهش نسبی در DER را در ۸ محک عمومی نشان داد. این روند بهبود سریع در دقت تبدیل گفتار به متن در سایر مدلها نیز دیده میشود؛ برای مثال مدل Grok Voice Transcribe 2.0 توانست دقت خود را دو برابر کند.
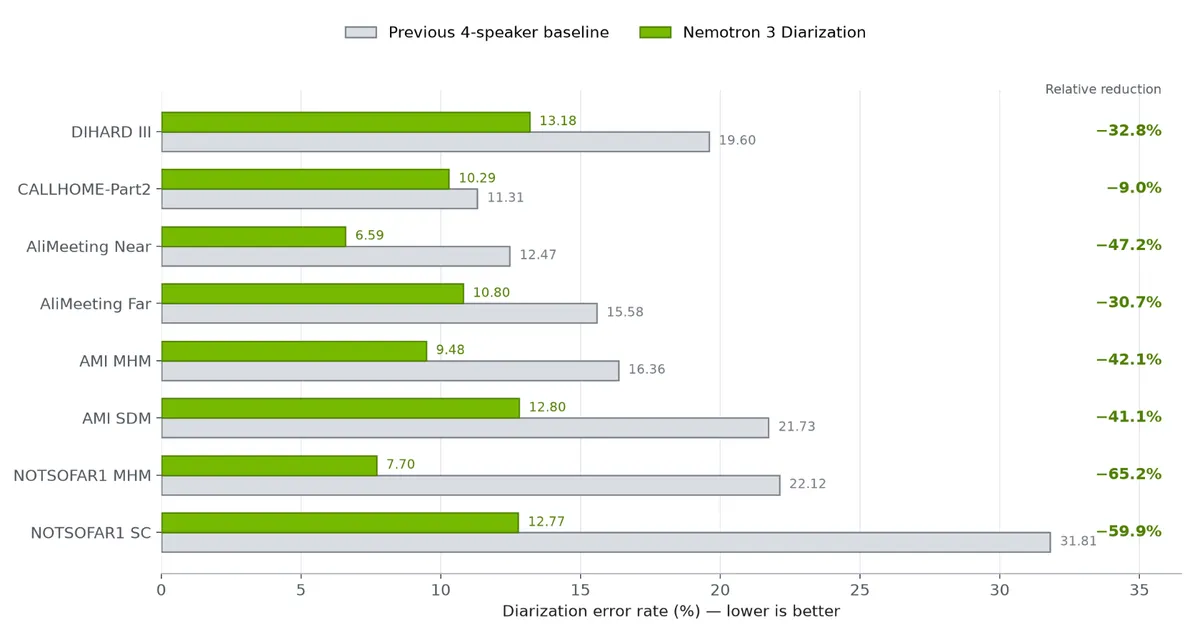
بهبودها بسته به مجموعه داده متفاوت بود؛ از ۹.۰٪ بهبود در CALLHOME-Part2 تا کاهش عظیم ۶۵.۲ درصدی خطاها در NOTSOFAR1 MHM. این ارزیابی شامل ۹۰۱ ضبط خاص شامل گفتارهای تلفنی، جلسات، میکروفونهای میدان نزدیک و دور، و محیطهای صوتی دشوار بود. همپوشانی گفتار در تمام این ارزیابیها امتیازدهی شد.
عملکرد در گروههای شلوغ
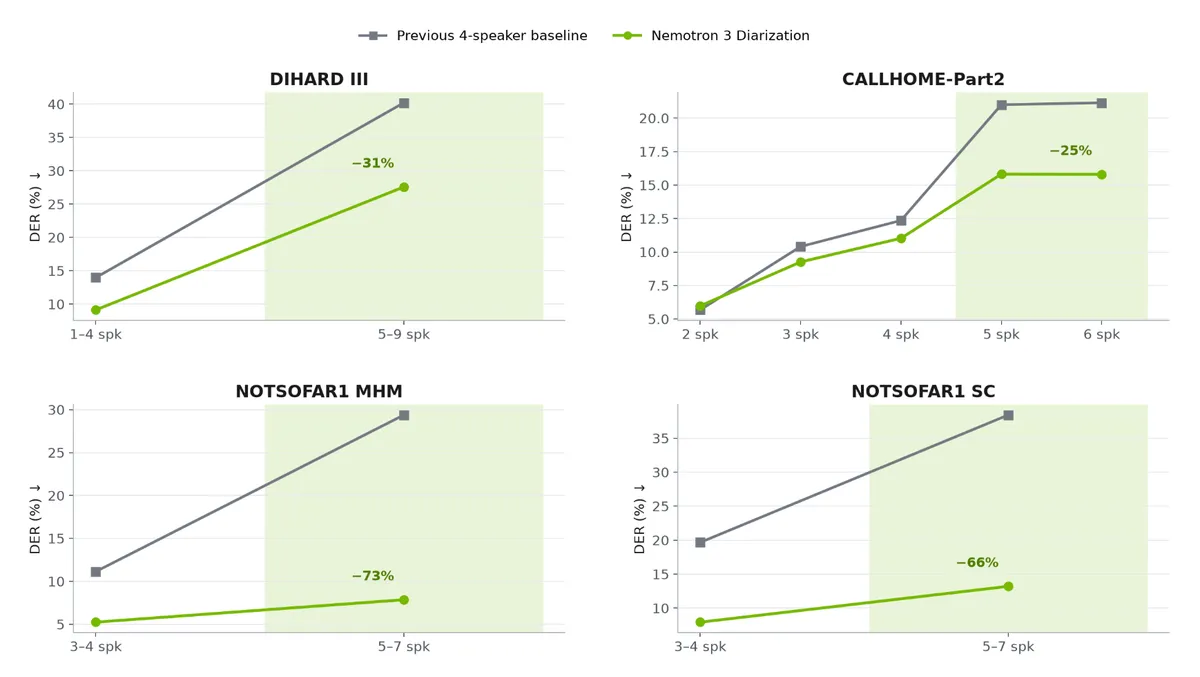
برتری این مدل در سناریوهایی با بیش از ۴ گوینده بهطور قابلتوجهی افزایش مییابد، جایی که مدلهای قبلی معمولاً شکست میخورند.
- بهبود در مجموعههای داده: بیشترین پیشرفتها در زیرمجموعههای با تعداد گوینده بالاتر در DIHARD III، CALLHOME-Part2 و NOTSOFAR1 مشاهده شد.
- جزئیات در گروههای کوچک: در زیرمجموعه دو نفره CALLHOME، مدل نهایی DER ۵.۹۸٪ را ثبت کرد در حالی که مدل قبلی ۵.۶۸٪ بود؛ این نشان میدهد که دستاوردهای اصلی در محیطهای پیچیده و چندنفره محقق شده است. با این حال، در کل ارزیابی CALLHOME-Part2، نرخ DER از ۱۰.۳۲٪ به ۹.۱۰٪ بهبود یافت.
- محدودیتها: در حالی که DIHARD III شامل ضبطهایی با حداکثر ۹ گوینده است، Nemotron 3 حداکثر از ۸ گوینده پشتیبانی میکند. در نتیجه، نتیجه کلی DIHARD III شامل صوتی است که خارج از محدودیت تعداد گوینده مشخص شده قرار دارد.
موازنه تأخیر و دقت
توسعهدهندگان میتوانند مدل را در چهار نقطه عملیاتی توصیه شده تنظیم کنند تا سرعت را در برابر دقت موازنه کنند. تأخیر بافر ورودی به صورت (CHUNK_LEN + RIGHT_CONTEXT) × 80 ms محاسبه میشود.
نقاط عملیاتی توصیه شده:
- سبک آفلاین: تأخیر ۳۰.۴ ثانیه (بیشترین دقت). از حافظه گوینده ۲۶۴، FIFO ۴۰، تکه ۳۴۰، بستر راست ۴۰ و دوره بهروزرسانی حافظه ۳۰۰ استفاده میکند.
- تأخیر کم: ۱.۰۴ ثانیه. از حافظه گوینده ۲۶۴، FIFO ۲۶۴، تکه ۹، بستر راست ۴ و دوره بهروزرسانی حافظه ۲۲۲ استفاده میکند.
- تأخیر بسیار کم: ۰.۶۴ ثانیه. از حافظه گوینده ۲۶۴، FIFO ۲۶۴، تکه ۶، بستر راست ۲ و دوره بهروزرسانی حافظه ۲۲۲ استفاده میکند.
- تأخیر فوقکم: ۰.۳۲ ثانیه. از حافظه گوینده ۲۶۴، FIFO ۲۶۴، تکه ۳، بستر راست ۱ و دوره بهروزرسانی حافظه ۲۲۲ استفاده میکند.
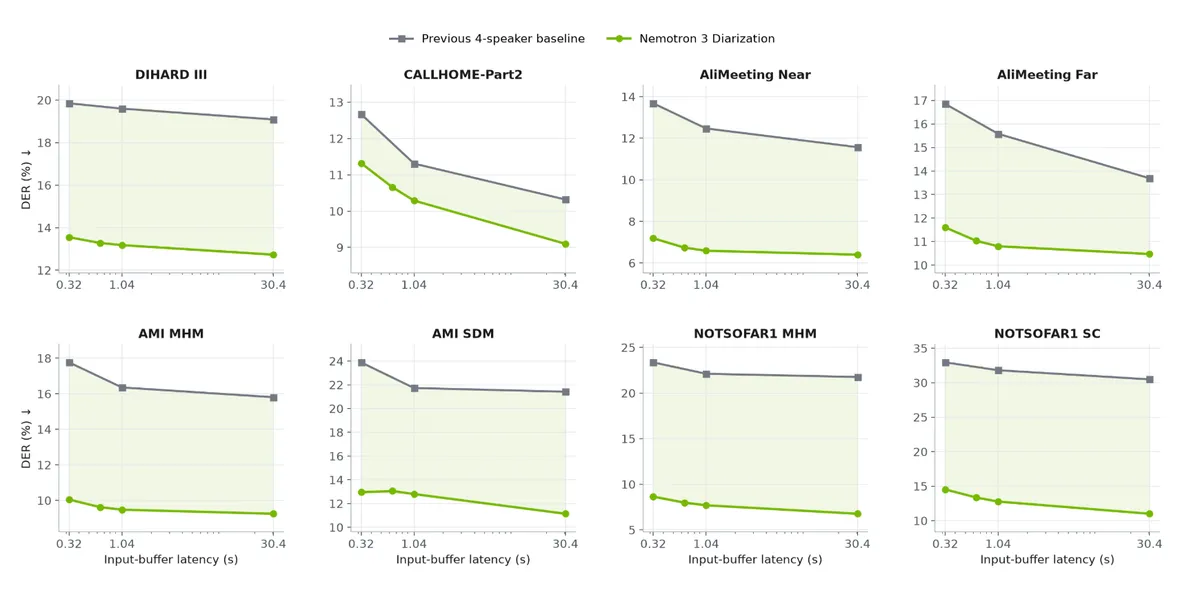
کاهش تأخیر بهطور کلی باعث کاهش دقت و توان عملیاتی (Throughput) میشود. اگرچه مدل از نظر فنی میتواند از بافر ورودی به کوتاهی ۸۰ میلیثانیه استفاده کند، اما ۰.۳۲ ثانیه کمترین پیکربندی توصیه شده است.
بهرهوری محاسباتی
این مدل هنگام استقرار روی سختافزارهای مدرن بسیار بهینه است. با استفاده از NVIDIA RTX PRO 5000 به همراه torch.compile() و دقت BF16 روی بکاند NeMo PyTorch، پیکربندی ۳۰.۴ ثانیهای به سرعت پردازش (RTFx) ۱۵,۱۱۳ برابر در اندازه دسته (Batch Size) ۳۲ رسید، در حالی که این رقم برای مدل قبلی ۲,۶۱۹ برابر بود.
در پیکربندی ۱.۰۴ ثانیهای، سرعت به ۸۶۵ برابر رسید (در مقابل ۱۳۶ برابر برای مدل پایه)، در حالی که همزمان DER در DIHARD III را از ۱۹.۶۰٪ به ۱۳.۱۸٪ کاهش داد.
ادغام با بازشناسی گفتار (ASR)
باید بین تفکیک گوینده و بازشناسی گفتار (ASR) تفاوت قائل شد. تفکیک گوینده فعالیت گوینده و برچسبهای زمانی را تولید میکند، نه کلمات را. ASR متن را تولید میکند اما لزوماً تخصیص گوینده را حفظ نمیکند. یک خط لوله ترنسکریپشن کامل با تخصیص گوینده، هر دو را ترکیب میکند.
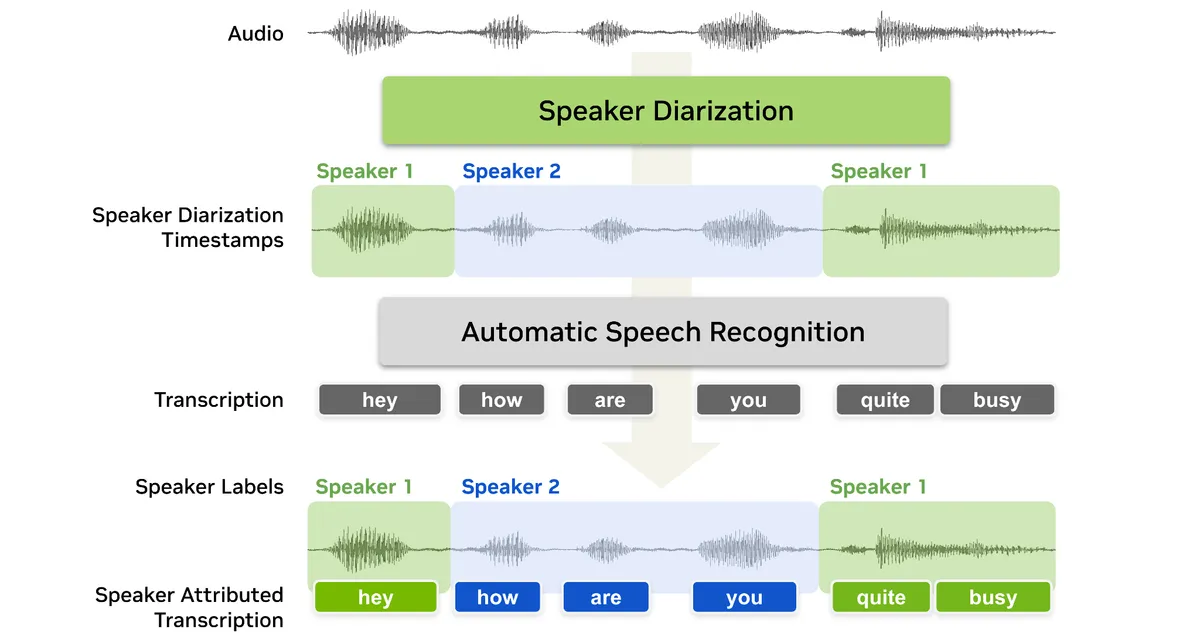
برای پیادهسازی این مورد، توسعهدهندگان میتوانند Nemotron 3 را با مدلهایی مانند Parakeet TDT 0.6B v3 یا Nemotron ASR 3.5 جفت کنند. یک روش رایج، «قانون نقطه میانی» است؛ جایی که یک کلمه به گویندهای اختصاص مییابد که در دقیقاً وسط بازه زمانی آن کلمه فعال بوده است.
جزئیات پیادهسازی
- الزامات ورودی: مدل صوت ۱۶ کیلوهرتزی تککاناله را در فرمتهای .wav, .flac, .opus, .mp3 میپذیرد.
- سختافزار: برای سیستمهای لینوکس با GPUهای NVIDIA Ampere, Hopper یا Blackwell طراحی شده است.
- ترازسازی: قانون نقطه میانی، فعالیتهای همزمان گویندگان را به عنوان «همپوشانی/مبهم» علامتگذاری میکند و کلمات خارج از گفتار تشخیص داده شده را «تخصیصنیافته» باقی میگذارد.
- پیکربندی: توسعهدهندگان باید پنج مقدار پارامتر (حافظه گوینده، FIFO، تکه، بستر راست و دوره بهروزرسانی حافظه) را تنظیم کرده و پیش از اجرای تفکیک، متد
_check_streaming_parameters()را فراخوانی کنند. - فرمت خروجی: متد
diarize()قطعات را بهصورت رشتههایی (مثلاً "0.400 2.100 speaker_0") برمیگرداند.
درک حاشیه خطا
دقت از طریق نرخ خطای تفکیک (DER) اندازهگیری میشود که سه حالت شکست خاص را جمع میکند:
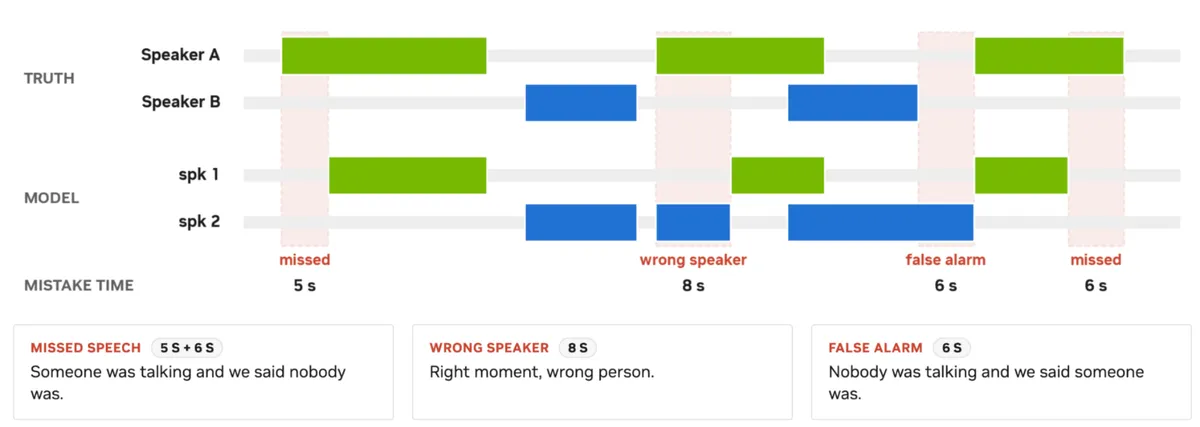
۱. گفتار از دست رفته (Missed Speech): یک گوینده مرجع فعال بود، اما سیستم هیچ گفتاری تشخیص نداد.
۲. هشدار کاذب (False Alarm): سیستم گویندهای را فعال علامت زد در حالی که در مرجع هیچ گفتاری وجود نداشت.
۳. سردرگمی گوینده (Speaker Confusion): سیستم گفتار را در زمان درست تشخیص داد اما آن را به گوینده اشتباه نسبت داد.
این خطاها بر کل زمان گوینده مرجع تقسیم میشوند. تلورانس مرزی (Collars) میتواند این نتایج را بهطور مادی تغییر دهد؛ برای مثال، DIHARD III، AliMeeting، AMI و NOTSOFAR1 از کالر صفر ثانیهای استفاده میکنند، در حالی که CALLHOME-Part2 از کالر ۰.۲۵ ثانیهای استفاده میکند.
استقرار در تولید
برای برنامههای روی دستگاه (On-device)، شرکت Argmax مدل Nemotron 3 Diarization را در Argmax Pro SDK 3 ادغام کرده است. این امر امکان تخصیص گوینده بلادرنگ روی دستگاههای لبه را فراهم میکند و یک API ترنسکریپشن پیش-تفکیک شده معرفی میکند که گویندگان را پیش از بازشناسی گفتار جدا میکند تا وضوح در گفتگوهای پیچیده با گفتارهای همپوشان بهبود یابد.
برای استقرار در مقیاس ابری، انویدیا استفاده از شرکایی مانند Baseten یا Digital Ocean را برای مدیریت نیازهای محاسباتی رمزگذار ترنسفورمر توصیه میکند.
تحلیل: تغییر رویکرد به سمت «چه کسی» در هوش مصنوعی
برای توسعهدهندگان، این تغییر مسیر، تمرکز را از ترنسکریپشن ساده به «هوش گفتگو» (Conversation Intelligence) واقعی منتقل میکند. توانایی پشتیبانی از ۸ گوینده در قالب استریمینگ به این معنی است که هوش مصنوعی اکنون میتواند بهطور واقعبینانه جلسات هیئت مدیره یا پادکستهای گروهی را بدون گم کردن رشته صحبتها مدیریت کند.
انویدیا با باز کردن وزنهای یک مدل ۱۰۰ میلیون پارامتری، مانع ورود برای تفکیک گوینده محلی و خصوصی را کاهش میدهد. این موضوع برای صنایع تحت نظارت که ارسال صوت جلسات حساس به ارائهدهندگان API بسته یک ریسک انطباقی (Compliance Risk) است، حیاتی است. برد واقعی در اینجا فقط امتیاز بنچمارک نیست، بلکه پایداری مکانیسم «ترتیب ورود» است که تفکیک گوینده استریمینگ را برای برنامههای تولیدی عملی میکند.
منتظر ارزیابی کامل نسخه ۱ از VoiceArena باشید که تحلیل آماری دقیقتری از این نتایج در مجموعههای داده چندزبانه ارائه خواهد داد.
گام بعدی شما
- اگر از مدلهای ASR استفاده میکنید، Nemotron 3 را برای تبدیل متنهای خام به گفتگوهای ساختاریافته تست کنید.
- برای کاهش هزینههای ابری، مدل را روی سختافزارهای لبه با استفاده از SDK شرکت Argmax پیاده کنید.
- در صورت کار با دادههای حساس، از قابلیت وزنهای باز این مدل برای استقرار درونسازمانی و حفظ حریم خصوصی استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو