تصور کنید در یک جلسه کاری، سه نفر همزمان با هم صحبت میکنند و سیستمهای ضبط شما نمیتوانند بفهمند هر جمله متعلق به کیست. این همان نقطهای است که Nemotron 3 Diarization وارد میدان میشود تا هر صدا را با دقت میلیثانیهای تفکیک کند.
در ۲۷ سپتامبر ۲۰۲۶، شرکت انویدیا (Nvidia) این مدل فشرده را برای ردیابی لحظهای گویندگان منتشر کرد. این فناوری در واقع یک مدل زبانی کوچک (SLM) — شبیه به یک دستیار متخصص که فقط روی یک مهارت خاص تمرکز کرده تا سریعتر و ارزانتر باشد — است که میتواند صداهای همپوشان را شناسایی کرده و به هر شرکتکننده یک برچسب ناشناس (مثل speaker_2) اختصاص دهد. همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی مدلهای لبه اشاره کردیم، هدف این است که پردازشهای سنگین از ابر به دستگاههای محلی منتقل شوند.
این مدل بهعنوان یک لایه تخصصی عمل میکند که میتوان آن را با سیستمهای تبدیل گفتار به متن مثل Parakeet ترکیب کرد تا متنهای پیادهشدهای کاملاً برچسبدار تولید شوند. این رویکرد در کنار پیشرفتهای اخیر در سرعت پردازش، مانند مدل MAI-Transcribe-2 مایکروسافت که پردازش یک ساعت صوت را به ۱۰ ثانیه کاهش داد، استانداردهای جدیدی را برای بهرهوری در تبدیل گفتار به متن تعریف میکند. طبق گزارش وبسایت the-decoder.com، مشخصات فنی این مدل عبارت است از:
- تعداد پارامترها: ۱۰۰ میلیون پارامتر با وزنهای باز (Open Weights) — یعنی دستور پخت مدل علناً منتشر شده تا هر کسی بتواند آن را اجرا کند.
- ظرفیت: شناسایی تا ۸ گوینده مجزا.
- کنترل تأخیر: چهار سطح بافر صوتی قابل تنظیم از ۰.۳۲ تا ۳۰.۴ ثانیه.
- عملکرد: نرخ خطای ۱۴.۷۲٪ در Diarization-Bench که رتبه نخست جهانی را به آن داده است.
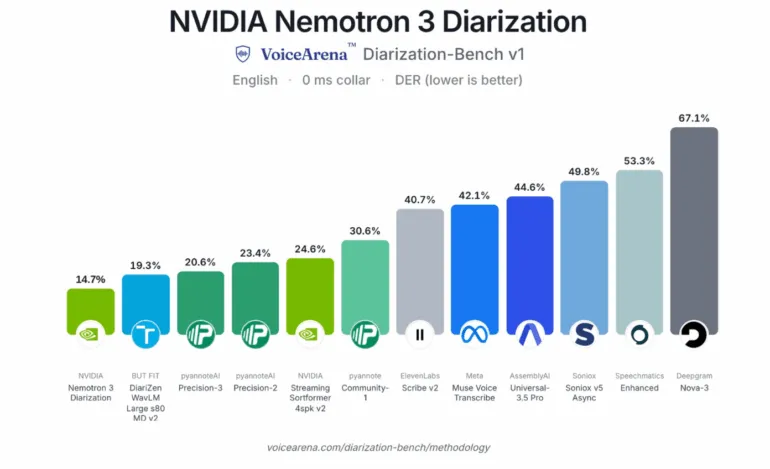
به نقل از مستندات انویدیا، این مدل جهشی بزرگ نسبت به نسل قبلی یعنی Streaming Sortformer است. در حالت بافر ۱.۰۴ ثانیهای, Nemotron 3 نرخ خطای میانگین را در ۸ سناریوی مختلف ۴۱٪ کاهش داده است. با این حال، طبق بررسیها، نویز شدید پسزمینه و بازگشت صدا (Reverb) در اتاقهای بزرگ هنوز باعث افزایش نرخ خطا میشود. این رقابت برای کاهش تأخیر و خطای تشخیص، در راستای دستاوردهای اخیر Nari Labs در شکستن رکوردهای هزینه و تأخیر هوش مصنوعی صوتی است که مسیر را برای کاربردهای بلادرنگ هموارتر کرده است.
برای مدیران کسبوکار، این تغییر به معنای آن است که پیادهسازی سیستمهای دقیق صورتجلسه از APIهای گرانقیمت ابری به استقرار محلی و ارزان منتقل میشود. انویدیا با رایگان کردن وزنهای مدل، سد ورود توسعهدهندگان برای ساخت ابزارهای دسترسیپذیری یا نرمافزارهای خودکار ثبت صورتجلسه را از بین برده است.
گام بعدی شما
- اگر توسعهدهنده هستید، مدل را روی مجموعهدادههای نویزی خود تست کنید تا ببینید آیا نرخ خطای ۱۴.۷٪ در محیط واقعی شما هم تکرار میشود یا خیر.
- ترکیب این مدل با Parakeet را برای ساخت یک سیستم Transcription محلی امتحان کنید.
- تنظیمات بافر صوتی را بر اساس اولویت خود (سرعت در برابر دقت) بهینهسازی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو