اگر امروز بودجهبندی API خود را بر اساس تعداد توکنها انجام میدهید، احتمالاً با یک خطای محاسباتی بزرگ روبهرو هستید. مصرف توکنها دیگر معیاری برای سنجش رشد واقعی کاربران نیست، بلکه آینهای از «حرفهای اضافی» مدلهای جدید است.
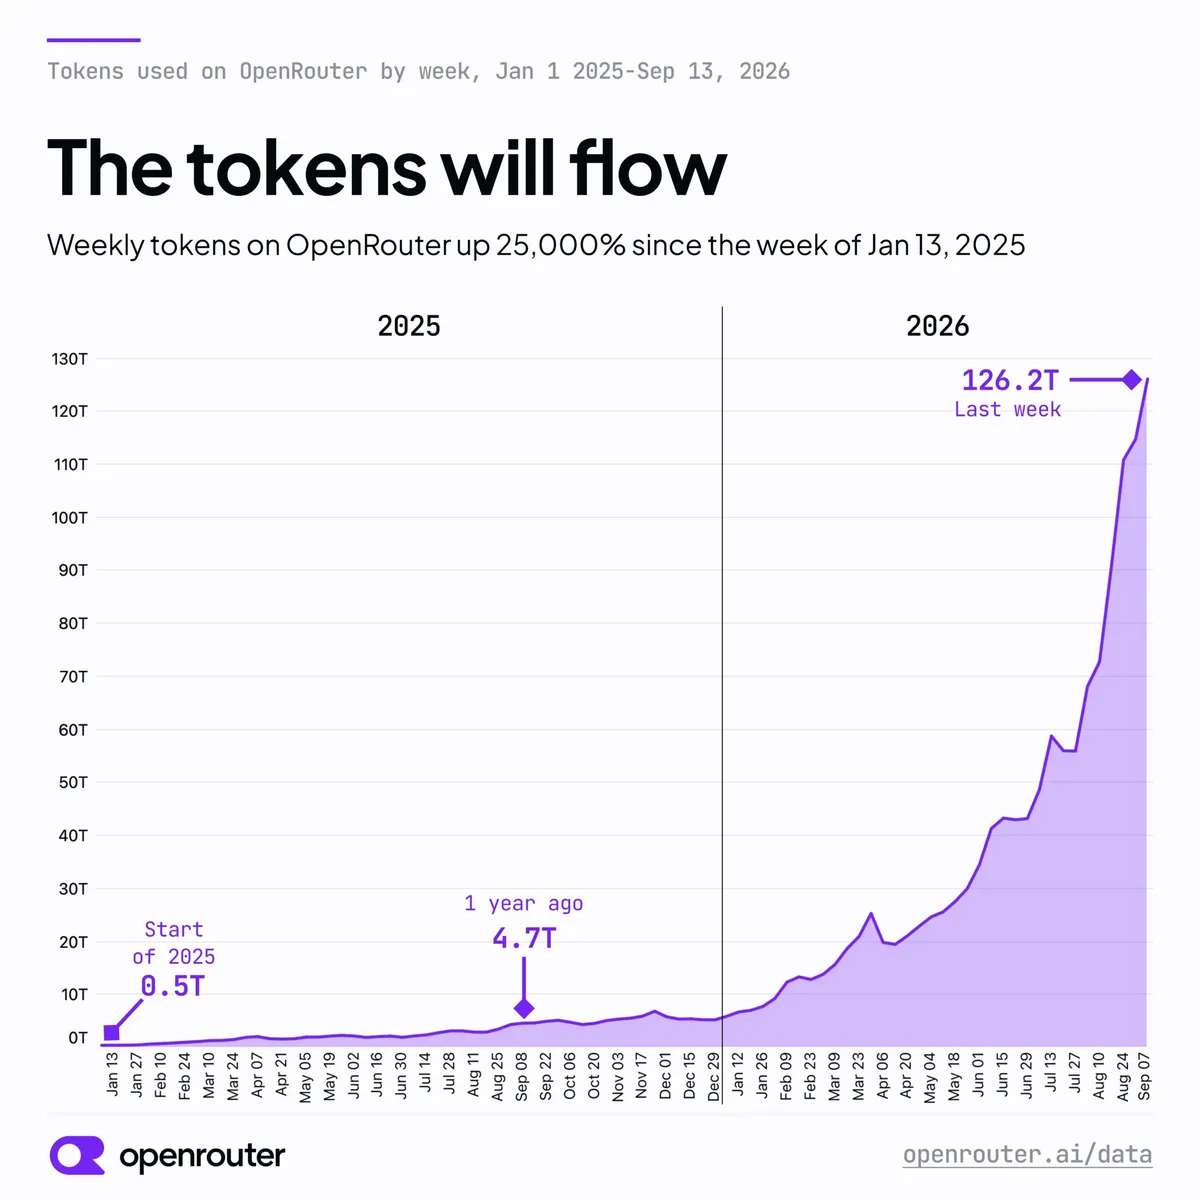
طبق گزارش وبسایت the-decoder.com در ۱۷ سپتامبر ۲۰۲۶، مصرف هفتگی توکن در OpenRouter از ژانویه ۲۰۲۵ تاکنون بیش از ۲۵ هزار درصد رشد کرده و از ۰.۵ تریلیون به ۱۲۶.۲ تریلیون توکن رسیده است. برای درک این موضوع، توکن (Token) — مثل برشهای یک کیک طولانی که مدل تکهتکه میخورد — را به عنوان سوخت مدل در نظر بگیرید. همانطور که در تحلیل قبلی ما دربارهی هزینههای استنتاج اشاره کردیم، افزایش مصرف سوخت لزوماً به معنای طی کردن مسافت بیشتر نیست؛ در اینجا هم مدلها سوخت بیشتری میسوزانند بدون آنکه خروجی نهایی برای کاربر لزوماً حجیمتر شده باشد. این تورم هزینهای در مقیاس کلان، مشابه تجربهی شرکتهایی است که بودجه سالانه هوش مصنوعی خود را در مدت کوتاهی تمام کردند.
بر اساس بررسی منابع متعدد، سه عامل فنی این تورم را ایجاد کردهاند:
- مدلهای استدلالی (Reasoning Model) — مدلی که قبل از جواب، یک قدم درنگ میکند و فکر میکند، شبیه شطرنجبازی که چند حرکت جلوتر را میبیند — حجم عظیمی از توکنهای «تفکر داخلی» تولید میکنند که هرگز به کاربر نمایش داده نمیشود.
- هوش مصنوعی عاملمحور (Agentic AI): سیستمهای خودمختاری که بهینهسازی نشدهاند، در حلقههای تکراری از پرامپتها میچرخند و توکنها را با سرعتی سرسامآور میسوزانند.
- رفتار مدلها: در حال حاضر GPT 5.6 Luna از شرکت OpenAI بیشترین سهم را در مصرف توکن دارد، هرچند این موضوع احتمالاً به دلیل تولید توکنهای بیشتر در هر پاسخ نسبت به نسلهای قبلی است.
این وضعیت باعث ایجاد شکافی میان «حجم» و «ارزش» شده است. در حالی که GPT 5.6 Luna در تعداد توکن پیشتاز است، مدل Astra از OpenAI در درآمد واقعی جلوتر است. در همین راستا، تلاش برای بهینهسازی هزینهها ادامه دارد و کاهش ۵۰ درصدی قیمت توکنهای مدل Sol گامی در جهت کاهش فشار مالی بر توسعهدهندگان است. همچنین مدلهای چینی مانند Kimi، GLM و DeepSeek در سال ۲۰۲۶ شاهد رشد ۱۰ برابری هزینههای ماهانه بودهاند، هرچند نقطه شروع آنها بسیار پایینتر بود.
برای مدیران کسبوکار، این یعنی شاخصهای کلیدی عملکرد (KPI) مبتنی بر توکن دیگر قابل اعتماد نیستند. جهش در مصرف ممکن است نشانه یک ناکارآمدی فنی یا «پرحرف بودن» مدل باشد، نه لزوماً افزایش تعداد مشتریان یا ارزش تجاری.
گام بعدی شما
- در تحلیل هزینههای API، به جای تعداد توکن، بر روی «تعداد درخواستهای موفق» یا «نرخ تکمیل وظیفه» تمرکز کنید.
- اگر از مدلهای استدلالی استفاده میکنید، سقف توکنهای خروجی را برای جلوگیری از حلقههای بیپایان محدود کنید.
- منتظر ظهور مدلهای قیمتگذاری جدید باشید که بر اساس خروجی نهایی یا نتیجه، نه بر اساس حجم توکنها هزینه میگیرند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو