تصور کنید یک مدل هوش مصنوعی با ۲۷ میلیارد پارامتر را بهجای خوشههای عظیم ابری، روی یک لپتاپ معمولی و با مصرف انرژی بسیار کم اجرا کنید. این رویایی که تا پیش از این با افت شدید کیفیت همراه بود، اکنون با یک عدد ملموس به واقعیت تبدیل شده است: حفظ ۹۸.۲ درصد از عملکرد بنچمارکهای کلی در حالی که ردپای حافظه مدل تنها به ۵.۹ گیگابایت کاهش یافته است. این یعنی یک کاهش ۹ برابری در اندازه مدل بدون قربانی کردن هوش معنادار آن.
این دستاورد در ۱۷ سپتامبر ۲۰۲۶ با معرفی مدل Ternary Bonsai 2 27B توسط شرکت PrismML افشا شد. این عرضه در زمانی صورت میگیرد که صنعت هوش مصنوعی در تلاش است تا تقاضا برای مدلهای بزرگتر و توانمندتر را با محدودیتهای فیزیکی سختافزارهای محلی متوازن کند. در حالی که اکثر روشهای فشردهسازی با بیتهای پایین (low-bit compression)، دقت مدل را در کارهای پیچیده مانند کدنویسی یا استفاده از ابزارها بهشدت کاهش میدهند، PrismML مدعی است که توانسته است «شکاف حفظ کیفیت» (retention gap) را برطرف کند. این پیشرفت اجازه میدهد استدلالهای سطح بالا از مراکز داده به ایستگاههای کاری محلی و دستگاههای موبایل منتقل شوند.
زمینه و تکامل
دو ماه پیش، PrismML اولین مدلهای Bonsai 27B را منتشر کرد تا ثابت کند یک مدل چندوجهی در کلاس ۲۷ میلیارد پارامتری میتواند بهطور بهینه روی دستگاههای محلی اجرا شود. آن انتشار اول یک نقطه عطف حیاتی بود، اما مدل جدید Ternary Bonsai 2 27B بر بهبود کیفیت مدل و عملکرد زمان اجرا برای کاربردهای دنیای واقعی تمرکز دارد.
تکامل اصلی در بستن شکاف حفظ کیفیت نهفته است. نسل اول مدلها ۹۵ درصد از قابلیتهای مدل با دقت کامل (full-precision) را حفظ میکردند؛ اما نسخه جدید این رقم را به بیش از ۹۸ درصد رسانده است. این بهبود باعث میشود انتشار فعلی عملاً «بدون تلفات» (lossless) باشد.
به نقل از تحلیل فنی منتشر شده در prismml.com، این مدل بر پایه Qwen3.8 27B توسعه یافته و از یک سیستم وزنهای سهگانه (ternary weight) خاص استفاده میکند. این مدل در واقع نسخهای بهینهشده از معماری علیباباست که پیشتر به عنوان جایگزینی اقتصادی برای APIها معرفی شده بود. مشخصات فنی این مدل عبارت است از:
- نمایش وزنها: وزنهای سهگانه {۱+، ۰، ۱-} با مقیاسبندی گروهی FP16
- دقت مؤثر: ۱.۷۶ بیت بهازای هر وزن
- حجم نهایی: ۵.۹ گیگابایت
- پنجرهٔ زمینه (Context Window): ۲۶۲ هزار توکن
- مجوز: Apache 2.0
- پشتیبانی ورودی: چندوجهی (متن و تصویر)
- مدل پایه: Qwen3.8 27B
جزئیات عملکرد
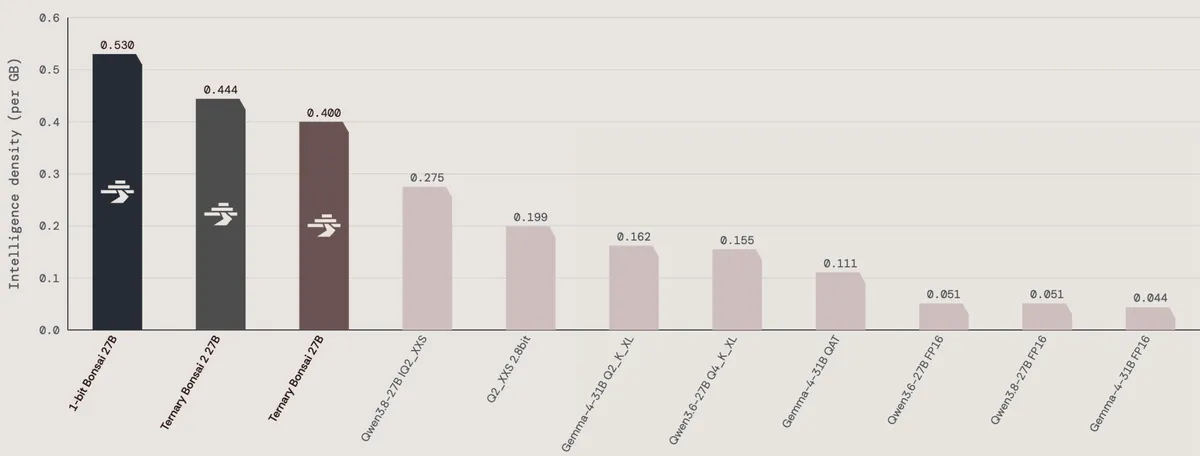
بر اساس مستندات PrismML، بنچمارکهای عملکرد نشان میدهد که این مدل در مجموعهای از آزمونهای استدلال، ریاضی، کدنویسی، پیروی از دستورالعملها، بینایی و استفاده از ابزارهای عاملمحور (agentic tool use)، امتیاز ۸۳.۹ را کسب کرده است. این نتایج در ادامه موفقیتهای مدل پایه است که در وظایف عاملمحور چندوجهی توانست از Opus4.6 Max پیشی بگیرد. PrismML تأکید میکند که حفظ کیفیت در وظایف «افق بلند» (long-horizon) — مانند عاملهای کدنویسی و گردشهای کاری چندوجهی — در بالاترین سطح قرار دارد؛ جایی که خطاهای کوچک معمولاً روی هم انباشته شده و باعث فروپاشی کل سیستم میشوند.
این مدل در زمینه «تراکم هوش» یک استثناست. بسیاری از جایگزینهای کمبیت برای قابل استقرار شدن، باید قابلیتهای معنادار خود را در بخش بینایی یا کدنویسی فدا کنند. در مقابل، Bonsai 2 عملکرد مدل با دقت کامل را در این حوزههای حساس حفظ کرده، در حالی که تنها با کسری از ردپای حافظه عمل میکند.
این موضوع اجازه میدهد مدلهای محلی کارهای تخصصی را بر عهده بگیرند، از جمله:
- حلقههای عامل کدنویسی (مانند استفاده از Cline)
- گردشهای کاری کنترل کامپیوتر (Computer-use workflows)
- تحلیل اسناد محرمانه
- عیبیابی چندوجهی
- هماهنگی ترکیبی برای وظایف حساس یا پرتکرار
از نظر توان عملیاتی (Throughput)، این مدل روی NVIDIA GeForce RTX 5090 به ۱۴۳ توکن در ثانیه و روی M5 Max به ۴۶.۸ توکن در ثانیه میرسد. بهرهوری انرژی نیز به همان اندازه خیرهکننده است؛ در یک RTX 4090، مصرف انرژی ۰.۷۱۴ میلیواتساعت بهازای هر توکن است که طبق ادعای PrismML، ۴۰ درصد بهینهتر از یک مدل ۸ میلیارد پارامتری با دقت کامل است.
برای دستیارهای کدنویسی، این توان عملیاتی امکان ایجاد حلقههای سریعتر «ویرایش-عیبیابی» را فراهم میکند. برای عاملهای چندوجهی، این سرعت اجازه میدهد تکرارهای سریعتری روی فراخوانی ابزارها، اسناد و اسکرینشاتها انجام شود. برای گردشهای کاری محلی، بهرهوری انرژی باعث افزایش عمر باتری شده و اجازه میدهد دستیاران بدون نیاز به فراخوانیهای مداوم ابری، در پسزمینه در دسترس باقی بمانند.
این تغییر، پیشفرضهای مربوط به تراکم هوش را بهطور بنیادی تغییر میدهد. سالها تصور میشد موازنه به صورت دوتایی است: یا باید مدلهای کوچک و ضعیف (مثل ۸ میلیارد پارامتری) را بپذیریم یا برای مدلهای ۲۷ میلیارد پارامتری و بالاتر به ابر متکی باشیم. Ternary Bonsai 2 ثابت کرد که میتوان بدون از دست دادن متناسبِ قابلیتها، محدوده استقرار را گسترش داد.
برای توسعهدهندگان، این به معنای مدیریت وظایف حساس و پرتکرار در محیط محلی است — مانند تحلیل اسناد خصوصی یا عیبیابی چندوجهی در لحظه — بدون اینکه نیاز به ارتقا به ابر باشد. این معماری یک لایه هماهنگی ترکیبی ایجاد میکند که در آن دستگاه محلی به عنوان عامل اصلی عمل کرده و تنها برای موارد بسیار خاص و حاشیه ای (edge cases) به ابر متصل میشود. این رویکرد مشابه بهینهسازیهای پیشرفتهای است که در معماری ترکیبی ZGCM-1 برای موتورهای اجرای کوچکتر به کار گرفته شد.
با کاهش شکاف حفظ کیفیت از ۹۵ درصد در نسل اول به بیش از ۹۸ درصد، PrismML فشردهسازی کمبیت را از یک «سازش همراه با فقدان» به یک استراتژی استقرار عملاً بدون تلفات تبدیل کرد. این موضوع برای مراکز داده نیز پیامدهایی دارد و پتانسیل این را ایجاد میکند که با جای دادن مدلهای بزرگتر در همان حافظه VRAM، کاربران بیشتری بهازای هر GPU سرویس دریافت کنند و انرژی مصرفی بهازای هر استنتاج کاهش یابد.
در حال حاضر کاربران میتوانند این مدل را از طریق CUDA برای پردازندههای انویدیا یا MLX برای دستگاههای اپل (مک، آیفون، آیپد) با استفاده از کرنلهای سفارشی کمبیت مستقر کنند. شرکت PrismML که توسط پژوهشگران Caltech و با حمایت Khosla Ventures, Cerberus، گوگل و سامسونگ تأسیس شده، همچنان بر فشردهسازی شبکههای عصبی بدون قربانی کردن توان استدلال تمرکز دارد.
گام بعدی شما
- اگر از سختافزارهای سری RTX 40 یا 50 استفاده میکنید، مدل را از طریق CUDA برای تست سرعت استنتاج محلی نصب کنید.
- برای تحلیل اسناد محرمانه که نباید به ابر ارسال شوند، این مدل را جایگزین مدلهای ۸ میلیارد پارامتری کنید تا دقت استدلال را بسنجید.
- در محیطهای توسعه، ترکیب این مدل با ابزارهای Agentic را برای کاهش تأخیر در حلقههای کدنویسی امتحان کنید.
اما تأثیر این فشردهسازی بر معماریهای سختافزاری آینده حتی پیچیدهتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو