یک خطای کوچک در دموهای هوش مصنوعی شاید فقط یک باگ ساده باشد، اما شکست یک مؤلفه مشترک در محیط عملیاتی میتواند در لحظهای هزاران رکورد داده را تخریب کند. برای حل این بحران، آکاش راهسی (Aakash Rahsi) در ۱ اکتبر ۲۰۲۶ چارچوب RAHSI را معرفی کرد تا توضیح دهد چرا پایداری سیستمها هنگام انتقال از نسخههای آزمایشی به مقیاس سازمانی فرو میپاشد.
همانطور که در تحلیل قبلی ما دربارهی شکست عاملهای سازمانی در مقیاس تولید اشاره کردیم، مشکل اصلی «شعاع تخریب» (Blast Radius) است. این چالش با نقاط شکست در حاکمیت هوش مصنوعی که پیش از استقرار عملیاتی نادیده گرفته میشوند، همسویی دارد. طبق اعلام راهسی، نرخ خطای ۱٪ شاید کم به نظر برسد، اما در هر میلیون اجرا، ۱۰ هزار رویداد شکست ایجاد میکند. اگر این خطاها باعث تغییر در سوابق سیستمی شوند، هزینه دیگر بر اساس «تعداد دفعات» نیست، بلکه بر اساس «میزان دسترسی و اثرگذاری» محاسبه میشود.
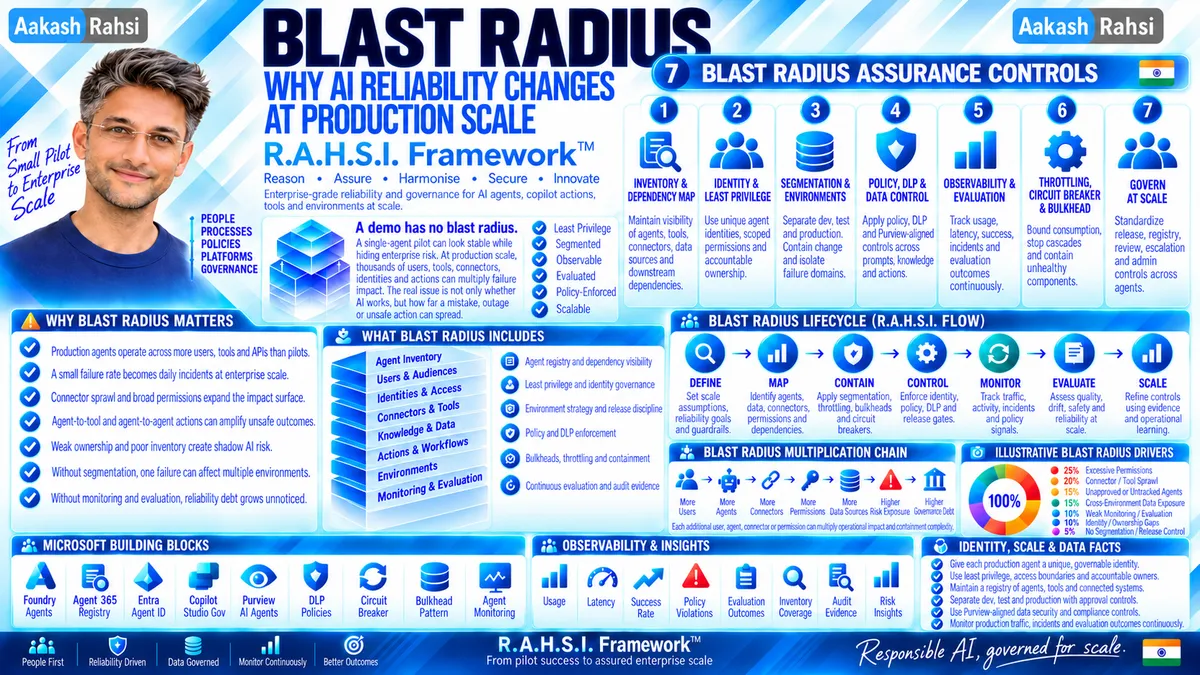
چارچوب RAHSI ریسک را به پنج بُعد قابل بررسی تقسیم میکند:
ابعاد RAHSI
- دسترسی (Reach): شناسایی اینکه یک مسیر خطا به کدام کاربران و سوابق حساس دسترسی دارد. هدف این است که اجازه خواندن داده از اجازه نوشتن و تغییر آن جدا شود.
- اقدام (Action): بررسی اینکه آیا یک پاسخ اشتباه میتواند پیش از شناسایی، یک فراخوانی API یا تغییر در سوابق سیستمی ایجاد کند.
- انتشار (Propagation): نقشهبرداری از عاملهایی که دستورالعملها یا ابزارهای مشترک دارند؛ زیرا یک نقطه شکست میتواند چندین جریان حیاتی را همزمان متوقف کند.
- مهار (Containment): پیادهسازی مرزهای فنی؛ مثل «دیوارههای جداکننده» (Bulkheads) برای ایزوله کردن مؤلفهها، «قطعکنندههای مدار» (Circuit Breakers) برای مسدود کردن وابستگیهای معیوب و «محدودسازی» (Throttling) برای کنترل مصرف. این رویکرد مهارکننده مشابه استراتژی Dusyn برای حذف خطاهای پرداخت است که با استفاده از معماری ماشین حالت، ریسک خطا را به شدت کاهش داد.
- سیاهه (Inventory): ردیابی عاملها از طریق ابزارهایی مانند Microsoft Agent 365، Entra Agent ID و Purview.
بر اساس مستندات این چارچوب، داشتن سیاهه یا لیست عاملها به معنای حاکمیت بر آنها نیست. دانستن اینکه یک عامل (Agent) — شبیه به کارمندی که وظایف خاصی را به طور خودکار انجام میدهد — وجود دارد، بیفایده است مگر اینکه بدانید چه چیزی را تغییر میدهد و چگونه میتوان وضعیت سیستم را پس از یک سقوط بازسازی کرد. سیگنالهای شناسایی مانند Correlation IDها به ردیابی اثرات کمک میکنند، اما نمیتوانند جلوی انتشار خطا را پس از شروع بگیرند.
برای متخصصان، این رویکرد معیار موفقیت را تغییر میدهد. مهندسان دیگر نباید فقط بپرسند «آیا عامل شکست خورد؟»، بلکه باید بسنجند که یک خطا پیش از آنکه توسط معماری مهار شود، تا کجا پیش میرود. این تغییر در معیار سنجش، در راستای جایگزینی مدل ۵ لایهای قابلیت اطمینان به جای SLAهای سنتی است تا دیدگاهی واقعبینانهتر از پایداری سیستم ارائه دهد. این کار مستلزم تست همزمانی، تغییرات دسترسی و شکستهای زنجیرهای در جریانهای حیاتی کسبوکار است.
این تغییر دیدگاه، پایداری هوش مصنوعی را از یک بازی احتمالی (کاهش نرخ خطا) به یک بازی ساختاری (محدود کردن خسارت) تبدیل میکند. سازمانها با پذیرش این واقعیت که شکست اجتنابناپذیر است، به جای امید به عملکرد بینقص مدل، «ردپای شواهدی» برای بازیابی سریع میسازند.
گام بعدی شما
- تمام وابستگیهای مشترک در ناوگان عاملهای خود را نقشهبرداری کنید.
- مرزهای مهار (Containment) را در شرایط شبیهسازیشدهی قطعی سیستم تست کنید.
- دسترسیهای «خواندن» و «نوشتن» را در سطح API برای هر عامل تفکیک کنید.
اما مدیریت این دسترسیها در محیطهای ابری پیچیدگیهای خاص خود را دارد — به بررسی ما دربارهی پروتکل MCP برای مدیریت زمینه مدلها مراجعه کنید.



گفتگو