تصور کنید یک عامل هوش مصنوعی برای باز کردن یک تیکت پشتیبانی درخواست میفرستد، اما پاسخ سیستم با تأخیر یا خطا میرسد؛ حالا عامل در برزخی خطرناک است: آیا تیکت باز نشد، یا سیستم تغییر را ثبت کرد اما پیام تأیید گم شد؟ این عدم قطعیت، هسته اصلی مشکلی است که چارچوب RAHSI (RAHSI Framework™) با مفهومی به نام «یکپارچگی اجرا» حل میکند.
به نقل از یک راهنمای فنی که در ۱ اکتبر ۲۰۲۶ منتشر شد، ناتوانی در تشخیص این وضعیتها اغلب منجر به اثرات تکراری میشود؛ یعنی وقتی عاملها بدون بررسی، عملیاتی را که قابلیت تکرار بدون تغییر (Idempotency) ندارد، دوباره اجرا میکنند. این چالشها دقیقاً همان نقاطی هستند که شکاف عیبیابی در محیطهای عملیاتی را آشکار میکنند و باعث میشوند رفتارهای عامل در دمو با واقعیت متفاوت باشد.
بیشتر جریانهای کاری فعلی، پاسخ سیستم را یا «موفقیت» میبینند یا «شکست». اما در محیطهای سازمانی که عاملها دادهها را جابهجا میکنند یا پرداختهای مالی را فعال میکنند، دریافت پیام «انجام شد» از سوی یک عامل (Agent) — شبیه دستیاری که میگوید «کار را انجام دادم» اما رسید را گم کرده است — لزوماً به معنای ثبت نهایی تراکنش نیست. همانطور که در تحلیل قبلی ما دربارهی محدود کردن «شعاع تخریب» عاملها اشاره کردیم، بازیابی سیستم فراتر از اجرای مجدد یک گام شکستخورده است؛ این کار نیازمند شواهد ماندگاری از اتفاقی است که واقعاً در سیستم خارجی رخ داده است.
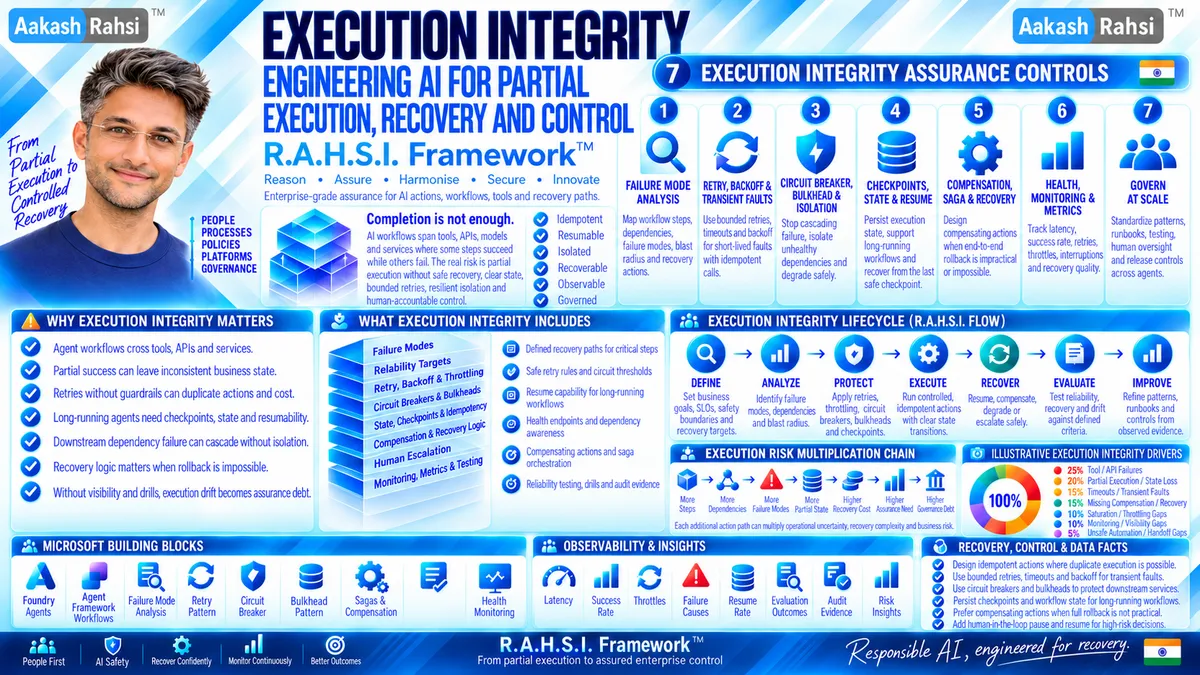
برای ایجاد این یکپارچگی، چارچوب RAHSI چندین کنترل مهندسی مشخص را الزامی میکند:
- تطبیق پیش از تکرار: عاملها هنگام نامشخص بودن وضعیت ثبت، بهجای تکرار فوری، باید ابتدا وضعیت سیستم خارجی را بررسی کنند.
- جبران Saga: چون موفقیتهای جزئی میتوانند تغییرات قبلی را فعال نگه دارند، سیستم باید گامهای برگشتناپذیر را علامتگذاری کرده و از منطق جبرانی برای بازگرداندن تغییرات استفاده کند.
- نقاط بازرسی ماندگار: وضعیت بازیابی باید ذخیره شود تا یک فرآیند مجزا بتواند جریانهای کاری طولانی را از آخرین ثبت تأییدشده ادامه دهد.
- قطعکنندههای مدار (Circuit Breakers): باید دیوارهایی ایجاد شود تا فراخوانیهای مکرر محدود شده و «شعاع تخریب» یک ابزار شکستخورده کنترل شود.
این تغییر در معماری، فرض بنیادی هوش مصنوعی عاملمحور را از «اجرای خوشبینانه» به «وضعیت تأییدشده» تغییر میدهد. این رویکرد با لایه پاسخگویی جدید COGEXT در انتقال وضعیت همسو است که هدف آن پایان دادن به توهمات عملیاتی عاملهای خودکار است. بر اساس مستندات این چارچوب، توسعهدهندگان باید از تکیه بر شناسههای همبستگی (Correlation IDs) — که فقط درخواست را ردیابی میکنند اما حقیقت تراکنش را ثابت نمیکنند — فاصله بگیرند و به سمت مدل «هوش مصنوعی بازسازیپذیر» (Reconstructable AI™) حرکت کنند. در این مدل، تصمیم عامل، فراخوانی ابزارها و وضعیت نهایی سیستم خارجی، همگی به عنوان یک زنجیره شواهد واحد بررسی میشوند.
در نهایت، این رویکرد با تضمین اینکه یک Timeout منجر به پرداخت دوبرابر یا رکورد تکراری نشود، از بودجه کسبوکار و یکپارچگی دادهها محافظت میکند. این چارچوب مهندسان را مجبور میکند پیش از جشن گرفتن موفقیت منطق هوش مصنوعی، برای شکستها برنامهریزی کنند.
گام بعدی شما
- فراخوانیهای ابزاری عاملهای خود را از نظر قابلیت تکرار (Idempotency) بازبینی کنید.
- برای هر هندلرِ Timeout در APIها، یک گام تطبیق وضعیت (Reconciliation) اضافه کنید.
- گامهای برگشتناپذیر در جریانهای کاری خود را شناسایی و منطق جبرانی برای آنها بنویسید.
اما مدیریت این وضعیتها تنها بخشی از چالش است؛ برای درک اینکه چگونه میتوان حافظه بلندمدت را در این ساختارها حفظ کرد، به تحلیل ما درباره ذخیرهسازی محلی مراجعه کنید.



گفتگو