اگر برای سیستمهای failover خود به ثانیهها حساس هستید، انتخاب ارائهدهنده GPU میتواند تفاوت میان پایداری و سقوط سرویس شما باشد. دادههای جدید نشان میدهد که پیشبینیپذیری در سرعت بوت، بسیار حیاتیتر از قدرت خام سختافزار است.
طبق گزارش Kilawatt Cloud که بین ۶ تا ۷ سپتامبر ۲۰۲۶ ثبت شده، RunPod با میانگین زمان بوت ۷.۶۵ ثانیه، سریعترین و پایدارترین گزینه برای بارهای کاری حساس به تأخیر است. این سرعت در واقع همان استنتاج (Inference) — مثل لحظهای که یک آشپز بعد از آمادهسازی، واقعاً شروع به پخت غذا میکند — در سطح زیرساخت است. این تمرکز بر کاهش تأخیر در زیرساخت، با روندی همسو است که در آن مدلهای کوچکتر برای بهبود تجربه کاربری و کاهش زمان پاسخدهی در حال پیشی گرفتن از مدلهای غولپیکر هستند.
همانطور که در تحلیلهای قبلی ما درباره بهینهسازی هزینههای محاسباتی اشاره کردیم، توازن میان هزینه و سرعت همیشه چالشبرانگیز است. در دنیای واقعی، تفاوت میان یک میزبان «گرم» و «سرد» میتواند زمان انتظار شما را از چند ثانیه به چند دقیقه تغییر دهد.
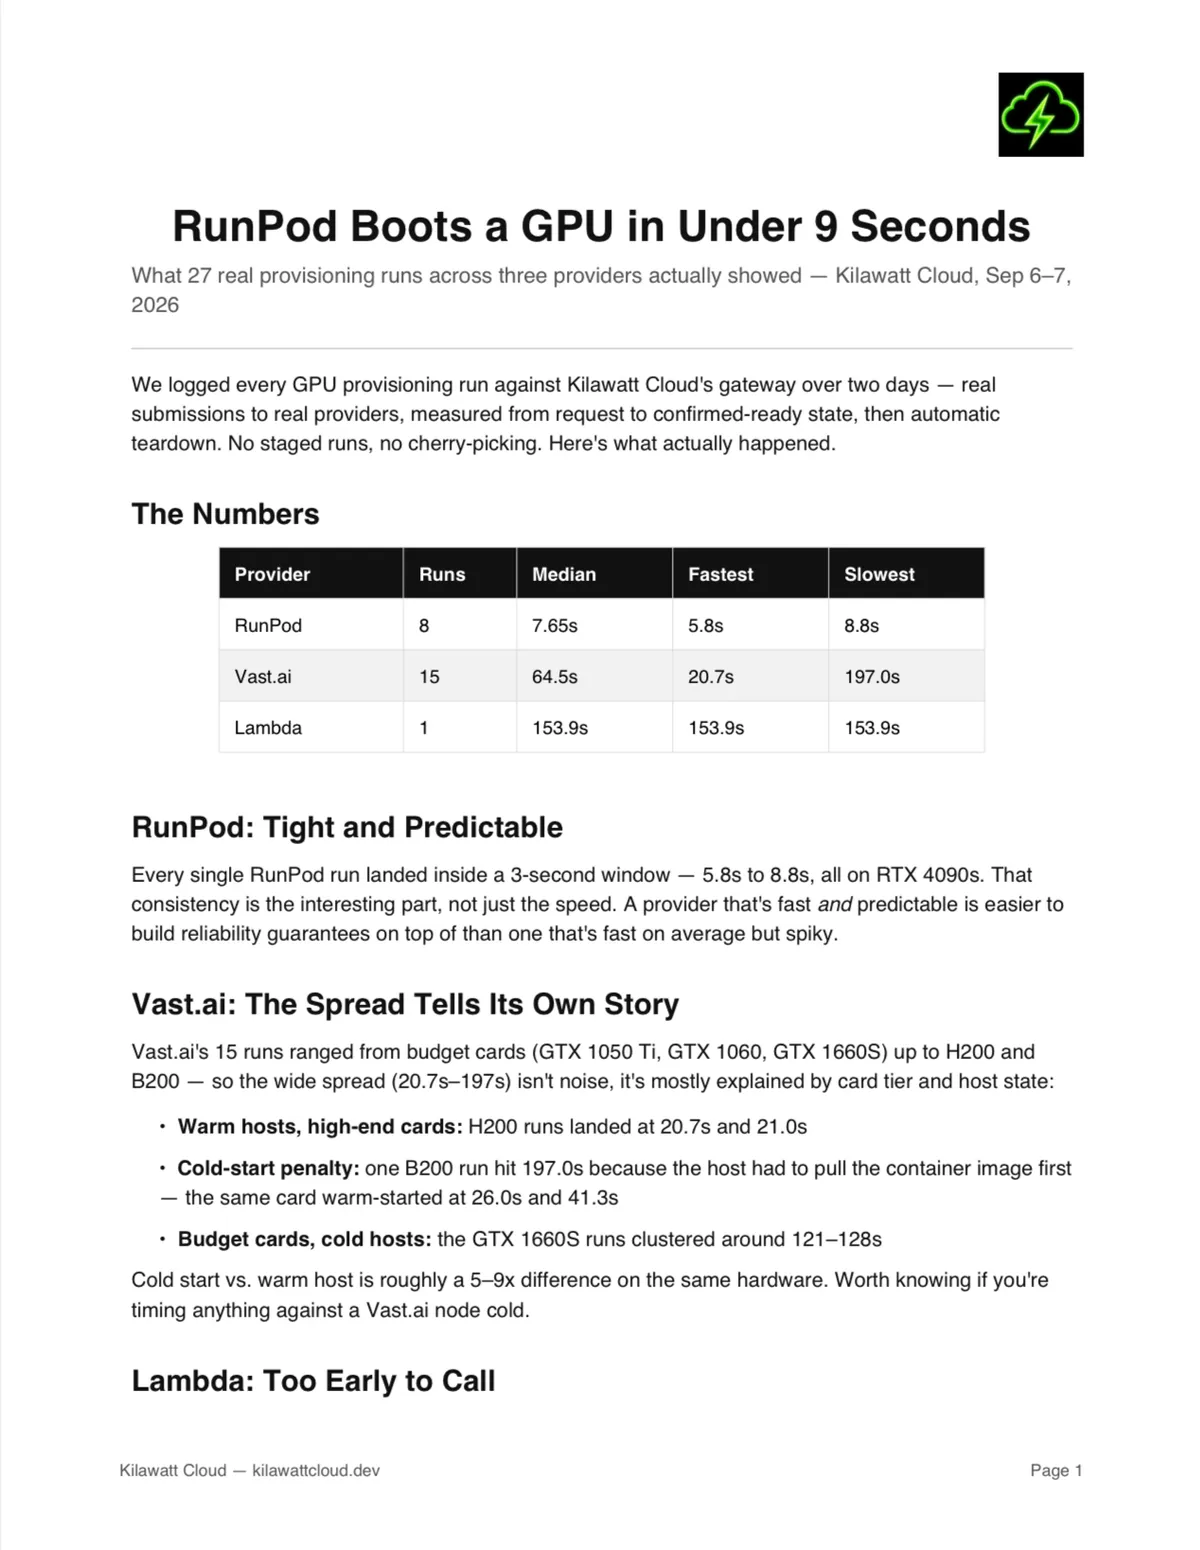
به نقل از گزارش dev.to، جزئیات عملکرد در ۲۷ اجرای مختلف به این شرح است:
- RunPod: ثبات خیرهکننده؛ تمام اجراهای RTX 4090 بین ۵.۸ تا ۸.۸ ثانیه به پایان رسیدند.
- Vast.ai: نوسان شدید (۲۰.۷ تا ۱۹۷ ثانیه). کارتهای H200 حدود ۲۱ ثانیه زمان بردند، اما یک مورد راهاندازی سرد (Cold Start) — شبیه وقتی که باید تمام وسایل آشپزی را از انبار بیرون بیاورید تا بتوانید یک تخممرغ آبپز کنید — زمان را به ۱۹۷ ثانیه رساند.
- Lambda: دادههای ناکافی؛ تنها یک اجرا با زمان ۱۵۳.۹ ثانیه ثبت شد.
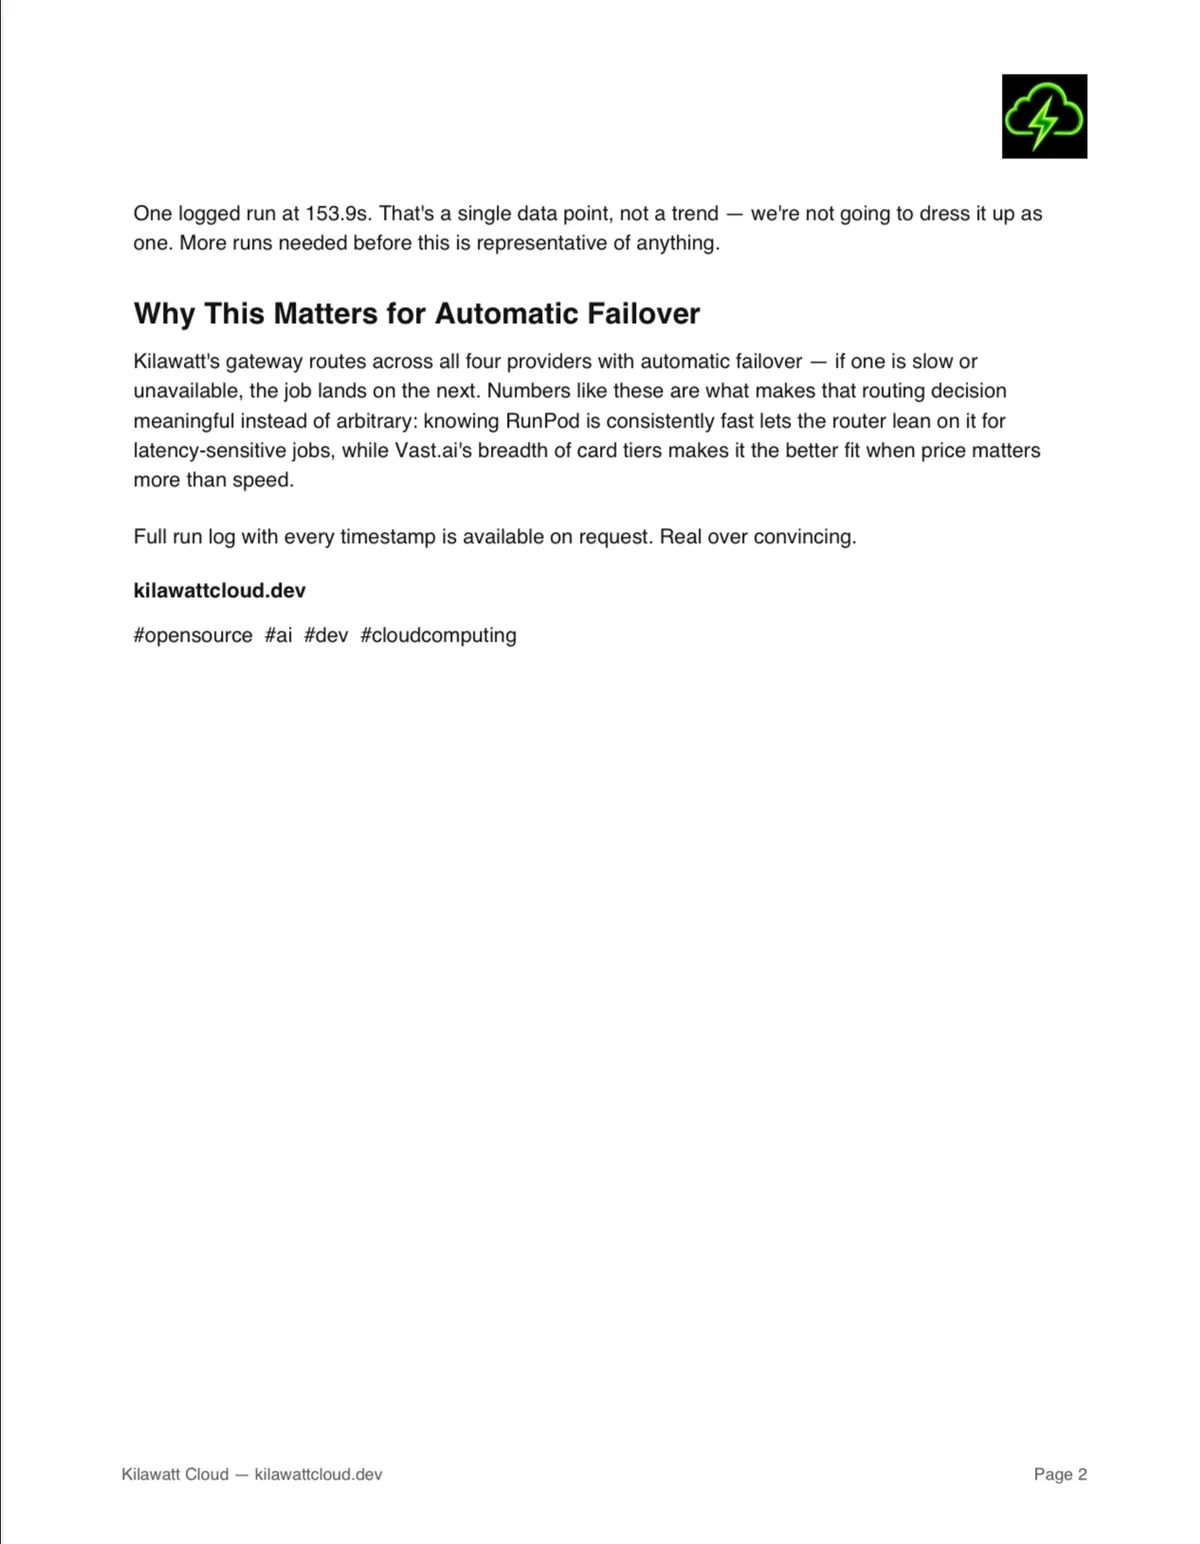
این دادهها نشان میدهند که برخورد با یک میزبان سرد، جریمهای ۵ تا ۹ برابری در عملکرد ایجاد میکند. برای توسعهدهندگان، این یعنی اگر اولویت شما سرعت و پیشبینیپذیری است، RunPod برنده مطلق است، اما برای پروژههای کمبودجه که انتظار ۲ دقیقهای برای آنها پذیرفتنی است، Vast.ai همچنان گزینه مناسبتری است. در این میان، بهینهسازیهای نرمافزاری نیز نقش مهمی دارند؛ برای مثال، موتور FreeToken توانسته است مدلهای بسیار حجیم را حتی روی سختافزارهای محدودتر اجرا کند تا دسترسی به مدلهای بزرگ تسهیل شود.
در نهایت، این معیارها تصمیمات مسیریابی (Routing) را از حدس و گمان به انتخابهای مهندسی تبدیل میکنند. با تکیه بر ارائهدهندگانی که نوسان کمتری دارند، میتوان زمان توقف سیستم در هنگام جایگزینی خودکار را به حداقل رساند.
گام بعدی شما
- تأخیرهای فعلی ارائهدهنده خود را مانیتور کنید تا بفهمید آیا با کارتهای خاص یا تأخیر در دریافت Image مواجه هستید.
- برای مسیرهای بحرانی (Critical Paths) از ارائهدهندگانی با واریانس پایین استفاده کنید.
- استراتژی Warm-up برای کانتینرهای خود تعریف کنید تا اثر Cold Start را حذف کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو