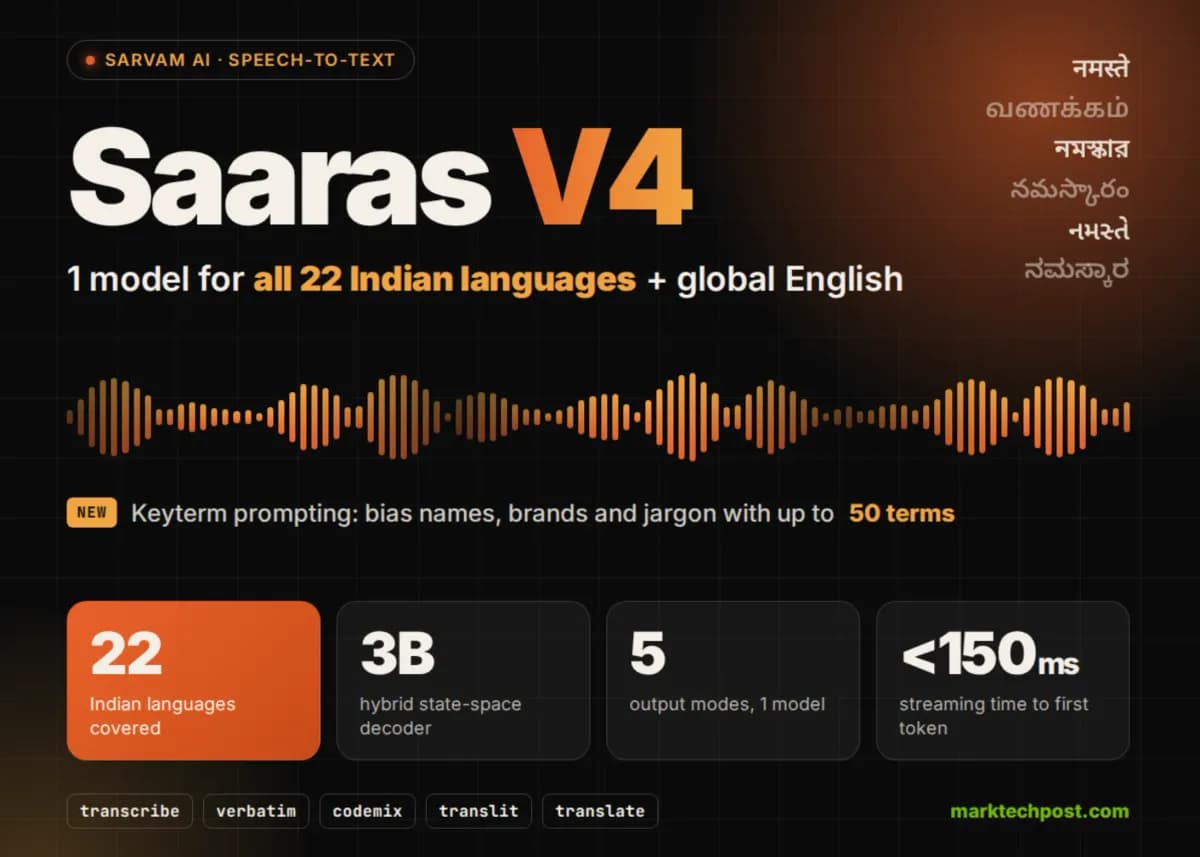
اگر از مدلهای عمومی برای تبدیل گفتار به متن در محیطهای شلوغ استفاده میکنید، احتمالاً با نرخ خطای بالایی دستوپنجه نرم کردهاید. حالا مدل جدید Saaras V4 ادعا میکند که این مشکل را در محیطهای پرنویز، بهویژه برای زبانهای هندی، تا ۵۰٪ بهبود بخشیده است.
به نقل از گزارشهای فنی، این مدل توانسته است نرخ خطای کلمه (Word Error Rate) را در فایلهای صوتی فشرده و دارای صدای پسزمینه، به کمتر از نیمی از میزان خطای GPT-4o Transcribe و Deepgram Nova-3 برساند. این دستاورد برای محیطهای واقعی در هند که با لهجههای متنوع و نویز محیطی شدید شناخته میشوند، یک جهش عملکردی محسوب میشود.
بازشناسی گفتار (ASR) برای زبانهای هندی همواره به دلیل تنوع در رسمالخط و لهجههای غلیظ با چالش روبرو بوده است. در حالی که مدلهای جهانی پشتیبانی گستردهای ارائه میدهند، اما اغلب در ثبت ظرافتهای آوایی ۲۲ زبان رسمی هند شکست میخورند. این چالشها پیشتر در بررسیهای مربوط به سوگیریهای منطقهای در بنچمارکهای ASR مورد تحلیل قرار گرفته بود. شرکت Sarvam AI مدل Saaras V4 را به عنوان یک جایگزین تخصصی معرفی میکند که تمامی این زبانها را در یک سیستم واحد و منسجم ادغام کرده است. همانطور که در تحلیلهای پیشین ما دربارهی مدلهای زبانی تخصصی اشاره کردیم، تمرکز بر دادههای بومی معمولاً نتایجی فراتر از مدلهای General-purpose به همراه دارد.
معماری سیستم
بر اساس گزارش Marktechpost در ۲۶ سپتامبر ۲۰۲۶، این مدل بر پایه معماری رمزگذار-رمزگشا (Encoder-Decoder) بنا شده است. ابتدا یک رمزگذار صوتی، موجهای صدا را به بردار معنایی (Embedding) تبدیل میکند تا جزئیات آوایی و آکوستیک حفظ شوند. سپس یک آداپتور کاهشنمونه زمانی (Temporal-downsampling adapter)، توالیها را کوتاه میکند و آنها را به فضای بردار مدل زبانی منتقل میکند. این فرآیند تضمین میکند که ضبطهای طولانی در محدوده بودجه متنی (Context Budget) رمزگشا باقی بمانند. این سازوکار در واقع نمونهای از نحوه تبدیل دادههای خام به پیشبینیهای دقیق از طریق مکانیزم استنتاج در مدلهای مدرن است.
قلب تپنده این سیستم، مدل Sarvam-3B است؛ یک مدل زبانی با ۳ میلیارد پارامتر و معماری ترکیبی فضای حالت (Hybrid State-Space) که بهصورت داخلی و از صفر آموزش دیده است. این رمزگشا ویژگیهای صوتی را در کنار یک پرامپت متنی میخواند و متن نهایی را بهصورت خودبازگشتی (Autoregressive) تولید میکند، به این صورت که هر توکن تولید شده را به عنوان ورودی برای توکن بعدی بازمیگرداند.
مشخصات فنی و محکهای ارزیابی
- پوشش زبانی: پشتیبانی از ۲۲ زبان رسمی هند به علاوه لهجههای مختلف انگلیسی جهانی. Sarvam گزارش میدهد که در تمامی این ۲۲ زبان به دقت سطح استانداردهای جهانی (State-of-the-art) دست یافته است.
- بنچمارک انگلیسی: این مدل در هفت مجموعه داده ارزیابی شده است. شش مورد از این دادهها مربوط به Open ASR Leaderboard در Hugging Face (شامل AMI، GigaSpeech، LibriSpeech clean، LibriSpeech other، SPGISpeech و VoxPopuli) و مورد هفتم مربوط به Svarah از AI4Bharat با لهجه هندی است. Saaras V4 کمترین میانگین WER را در میان مدلهای مورد آزمایش ثبت کرده است.
- عملکرد در زبانهای هندی: در مجموعه داده Vistaar، نتایج با استفاده از هر دو معیار WER و LLM-WER اندازهگیری شدند. معیار دوم یک بررسی معنایی را اضافه میکند تا خطاهای واقعی در معنا را از تغییرات بیضرر در املای کلمات یا فرمتبندی که در رسمالخطهای هندی رایج است، تفکیک کند.
- صداهای نویزی: در مجموعه داده Kathbath Noisy، که شامل ضبطهای بریدهشده و دارای صدای پسزمینه شدید است، نرخ خطای LLM-WER این مدل کمتر از ۵۰٪ رقبای نزدیکش گزارش شده است.
- دقت کلمات کلیدی: در محک IndicContextEval L5 (بر اساس مقاله Interspeech 2026)، این مدل با استفاده از قابلیت Keyterm Prompting به نرخ خطای ۱۶.۰۳٪ رسید که کمترین امتیاز در این بنچمارک است.
- شناسایی زبان: نرخ خطا برای ۱۰ زبان برتر هندی ۲.۹٪ و برای تمامی ۲۲ زبان در نمونههای تأیید شده IndicVoices، مقدار ۵.۲۲٪ گزارش شده است.
حالتهای خروجی متنوع
مدل Saaras V4 برای حذف نیاز به پردازشهای تکمیلی خارجی، پنج حالت خروجی بومی را از طریق یک پارامتر واحد ارائه میدهد. این رویکرد از انباشت خطاها که معمولاً در مراحل پسپردازش رخ میدهد، جلوگیری میکند:
۱. Transcribe (پیشفرض): تبدیل به رسمالخط بومی با نرمالسازی اعداد و تاریخها.
۲. Verbatim: ثبت دقیق هر کلمه همانطور که گفته شده است، با حفظ تکیهکلامها و اعداد تلفظ شده.
۳. Codemix: استفاده از رسمالخط بومی، اما کلمات انگلیسی به زبان انگلیسی باقی میمانند (ایدهآل برای برندهایی مانند PhonePe).
۴. Translit: تبدیل کامل گفتار به رسمالخط لاتین.
۵. Translate: ترجمه مستقیم به انگلیسی همراه با نرمالسازی اعداد.
استقرار و قیمتگذاری
این مدل هماکنون از طریق API با شناسه model="saaras:v4" در دسترس است. قیمتگذاری Sarvam AI مبلغ ۳۰ روپیه بهازای هر ساعت برای پردازشهای بلادرنگ، استریمینگ و دستهای است که در صورت فعالسازی تفکیک گوینده (Speaker Diarization)، به ۴۵ روپیه افزایش مییابد.
- استریمینگ: از طریق WebSocket با زمان تا نخستین توکن (TTFT) زیر ۱۵۰ میلیثانیه مدیریت میشود.
- REST: تبدیل همگام برای کلیپهای صوتی تا ۳۰ ثانیه.
- دستهای (Batch): پردازش نامتقارن برای فایلهای صوتی تا ۲ ساعت.
- SDKها: پشتیبانی از Python 3.9+ و Node.js 18+ و ادغام با LiveKit Agents، Pipecat و Vercel AI SDK.
با این حال، شرکت اشاره کرده است که مستندات میزبانی شخصی (Self-hosting) در SageMaker فعلاً فقط از نسخه v3 پشتیبانی میکند و نسخه V4 فعلاً انحصاری API است و وزنهای باز (Open Weights) آن منتشر نشده است.
چرخش به سمت رمزگشای ترکیبی فضای حالت، نشاندهنده فاصله گرفتن از معماریهای صرفاً ترنسفورمر (Transformer) در حوزه صوت است. Sarvam AI با کاهش طول توالی از طریق آداپتور زمانی، استنتاج برای فایلهای صوتی طولانی را بدون از دست دادن جزئیات آوایی مورد نیاز برای زبانهای کممنبع (Low-resource) بهینه کرده است.
برای جامعه فنی، مهمترین نکته پیادهسازی «پرامپتنویسی کلمات کلیدی» (Keyterm Prompting) است. این ویژگی به کاربران اجازه میدهد لیستی از حداکثر ۵۰ اصطلاح (هر کدام تا ۶۴ کاراکتر) را در قالب JSON ارسال کنند تا مدل در بازشناسی آنها سوگیری مثبت داشته باشد. اگرچه این قابلیت خروجی را تضمین نمیکند، اما مشکل «نام برندها» را حل میکند؛ جایی که اصطلاحات تخصصی معمولاً توسط مدلهای ASR عمومی دچار توهم (Hallucination) میشوند.
البته باید دید آیا این اعداد گزارششده توسط شرکت در بازبینیهای مستقل تأیید میشوند یا خیر، زیرا هنوز هیچ حسابرسی شخص ثالثی منتشر نشده است. صنعت اکنون منتظر است ببیند آیا این رویکرد تخصصی میتواند بر مقیاسپذیری مدلهای Generalist مانند OpenAI و Deepgram در بازارهای غیرانگلیسی غلبه کند یا خیر.
گام بعدی شما
- توسعهدهندگانی که از نسخه v3 استفاده میکنند، تنها با تغییر یک خط کد در API میتوانند بهبود دقت در زبانهای هندی را تست کنند.
- اگر با اصطلاحات تخصصی یا نام برندهای خاص در صوتها سر و کار دارید، قابلیت Keyterm Prompting را برای کاهش توهمات مدل امتحان کنید.
- برای کاهش هزینهها، ابتدا از حالت Transcribe استفاده کنید و تنها در صورت نیاز به تفکیک گوینده، هزینه اضافی Diarization را بپذیرید.
اما تأثیر این معماری جدید بر مصرف حافظه در لبه (Edge) حتی جذابتر است — به تحلیل ما دربارهی مدلهای کوچک زبانی (SLM) مراجعه کنید.



گفتگو