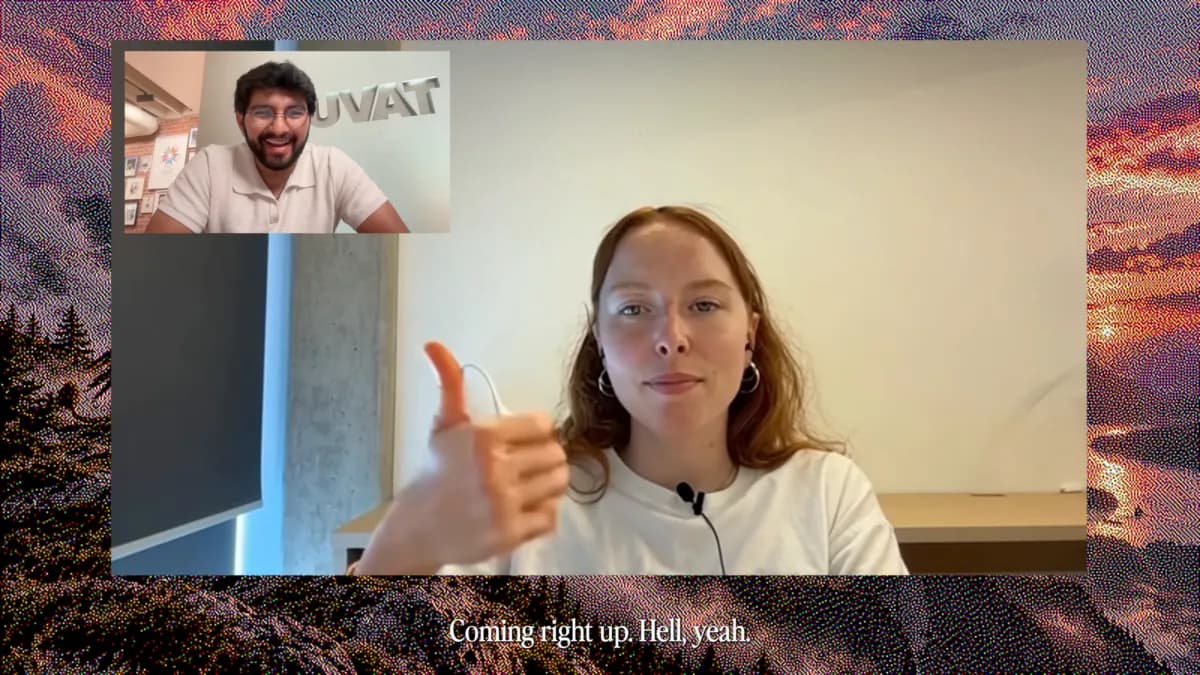
تصور کنید در یک تماس تصویری یکدقیقهای شرکت میکنید و تا پایان مکالمه متوجه نمیشوید که طرف مقابل شما یک انسان نیست، بلکه یک آواتار دیجیتال است. طبق گزارش شرکت Tavus، تقریباً نیمی از شرکتکنندگان در آزمایش مدل جدید این شرکت، دقیقاً همین تجربه را داشتند.
این فناوری بر پایه مدل Griffin ساخته شده است که شرکت آن را نخستین «مدل تعامل انسانی» (Human Interaction Model) مینامد. در حالی که سیستمهای ویدئویی پیشین در شبیهسازی انسان شکست میخوردند — و نرخ موفقیت آنها بهندرت از ۲٪ فراتر میرفت — Griffin روی جزئیات ظریف گفتگوهای چهرهبهچهره تمرکز کرده است. این پیشرفت در واقع تکامل یافتهی تلاشاتی است که پیشتر در تحول تعامل بصری آواتارهای Synthesia برای عبور از محدودیتهای «سرِ سخنگو» دیده بودیم. این مدل برای رسیدن به این سطح از واقعگرایی، از پردازش چندوجهی (Multimodal) — شبیه به مغز انسان که همزمان صدا، تصویر و احساس را تحلیل میکند — استفاده میکند تا فاصله میان ویدئوهای مصنوعی و حضور واقعی انسان را پر کند.
همانطور که در تحلیلهای قبلی ما دربارهی جعل عمیق (Deepfake) اشاره کردیم، چالش اصلی همیشه در «طبیعی بودن» حرکات بوده است. بر اساس گزارشی که در ۱ اکتبر ۲۰۲۶ منتشر شد، Griffin در آزمون مستقل Nvidia برای سنجش تعاملات انسانگونه، امتیاز ۳.۸۳ را کسب کرد. برای درک این عدد، باید دانست که انسانهای واقعی امتیاز ۳.۹۲ و بهترین مدلهای قبلی هوش مصنوعی تنها به امتیاز ۲.۸۰ رسیده بودند.
جزئیات فنی این مدل عبارتند از:
- تحلیل همزمان: Griffin همزمان با تولید ویدئو، حالات چهره و مکثهای گفتاری را تحلیل میکند. این رویکرد با استراتژیهای جدیدی همسو است که در آن مدلهای کوچکتر در رقابت هوش مصنوعی صوتی به دلیل بهینهتر بودن، پیروز میشوند.
- نسخه پیشنمایش: در حال حاضر نسخه Griffin-Lite برای گروهی از آزمایشکنندگان در دسترس است.
- حفاظهای ایمنی: نسخه کاملتر تنها پس از رفع نگرانیهای امنیتی منتشر خواهد شد.
برای صاحبان کسبوکار، این تحول یعنی تبدیل هوش مصنوعی از یک ابزار ایستا به یک نماینده باورپذیر. این فناوری میتواند در پشتیبانی فنی تصویری، آموزش خصوصی یا حتی تمرین مذاکرات حساس شرکتی بدون نیاز به حضور انسان به کار گرفته شود. در این راستا، ابزارهایی مانند رندرینگ عصبی TalkPix نیز مسیر را برای جایگزینی اقتصادی استودیوهای گرانقیمت با ویدئوهای تولید شده توسط هوش مصنوعی هموار کردهاند.
شرکت Tavus که در سال ۲۰۲۰ در سانفرانسیسکو تأسیس شد و ۶۴ میلیون دلار سرمایه جذب کرده است، ابتدا روی ویدئوهای فروش شخصیسازیشده تمرکز داشت. اما چرخش راهبردی این شرکت به سمت پرسوناهای تعاملی زنده، نشاندهنده حرکت به سوی «کارمندان دیجیتال» کاملاً خودمختار است.
گام بعدی شما
- اگر مدیر محصول هستید، روی جایگزینی چتباتهای متنی با رابطهای تصویری تعاملی تحقیق کنید.
- برای بررسی استانداردهای جدید تشخیص جعل، گزارشهای Nvidia درباره مدلهای تعاملی را دنبال کنید.
- منتظر انتشار نسخه غیر-Lite باشید تا ببینید آیا این واقعگرایی در مکالمات طولانی و بدون متن هم حفظ میشود یا خیر.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو