تصور کنید میخواهید یک بلندگوی هوشمند را طوری آموزش دهید که در شلوغترین رستوران شهر، دستورات شما را بشنود، اما تنها دادههای در دستتان ضبطهای استودیویی و تمیز هستند. این شکاف میان دادههای آزمایشگاهی و واقعیتِ آشفتهی محیطی، همان جایی است که اکثر سیستمهای صوتی هوش مصنوعی شکست میخورند.
به گزارش TechCrunch، استارتاپ ایسلندی Treble برای حل این چالش، در ۱۷ سپتامبر ۲۰۲۶ مبلغ ۱۸ میلیون دلار در یک دور سرمایهگذاری Series A جذب کرد. این دور توسط Paladin Capital Group رهبری شد و شرکتهای KOMPAS VC، Frumtak Ventures، EIC و Omega ehf نیز در آن مشارکت داشتند. این شرکت که در سال ۲۰۲۰ توسط مهندسان آکوستیک، فینور پیند (Finnur Pind) و جسپر پدرسن (Jesper Pedersen) تأسیس شد، رشد سریعی را تجربه کرده است. Treble پیش از این در سال ۲۰۲۴ مبلغ ۱۲ میلیون دلار سرمایه جذب کرده بود که باعث شد مجموع سرمایههای جذبشده توسط این شرکت تا به امروز از ۴۰ میلیون دلار بگذرد.
دنیای امروز شاهد هجوم سرمایهها به سمت اتوماسیون پشتیبانی مشتری، تماسهای فروش، یادداشتبرداران جلسات و گجتهای پوشیدنی مانند عینکهای هوشمند است. اما مشکل اینجاست که اکثر مدلهای فعلی بر دادههای استخراجشده (Scraped) از وب تکیه دارند. این دادهها اغلب در بازسازی واقعیتهای پیچیده آکوستیک فیزیکی ناتوان هستند. همانطور که در تحلیلهای قبلی ما دربارهی محدودیتهای دادههای آموزشی اشاره کردیم، تکیه بر دادههای موجود در وب برای محیطهای فیزیکی کافی نیست. Treble برای پر کردن این خلاء از شبیهسازیهای فیزیکی برای تولید دادههای مصنوعی (Synthetic Data) استفاده میکند. این رویکرد شبیه به ساخت یک محیط مجازی دقیق در بازیهای ویدئویی است که هر صدای محیطی را بازسازی میکند تا مدلها را در شرایط واقعی بسنجد. طبق گزارشها، این استارتاپ توانسته است مشتریان بزرگی از جمله آمازون (Amazon) و لاجیتک (Logitech) را جذب کند.
طبق اعلام این شرکت، قابلیتهای کلیدی پلتفرم شامل موارد زیر است:
- تولید دادههای مصنوعی: ایجاد صداهای با کیفیت بالا (High-fidelity) برای بهبود گفتار، حذف نویز و آموزش مدلها بدون نیاز به ضبطهای میدانی طولانی. فینور پیند اشاره میکند که در حالی که اکثر هوشهای مصنوعی از دادههای وب استفاده میکنند، شبیهسازی دقیق فیزیکی جایگزینی برتر و دقیقتر است.
- محکزنی مدلها (Model Benchmarking): ارزیابی عملکرد مدلهای صوتی در شرایط متغیر و واقعگرایانه. این قابلیت در اوایل سال جاری از طریق همکاری با Hugging Face برای راهاندازی یک بنچمارک مخصوص مدلهای بازشناسی گفتار گسترش یافته است.
- نمونهسازی مجازی (Virtual Prototyping): امکان تست عملکرد آکوستیک هدفونها و بلندگوها پیش از ساخت سختافزار فیزیکی. این شامل تست این موضوع است که یک بلندگوی هوشمند بر اساس موقعیت قرارگیری خاص خود، چگونه دستورات را درک میکند.
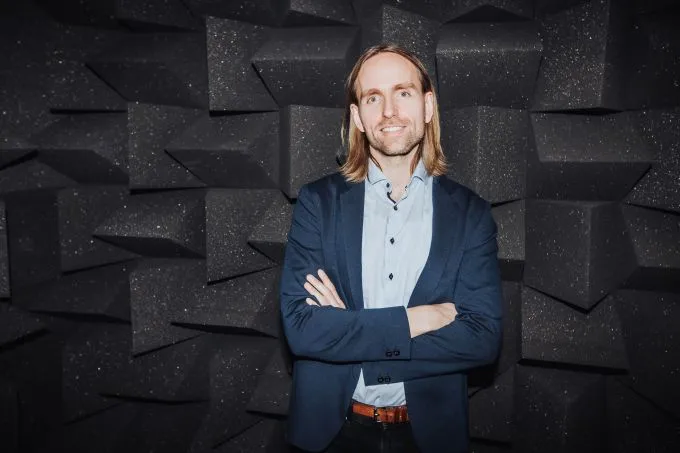
فینور پیند، یکی از بنیانگذاران شرکت، استدلال میکند که شبیهسازی دقیق فیزیکی تنها جایگزین عملی برای استخراج داده از اینترنت برای نسل بعدی هوش مصنوعی صوتی است. این شرکت اکنون در حال گسترش فعالیتهای خود به حوزه «هوش مصنوعی فیزیکی» (Physical AI) است. هدف آنها بخشهای رباتیک، صنعت خودرو و پهپادها است؛ جایی که عملکردهای مبتنی بر صدا برای ناوبری و تعامل با محیط حیاتی هستند.
علاوه بر کاربردهای صنعتی، Treble روی گجتهای پوشیدنی برای ایجاد «شنوایی ابرانسانی» تمرکز کرده است. پیند دستگاههایی مانند هدفونها و عینکهای هوشمندی را متصور است که به کاربران کمک میکند در محیطهای آکوستیک دشوار، بهتر بشنوند. این فناوری به کاربر اجازه میدهد در یک سمینار شلوغ، نویزهای محیطی را بیصدا کرده یا صدای شخصی خاص را که در فاصله دو متری قرار دارد، ایزوله و تقویت کند.
فرانسوا روتر (Francois Ruether)، معاون Paladin Capital Group، تأکید میکند که با وابستگی بیشتر محصولات به درک صدا، این زیرساختهای آکوستیک که بر پایه شبیهسازی ساخته شدهاند، ارزش حیاتی پیدا میکنند. او خاطرنشان میکند که مشتریان مالکیت مدلها و جریانهای کاری توسعه خود را حفظ میکنند و در عین حال از یک زیربنای مشترک بهره میبرند.
این تغییر رویکرد نشان میدهد که گلوگاه بعدی هوش مصنوعی صوتی دیگر اندازه مدل نیست، بلکه دقت محیطی است. با جداسازی دادههای آموزشی از دنیای فیزیکی، Treble به شرکتها اجازه میدهد تا سختافزار و نرمافزار را بهطور همزمان و بدون نیاز به هزاران ساعت ضبط دستی در محیطهای واقعی، توسعه دهند. این یعنی دوران «نابهنجار» دستیارهای صوتی — که مجبور بودید برایشان فریاد بزنید یا جملات خود را تکرار کنید — زودتر از آنچه فکر میکنیم به پایان میرسد. ما به سمت دستگاههایی حرکت میکنیم که هندسه اتاقی را که در آن قرار دارند، درک میکنند.
در آینده نزدیک، منتظر ادغامهای Treble با شرکتهای رباتیک باشید، زیرا آگاهی فضایی مبتنی بر صدا به یکی از الزامات اصلی برای عاملهای خودکار (Autonomous Agents) در محیطهای انسانی تبدیل خواهد شد.
گام بعدی شما
- اگر توسعهدهنده سختافزارهای صوتی هستید، مدلهای محکزنی Hugging Face را برای ارزیابی دقت مدل خود بررسی کنید.
- روی ادغام قابلیتهای تشخیص مکان صوتی در عاملهای خودکار (Autonomous Agents) سرمایهگذاری کنید.
- تحولات حوزه «هوش مصنوعی فیزیکی» در رباتیک را دنبال کنید تا متوجه شوید صدا چگونه جایگزین برخی سنسورهای بصری میشود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو