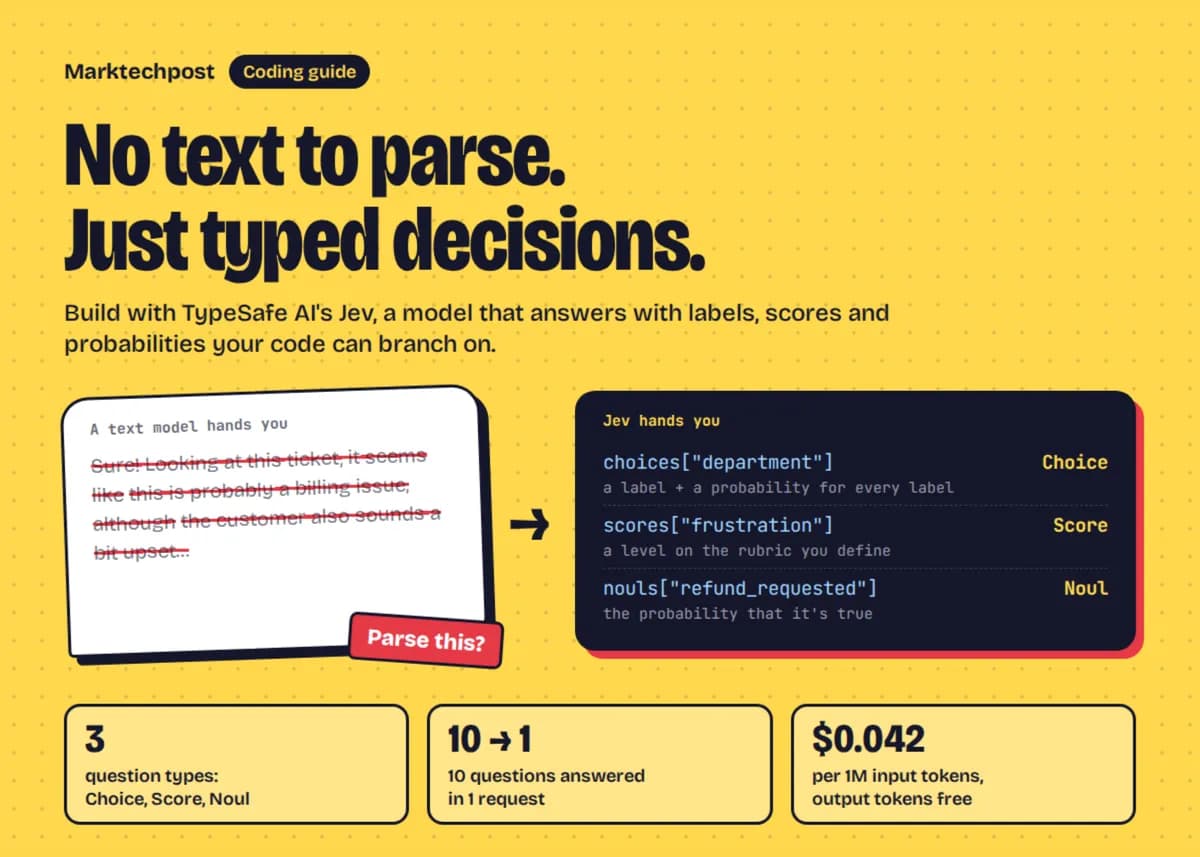
اگر امروز از مدلهای زبانی برای اتخاذ تصمیمات سیستمی استفاده میکنید، احتمالاً با کابوسِ تحلیل متون نامنظم و خطاهای تجزیه (Parsing) دستوپنجه نرم کردهاید. مدل Jev از شرکت TypeSafe AI این بازی را تغییر میدهد و بهجای نوشتن جملات، مستقیماً «انتخابها»، «امتیازها» و «احتمالات» را برمیگرداند که کد میتواند مستقیماً آنها را اجرا کند. این رویکرد به توسعهدهنده اجازه میدهد تا یک پرامپت غیرقابل پیشبینی را با یک تابع تصمیمگیرنده محدود و مشخص جایگزین کند.
این تغییر رویکرد در زمانی رخ میدهد که صنعت با مشکل توهم (Hallucination) — شبیه دوستی که با اطمینان خاطرهای را اشتباه تعریف میکند — و شکست در تبدیل متن به فرمتهای قابلفهم برای کد در محیطهای عملیاتی دستوپنجه نرم میکند. همانطور که در تحلیل قبلی ما دربارهی نحوه ایمنسازی عاملهای هوشمند توسط Tenuo از طریق تصمیمات تایپشده اشاره کردیم، Jev این الگو را رسمی میکند و هوش مصنوعی را بهجای یک نویسنده، به عنوان یک تابع تصمیمگیرنده احتمالی (Fuzzy Decision Function) میبیند. برای یک برنامهنویس، این یعنی تفاوت بین تلاش برای استخراج داده از یک رشته متنی نامنظم JSON و دریافت یک شیء اعتبارسنجشده از نوع Pydantic.
معماری سیستم یک (System One)
مدل Jev بر اساس معماری «سیستم یک» طراحی شده است تا قضاوتهای سریع و شهودی ارائه دهد. به نقل از آموزش منتشرشده در وبسایت marktechpost.com در ماه جاری، این مدل یک قطعه از وضعیت برنامه (مانند یک شیء JSON، یک رشته متنی یا یک آرایه) و مجموعهای از پرسشهای تایپشده را دریافت کرده و سه خروجی اصلی (Primitives) تولید میکند:
- انتخاب (Choice): یک برچسب را از میان مجموعهای از معیارهای تعریفشده برمیگزیند و برای هر گزینه یک احتمال تعیین میکند. برای مثال، یک انتخاب برای «دپارتمان» میتواند شامل «حسابداری» (مسائل پرداخت، استرداد یا اشتراک)، «فنی» (باگها، قطعیها یا مشکلات یکپارچهسازی) یا «فروش» (قیمتگذاری، طرحها یا ارتقای حساب) باشد.
- امتیاز (Score): وضعیت را روی یک معیار رتبهبندیشده (Rubric) قرار میدهد و یک سطح با وزن احتمالی برمیگرداند. این قابلیت اجازه میدهد نتیجه بین دو سطح قرار بگیرد؛ مثلاً امتیاز عصبانیت در مقیاس ۰ تا ۲ که از «آرام، فقط بیان واقعیات» تا «بسیار خشمگین، استفاده از زبان تند» متغیر است.
- نول (Noul): یک احتمال تکعددی (بین ۰ تا ۱) برمیگرداند که نشان میدهد یک گزاره خاص چقدر درست است؛ مثلاً «آیا کاربر صراحتاً درخواست استرداد وجه کرده است؟»
تأثیر شکل دادهها بر دقت (Context and State Shapes)
در معماری Jev، «وضعیت» (State) تنها منبع اطلاعاتی است که مدل در اختیار دارد. شکل این وضعیت مستقیماً بر توانایی مدل در پاسخدهی تأثیر میگذارد. در یک مورد آزمایشی مربوط به صلاحیت استرداد وجه، احتمال خروجی مدل بر اساس بستر (Context) ارائه شده تغییر کرد:
- رشته متنی ساده (Bare String): تنها متن شکایت ارسال شد («من برای سفارش A-104 دو بار شارژ شدم. لطفاً مبلغ تکراری را برگردانید.») و این منجر به کمترین احتمال تایید صلاحیت شد.
- آرایه (Array): تاریخچه کامل گفتگو ارسال شد که بستر بیشتری را به مدل اضافه کرد.
- شیء JSON: وضعیت شامل متن شکایت، جزئیات سفارش (که نشان میداد دو تراکنش ۴۹ دلاری ثبت شده) و متن سیاست استرداد وجه («شارژهای تکراری ظرف ۳۰ روز واجد شرایط استرداد کامل هستند») بود. این دادهها شواهد لازم برای یک پاسخ «بله» با احتمال بالا را فراهم کرد.
از آنجایی که دستورالعملهای پرسشها در تمام این حالتها یکسان باقی میمانند، هر تغییری در خروجی صرفاً به دلیل تغییر در «وضعیت» است. TypeSafe توصیه میکند از فیلدهای نامگذاریشده در اشیاء JSON استفاده شود تا دستورالعملها بتوانند با استفاده از علامت بکتیک (Backticks) به مسیرهای خاص ارجاع دهند (مثلاً ticket.messages[0].text).
بهرهوری و توزیع گمانهزنانه (Speculative Fan-out)
یکی از مزایای فنی برجسته Jev، قابلیت «توزیع گمانهزنانه» است. توسعهدهندگان میتوانند چندین پرسش را در یک فراخوانی API دستهبندی (Batch) کنند، بدون اینکه پرسشها روی یکدیگر اثر بگذارند.
بر اساس مستندات فنی، در تحلیل یک حادثه فنی (Incident 2291) در تاریخ ۱۴ مارس، دستهبندی ۱۰ پرسش — شامل دو Choice، دو Score و شش Noul — در یک فراخوانی، بهمراتب سریعتر و ارزانتر از ۱۰ فراخوانی مجزا بود. این حادثه مربوط به تأخیر در پرداخت (Checkout Latency) بود که در آن محدودیت Connection Pool از ۴۰۰ به ۴۰ کاهش یافته بود و منجر به ۳۴۲۰ شکست در پرداخت و ۶۱ هزار دلار ضرر در درآمد شده بود.
دلیل این بهرهوری این است که وضعیت برنامه فقط یکبار ارسال میشود و در نتیجه تأخیر (Latency) و هزینه توکنهای ورودی کاهش مییابد. چون مدل پرسشها را بهصورت ایزوله ارزیابی میکند، پاسخها فارغ از اینکه بهتنهایی یا در یک دسته پرسیده شوند، ثابت میمانند. این به توسعهدهندگان اجازه میدهد تمام پرسشهای احتمالی را از ابتدا بپرسند — مثلاً اینکه آیا حادثه فقط مربوط به اتحادیه اروپا بوده یا خطای انسانی در کار بوده است — و سپس بر اساس شاخه تصمیمگیری، پاسخهای مربوطه را بخوانند.
مسیریابی مبتنی بر سطح اطمینان (Confidence-Gated Routing)
در Jev، مدیریت ریسک بهجای مهندسی پرامپت، در لایه کد انجام میشود. توسعهدهندگان با استفاده از آمار اطمینان (Confidence) که مدل برمیگرداند، مسیریابیهای شرطی ایجاد میکنند.
شرکت TypeSafe اطمینان را به عنوان آماری تعریف میکند که از توزیع احتمالات محاسبه میشود: (count * peak - 1) / (count - 1). این یعنی اطمینان معیاری است برای اینکه مدل چقدر روی یک پاسخ «قله» ساخته است در مقابل اینکه احتمال را بین گزینههای مختلف پخش کند. یک Noul فیلد اطمینان ندارد زیرا مقدار آن خودِ احتمال «بله» است؛ مقدار ۰.۵ نشان میدهد مدل مردد است. با این حال، در محیطهای عملیاتی ممکن است این اعداد با واقعیت فاصله بگیرند، موضوعی که در بررسی شکاف کالیبراسیون در مدل Jev به تفصیل تحلیل کردهایم.
برای مثال، یک دستیار بانکی ممکن است برای بررسی ساده موجودی حساب از آستانه اطمینان پایین (۰.۵۰) استفاده کند، اما برای بستن خودکار یک حساب، به آستانه بالایی (۰.۹۰) نیاز داشته باشد. اگر اطمینان مدل پایینتر از حد لازم باشد، سیستم بهطور خودکار درخواست را به اپراتور انسانی ارجاع میدهد یا از کاربر تأیید میگیرد. این آستانهها مقادیر معمولی پایتون هستند، به این معنی که تحمل ریسک مانند هر کد دیگری نسخهبندی و تست میشود.
امتیازدهی ترکیبی و فراخوانی تابع
این مدل امکان امتیازدهی ترکیبی (Composite Scoring) را فراهم میکند. یک توسعهدهنده میتواند از مدل بخواهد قضاوتهای اتمیک (ساده) را در چندین بعد — مانند تسلط به پایتون، تجربه سیستمهای ML، رهبری و ارتباطات — انجام دهد و سپس در پایتون با اعمال محاسبات وزنی، کاندیداها را رتبهبندی کند.
برای مثال، برای نقش «متخصص ارشد (Senior IC)»، وزن تسلط به پایتون و سیستمهای ML هر کدام ۴۰٪ است، در حالی که برای نقش «رهبر تیم»، وزن رهبری ۴۵٪ است. چون قضاوتها جدا از وزنها ذخیره شدهاند، تغییر معیارهای رتبهبندی نیازی به فراخوانیهای گرانقیمت و جدید استنتاج (Inference) ندارد. شما میتوانید هر جایگاه در رتبهبندی را به بعد خاصی که آن را ایجاد کرده است ردیابی کنید.
فراخوانی تابع (Function Calling) نیز به یک مسئله «مجموعه بسته» تبدیل شده است. بهجای امید به اینکه یک LLM نام تابع را درست تولید کند، Jev از ابزار Choice برای انتخاب یک ابزار از لیست پیشفرض (مانند set_lights یا set_thermostat یا play_music) استفاده میکند، که شامل یک گزینه صریح «هیچکدام» برای دستورات پشتیبانینشده است. آرگومانها بهصورت گمانهزنانه در همان درخواست پرسیده میشوند. کد تنها زمانی تابع را اجرا میکند که «ضعیفترین قضاوت» — یعنی کمترین سطح اطمینان در میان تمام آرگومانهای مورد نیاز — از یک آستانه خاص عبور کند.
استقرار در محیط عملیاتی و جزئیات پیادهسازی
برای انتقال Jev به محیط عملیاتی، TypeSafe AI ابزار AsyncTypeSafeClient و مدلهای پاسخ Pydantic را ارائه داده است. با ارثبری از SystemOneResponse توسعهدهندگان میتوانند پاسخهای مورد انتظار را به عنوان ویژگی (Attribute) تعریف کنند تا تضمین شود تصمیمات تایپشده در تمام مراحل برنامه، ماهیت دادهای خود را حفظ کنند و به جستوجوی دیکشنری تبدیل نشوند.
جزئیات فنی پیادهسازی شامل موارد زیر است:
- همزمانی (Concurrency): استفاده از
asyncio.gatherبا کلاینت async اجازه میدهد صفهای تصمیمات مستقل (مانند دستهبندی لیستی از تیکتهای پشتیبانی) بهطور همزمان پردازش شوند. در تستها، این کار اجازه میدهد چندین تیکت در یک بازه زمانی واحد پردازش شده و هزینه هر تیکت سرشکن شود. - پایداری (Reliability): سیاست بازتلاش (
RetryPolicy) امکان تعیین حداکثر تعداد تلاش (مثلاًmax_retries=3)، تنظیم زمانهای عقبنشینی اولیه و حداکثری (۰.۵ تا ۴ ثانیه) و تعریف یک تایماوت کلی برای هر فراخوانی (مثلاً ۲۰ ثانیه) را فراهم میکند. - مدیریت خطا (Error Handling): خطاها بهطور سختگیرانه تایپ شدهاند. یک
TypeSafeErrorبرای مشکلات سمت کلاینت (مانند مجموعه پرسشهای خالی) قبل از ارسال درخواست صادر میشود، در حالی کهTypeSafeAPIErrorوضعیت HTTP را برای رد درخواستهای سمت API (مانند نام مدل ناشناخته) حمل میکند. - ردیابی هزینه (Cost Tracking): SDK امکان ردیابی دقیق هزینهها را فراهم میکند. با قیمت لیست Jev که ۰.۰۴۲ دلار بهازای هر میلیون توکن ورودی است و توکنهای خروجی رایگان هستند، توسعهدهندگان میتوانند هزینه دقیق یک سرویس را بر اساس
usage.input_tokensمحاسبه کنند.
محدودیتهای شناختهشده
مدل Jev محدودیتهایی دارد که نیازمند راهکارهای مهندسی است. مدل نمیتواند بهطور قابلاعتمادی در یک پرسش واحد شمارش کند. برای حل این مشکل، توسعهدهندگان باید از الگوی «یک نول برای هر آیتم» استفاده کنند: یعنی برای هر آیتم در یک لیست یک پرسش Noul بپرسند (مثلاً: «آیا آیتم ۰ میوه است؟») و سپس نتایج را در کد پایتون جمع بزنند.
علاوه بر این، نسخه jev-1.13 دارای «ناهمواریهایی» (Jaggedness) در خواندن تحتاللفظی، محاسبات ریاضی، مقایسه تاریخها و پردازش وضعیتهای بسیار بزرگ حاوی اطلاعات نامرتبط است. توصیه میشود توسعهدهندگان برای پایداری در محیط عملیاتی، نسخههای خاصی مانند jev-1.13.0 را تثبیت (Pin) کنند.
تحلیل: پایان جنگ تجزیه (Parsing War)
برای یک توسعهدهنده عملگرا، Jev نشاندهنده گذار از «مهندسی پرامپت» به سمت «مهندسی تصمیم» است. اثر مرتبه دوم این تغییر، کاهش شدید بدهی فنی (Technical Debt) است. وقتی خروجی هوش مصنوعی یک انتخاب محدود است، دیگر نیازی به Regexهای پیچیده یا تجزیهکنندههای شکننده JSON برای کارکرد نرمافزار نیست.
این موضوع فرض بنیادی یکپارچهسازی هوش مصنوعی را تغییر میدهد. بهجای treating کردن LLM به عنوان یک جعبه سیاه که ممکن است گاهی در پیروی از دستورالعملها شکست بخورد، Jev با هوش مصنوعی به عنوان یک سنسور احتمالی برخورد میکند. منطق — یعنی آستانهها، وزنها و مسیریابیها — در کدی باقی میماند که تحت کنترل نسخه (Version-controlled) است و میتوان آن را تست و حسابرسی کرد.
برای بررسی بیشتر این الگوها، توسعهدهندگان میتوانند کتابهای راهنمای (Cookbooks) TypeSafe AI را برای فیلتر کردن متون RAG، بررسی استنادات، طبقهبندی سلسلهمراتبی و گاردریلهای LLM مطالعه کنند.
گام بعدی شما
- اگر از JSON Parsing در خروجیهای LLM خسته شدهاید، معماری Choice/Score/Noul را برای جایگزینی با پرامپتهای متنی بررسی کنید.
- برای کاهش هزینههای API، پرسشهای مستقل خود را در قالب Speculative Fan-out دستهبندی کنید.
- سطوح اطمینان (Confidence Thresholds) را در کد خود تعریف کنید تا ریسک تصمیمات خودکار هوش مصنوعی را مدیریت کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو