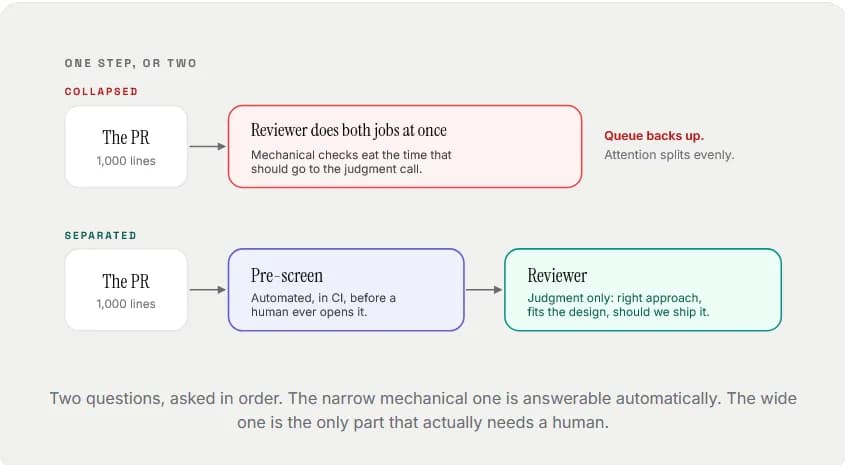
یک درخواست تغییر (Pull Request) هزارخطی که توسط یک دستیار هوش مصنوعی تولید شده باشد، میتواند کل تیم توسعه را فلج کند اگر همچنان به بازبینیهای انسانی سنتی متکی باشید. در ۱۵ سپتامبر ۲۰۲۶، گزارشی از dev.to برجسته کرد که کدهای تولیدشده توسط هوش مصنوعی به گونهای شکست میخورند که شهود انسانی برای تشخیص آنها کالیبره نشده است؛ این امر ایجاد یک فاز متمایز «پیشغربالگری» (Pre-screening) در خط لوله CI/CD را ضروری میکند.
بازبینی کد (Code Review) در طول تاریخ بر این فرض بنا شده بود که یک انسان کد را مینویسد و انسان دیگری آن را بررسی میکند. با گسترش مقیاس دستیارهای هوش مصنوعی، این مدل در حال فروپاشی است. در حالی که باگهای انسانی معمولاً حول محور خستگی یا نادیده گرفتن موارد خاص (Edge Cases) خوشهبندی میشوند، شکستهای هوش مصنوعی اغلب از نظر نحوی (Syntactically) بینقص و با اعتمادبهنفس به نظر میرسند، اما در بنیاد منطقی غلطاند.
با تکیه بر پوشش قبلی ما دربارهی بحران خط لوله مهندسان ارشد، صنعت اکنون شاهد تغییری در نحوه ورود کدها به مخزن است. طبق گزارش dev.to، مشکل تنها سرعت نیست، بلکه مسیریابی (Routing) است. توسعهدهندگان اکنون درخواستهای تغییر کوچکتر و متعددی باز میکنند؛ به این معنا که از یک PR با ۴۰۰ خط به سمت پنج PR با ۸۰ خط تغییر مسیر دادهاند که این امر بار اداری کل را بر دوش بازبینها افزایش میدهد. این روند در واقع تلاشی برای مدیریت بحرانی است که در آن تولید سریعتر کد توسط عاملهای هوش مصنوعی، گلوگاه بازبینی را عمیقتر کرده است.
حالت شکست هوش مصنوعی
کدهای تولیدشده توسط هوش مصنوعی ریسکهای خاصی را معرفی میکنند که ابزارهای استاندارد بررسی استایل (Linting) و چکهای ساختاری نمیتوانند آنها را شناسایی کنند. باگهای نوشتهشده توسط انسان تمایل دارند دور محور تلاش و تمرکز جمع شوند؛ برای مثال، یک مهندس خسته ممکن است یک مورد خاص را نادیده بگیرد یا در یک PR عجولانه، بررسی مقدار تهی (Null Check) را فراموش کند. بازبینها دههها شهود برای شناسایی این الگوهای خاص دارند.
اما هوش مصنوعی متفاوت شکست میخورد. کد آن با اعتمادبهنفس و از نظر نحوی تمیز است. حتی زمانی که غلط است، اغلب متقاعدکننده و محتمل به نظر میرسد. هوش مصنوعی میتواند تابعی را اختراع کند که اصلاً وجود ندارد، هدف پشت یک تیکت را اشتباه بفهمد، یا بیسروصدا یک الگوی ضدساختار (Anti-pattern) را از دادههای آموزشی خود بازتولید کند که اتفاقاً بدون خطا کامپایل میشود. هیچکدام از این موارد شبیه به باگهای یک «مهندس خسته» نیست.
شرکت GitClear با تحلیل بیش از ۲۰۰ میلیون خط کد تغییریافته دریافت که با افزایش مقیاس نویسندگی هوش مصنوعی، بلوکهای کد تکراری بهطور قابلتوجهی رایجتر شدهاند. این دقیقاً همان الگویی است که یک بازبین انسانی هنگام مرور سریع یک Diff بزرگ، احتمالاً آن را نادیده میگیرد. فرآیند بازبینی تغییر نکرده است، اما چیزی که بازبینی میشود تغییر کرده است. شهود بازبین برای پنل سمت چپ (کد انسانی) کالیبره شده است، در حالی که حجم کد از سمت راست (هوش مصنوعی) وارد میشود. این انباشت از کدهای تکراری و الگوهای غلط، در بلندمدت منجر به ایجاد بدهی فنی نامرئی در ساختارهای کدنویسی هوشمند میشود که شناسایی آن برای تیمهای عملیاتی دشوار است.
اهداف حیاتی پیشغربالگری
پیشغربالگری باید بهطور خاص چهار دسته از شکستهای بحرانی را هدف قرار دهد تا از انباشت صفهای بازبینی جلوگیری کند:
- وابستگیهای توهمی (Hallucinated Dependencies): هوش مصنوعی اغلب متدهایی را فراخوانی میکند که در شیء مورد استفاده وجود ندارند یا بستههایی را وارد (Import) میکند که در پروژه حضور ندارند. کد در نگاه اول درست به نظر میرسد، اما اجرا نمیشود. یک مرحله غربالگری که فقط استایل و فرمت را بررسی میکند، این مورد را نمیگیرد؛ سیستم باید آنچه کد فراخوانی میکند را با واقعیت کدبیس تطبیق دهد.
- از دست دادن زمینه (Context Loss): در حالی که هوش مصنوعی در پنجرههای محدود قوی است، اما در درک زمینه در یک تغییر بزرگ دچار مشکل میشود. مدل ممکن است رشتهی ارتباطی را گم کند، که منجر به این میشود که دو تابع در یک PR، یک مورد خاص را به دو روش متفاوت مدیریت کنند، یا تابعی بازنویسی شود که دیگر با یک ناوردا (Invariant) که بقیه کدبیس به آن وابسته است، همخوانی ندارد. در یک PR هزارخطی، تشخیص این مورد بسیار آسان است که نادیده گرفته شود.
- منطق متقاعدکننده اما غلط (Plausible-but-Wrong Logic): این سختترین دسته است. کد اجرا میشود و تستهای بدیهی را پاس میکند، اما برای موردی که هیچکس به فکر نوشتن تستش نبوده، غلط است. تحلیل استاتیک مشکلات نحوی را میگیرد، اما نمیتواند درک غلط و با اعتمادبهنفسِ مدل از آنچه تیکت واقعاً خواسته است را تشخیص دهد.
- انحراف از الگو (Pattern Drift): اگر یک کدبیس روش تثبیتشدهای برای مدیریت تلاشهای مجدد (Retries)، بررسیهای احراز هویت یا انتشار خطاها دارد، هوش مصنوعی تا زمانی که به او گفته نشود، این موضوع را بهطور قابلاعتمادی نمیداند. پیشغربالگری کد جدید را با الگوهای موجود میسنجد تا انحراف را پیش از آنکه به سومین روش متناقض برای انجام یک کار تبدیل شود، شناسایی کند.
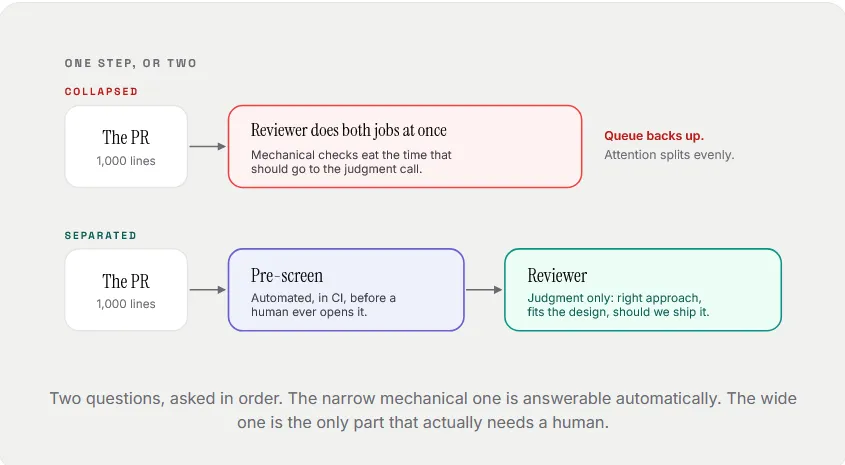
تفکیک غربالگری از بازبینی
تفاوت بنیادی میان پیشغربالگری و بازبینی کد وجود دارد. این تمایز برای حفظ سرعت (Velocity) توسعه حیاتی است.
پیشغربالگری یک سؤال مکانیکی و محدود میپرسد: «آیا چیزی در اینجا هست که بازبین باید پیش از صرف توجه و وقتش روی آن بداند؟». اما بازبینی کد یک سؤال قضاوتی و گستردهتر است: «آیا این رویکرد درست است، آیا با طراحی کلی سازگار است و آیا باید آن را منتشر کنیم؟».
اینها دو سؤال متفاوت هستند که باید به ترتیب پرسیده شوند. سؤال مکانیکی بهطور خودکار پاسخ داده میشود. سؤال قضاوتی تنها بخشی است که واقعاً به انسان نیاز دارد. وقتی این دو مرحله در یک مرحله ادغام میشوند، صفهای بازبینی طولانی میشوند. بازبینی که یک PR هزارخطی تولیدشده توسط هوش مصنوعی را بدون پیشغربالگری باز میکند، باید هر دو شغل را همزمان انجام دهد. بررسیهای مکانیکی، زمانی را میبلندند که باید صرف قضاوت معماری میشد.
پیشغربالگری مؤثر، مانند رویکرد مورد استفاده در Tomosu، در گیتِ ادغام (Merge Gate) و بهعنوان بخشی از خط لوله CI/CD اجرا میشود، نه بهعنوان یک بررسی موازی که انسان باید به یاد داشته باشد آن را بخواند. این سیستم تغییرات را با نحوه عملکرد واقعی آن کدبیس خاص میسنجد و به الگوهای شکست قبلی ارجاع میدهد تا ریسکها را بهطور خودکار علامتگذاری کند.
تأثیر بر گردش کار
تیمهایی که این تفکیک را اجرا میکنند، لزوماً کد کمتری بازبینی نمیکنند؛ بلکه بهطور عمدی «نامتوازن» بازبینی میکنند. با خودکارسازی فیلتر مکانیکی، آنها میتوانند ۹۰٪ از تلاش انسانی خود را روی ۱۰٪ از تغییراتی متمرکز کنند که واقعاً نیاز به قضاوت دارد، بهجای آنکه توجه خود را بهطور مساوی بین تمام کدها تقسیم کنند.
این چرخش، گلوگاه را از «ظرفیت انسانی» به «دقت ابزار» منتقل میکند. ابزار غربالگری که مسائل واقعی را زیر کوهی از مثبتهای کاذب (False Positives) دفن کند، تبدیل به «هشدار حریقی میشود که هر بار کسی نان توست میکند به صدا در میآید» و باعث میشود تیمها ظرف چند هفته آن را کاملاً نادیده بگیرند.
پیشغربالگری خوب باید بهمرور سریعتر و دقیقتر شود. این ابزار باید یاد بگیرد کدام الگوها در یک کدبیس خاص واقعاً باعث ایجاد مشکل میشوند، بهجای آنکه یک مجموعه قوانین کلی را برای هر تیمی، بدون توجه به تاریخچه حوادث (Incident History) خاص آنها، اعمال کند.
برای توسعهدهندگان، این بدان معناست که خط لوله CI/CD دیگر فقط دربارهی تست و استقرار نیست، بلکه دربارهی فیلتر فعال کیفیت است. هدف این است که تا زمانی که یک انسان PR را باز میکند، عناصر «متقاعدکننده اما غلط» پیشتر علامتگذاری شده باشند.
برای درک کامل چرخه حیات این خطاها، تیمها باید فراتر از «میانگین زمان بازیابی» (MTTR) را ببینند و تحلیل خودکار علت ریشهای (Root Cause Analysis) را برای لغزشهای تولیدشده توسط هوش مصنوعی بررسی کنند.



گفتگو