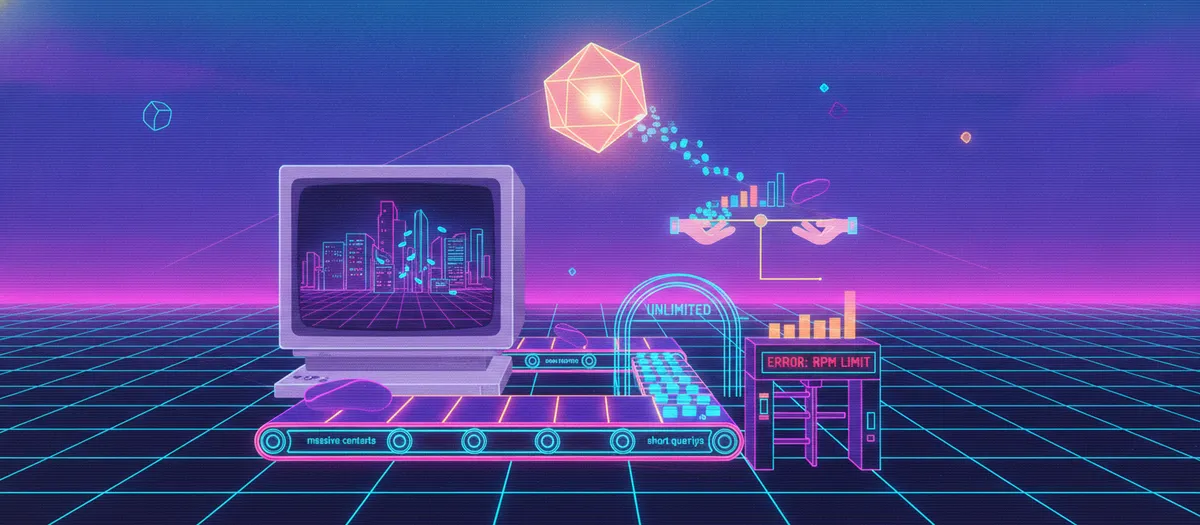
اگر برای اپلیکیشن خود محدودیت تعداد درخواست (Request Limit) تعریف کردهاید، احتمالاً در حال تجربه یک نشت مالی خاموش هستید. در دنیای مدلهای زبانی، یک درخواست ساده با یک درخواست سنگین تفاوت هزینهای هزاربرابری دارد، اما سیستمهای سنتی هر دو را «یک واحد» میشمارند.
به گزارش وبسایت dev.to در ۲۲ سپتامبر ۲۰۲۶، تکیه بر تعداد درخواست برای مدیریت دسترسی به هوش مصنوعی یک خطای معماری بنیادین است که منابع سرور را میبلعد. این موضوع بهویژه برای شرکتهایی که از چتباتهای ساده به سمت پلتفرمهای چندمستاجری (Multi-tenant) میروند، حیاتی است. همانطور که در تحلیلهای قبلی ما دربارهی اقتصاد استنتاج مدلها اشاره کردیم، مدیریت هزینه در مقیاس بالا دیگر با ابزارهای ترافیکی ساده ممکن نیست. در همین راستا، برخی شرکتها با اتخاذ استراتژیهای اندازهگیریمحور توانستهاند هزینههای ماهانه خود را به شکل چشمگیری کاهش دهند.
تصور کنید یک کاربر تنها ۵۰ توکن (Token) — شبیه تکههای کوچکی از متن که مدل تکهتکه میخورد — ارسال میکند، در حالی که کاربر دیگر از یک پنجره زمینه (Context Window) — مثل میز کاری که جا برای چند ورق دارد، نه برای کل کتابخانه — با ۱۰۰ هزار توکن استفاده میکند. در سیستمهای قدیمی، هر دو «یک درخواست» هستند، اما دومی صدها برابر گرانتر است. این وضعیت منجر به اثر «همسایه مزاحم» میشود؛ یعنی یک کاربر سنگین میتواند کل سهمیه سازمان را مصرف کرده و سرویس را برای همه مشتریان دیگر قطع کند. این موضوع با چالشهای مالیاتی پنهان در پنجرههای زمینه بزرگ که هزینهها را در توکنهای بالا دوبرابر میکند، همراستا است.
برای حل این مشکل، نویسنده مقاله یک دفتر کل اعتباری توکنمحور را پیشنهاد میدهد. پیادهسازی این سیستم دشوار است چون توکنها بهصورت خطی به دلار تبدیل نمیشوند. طبق مستندات فنی، سه عامل اصلی این پیچیدگی هستند:
- تفاوت قیمت: توکنهای خروجی معمولاً ۳ تا ۵ برابر گرانتر از توکنهای ورودی هستند.
- سطح مدلها: مدلهای پیشرفته برای تعداد توکن یکسان، ۳ تا ۴ برابر بیشتر هزینه دارند.
- حافظه پنهان پرامپت (Prompt Caching): استفاده از حافظه برای بلوکهای متنی تکراری، هزینه را بهشدت کاهش میدهد.
از آنجا که هزینه دقیق یک پاسخ تنها پس از اتمام تولید مشخص میشود، گزارش مذکور یک «الگوی رزرو» (Reservation Pattern) را پیشنهاد میکند. این سازوکار شبیه پیشپرداخت کارتهای اعتباری است؛ سیستم ابتدا با استفاده از پارامتر max_tokens حداکثر هزینه احتمالی را تخمین زده و آن را در دفتر کل رزرو میکند.
پس از دریافت گزارش مصرف واقعی از ارائهدهنده، هزینه دقیق تسویه شده و اعتبار اضافی آزاد میشود. اگر فراخوانی با خطا مواجه شود، رزرو فوراً آزاد میشود تا در فرآیندهای استریمینگ، موجودی کاربر منفی نشود.
برای پایداری حداکثری، توسعهدهندگان باید یک محدودیت دو لایه ایجاد کنند: زیر-محدودیتهای داخلی برای هر مستاجر با استفاده از الگوریتم «سطل توکن» (Token Bucket) و بررسی سهمیه کلی ارائهدهنده برای نظارت بر مجموع مصرف. در مقابل، برخی پلتفرمها مانند Oxlo.ai سعی دارند با مدلهای قیمتگذاری درخواستی، گلوگاههای استنتاج را از زاویهای متفاوت حل کنند.
این رویکرد، تمرکز توسعهدهنده را از «مدیریت ترافیک» به «مدیریت دفتر کل مالی» تغییر میدهد و معماری فنی را با واقعیت اقتصادی استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، مثل خودِ آشپزی و نه دورهی آموزش آشپز — همراستا میکند.
گام بعدی شما
- منطق محدودیتهای فعلی (Rate Limiting) خود را بازبینی کنید تا ببینید آیا یک کاربر با متنهای طولانی میتواند سرویس را برای دیگران مختل کند یا خیر.
- سیستم رزرو اعتبار را برای جلوگیری از ضررهای مالی در مدلهای گرانقیمت پیادهسازی کنید.
- تفاوت قیمت توکنهای ورودی و خروجی را در محاسبات سودآوری محصولتان لحاظ کنید.
اما مدیریت هزینه تنها نیمی از ماجراست؛ به تحلیل ما دربارهی بهینهسازی حافظه KV Cache برای کاهش تأخیر استنتاج مراجعه کنید.



گفتگو