تولید کد با هوش مصنوعی ارزان شده است، اما تعریف دقیق آنچه باید تولید شود، همچنان هزینهبر است. اگر امروز از پرامپتهای طولانی برای کدنویسی استفاده میکنید، باید بدانید که نقطهٔ شکست شما دیگر مدل نیست، بلکه ابهام در دستورات شماست.
گیتهاب (GitHub) در سپتامبر ۲۰۲۵ با معرفی GitHub Spec Kit، تغییری بنیادین در جریان کار توسعهدهندگان ایجاد کرد. در این مدل، مستندات فنی یا همان Specها — شبیه به یک قرارداد حقوقی که هر بند آن دقیقاً تعریف شده تا جای هیچ تفسیری نباشد — به منبع اصلی حقیقت برای عاملهای هوش مصنوعی (AI Agents) تبدیل میشوند.
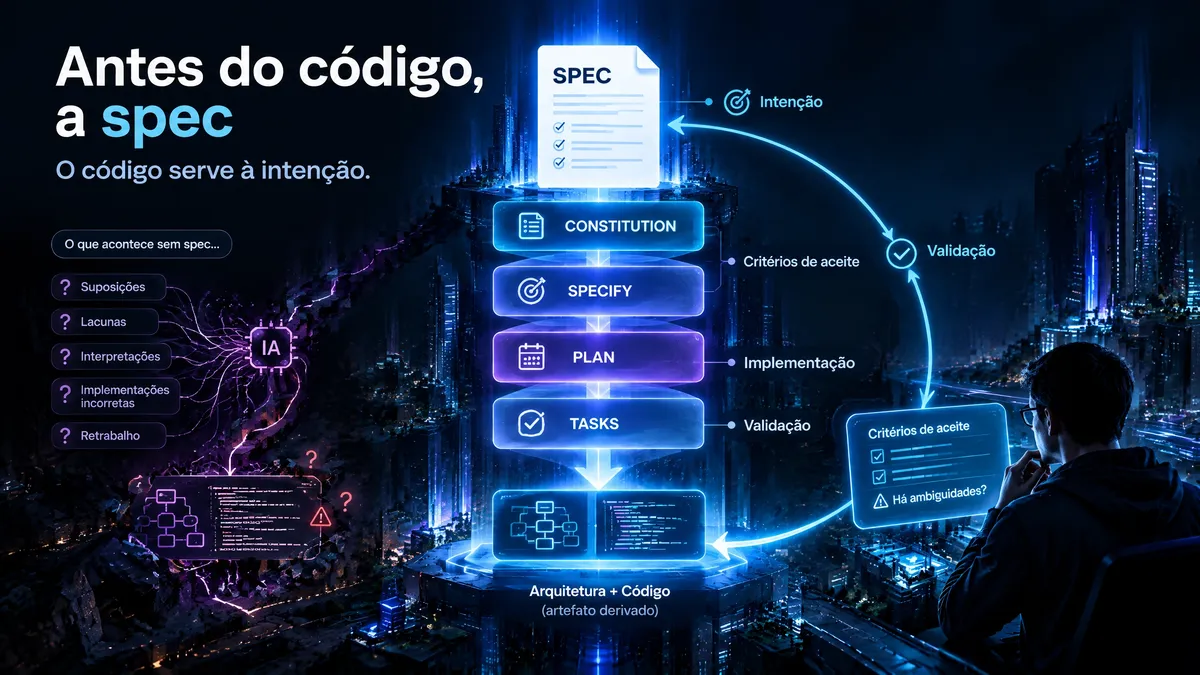
سالهاست که توسعهدهندگان به مستندات به چشم فایلهای Word خاکگرفتهای نگاه میکنند. اما در عصر عاملمحور، این فاصله خطرناک است؛ طبق گزارشهای فنی، وقتی یک عامل با ابهام مواجه میشود، بهجای پرسیدن، شروع به اختراع رفتار میکند. این موضوع منجر به تولید کدهایی میشود که تستهای کلی را پاس میکنند اما در نیازهای حیاتی کسبوکار شکست میخورند و این خطاها معمولاً هفتهها بعد از ادغام کد (Merge) کشف میشوند. این چالشها دقیقاً همان نقاطی هستند که بدهی فنی در کدنویسی AI را افزایش داده و پایداری سیستم را به بهای سرعت فدای میکنند.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، تکیه بر خروجیهای پیشبینیناپذیر مدلها ریسک سیستمیک ایجاد میکند. در واقع، بسیاری از پیکربندیهای عاملهای کدنویس به دلیل همین پیشبینیناپذیری، دارای نقصهای امنیتی جدی هستند. رویکرد توسعهٔ مستند-محور که بر اساس پژوهشهای جان لم (John Lam) شکل گرفته، سلسلهمراتب سنتی را وارونه میکند: اکنون کد در خدمت مستندات است، نه اینکه مستندات توصیفکنندهی کد باشند. در واقع کد به یک «مشتق» تبدیل میشود؛ درست همانطور که یک فایل باینری از سورسکد کامپایل میشود.
معماری قطعیت
به نقل از مستندات صنعتی، پیشروان این حوزه برای تضمین قطعیت (Determinism) از نقاط بازرسی چندمرحلهای استفاده میکنند:
- GitHub Spec Kit: از یک چارچوب ساختاریافته برای پیشبینیپذیر کردن توسعهٔ هدایتشده توسط مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — استفاده میکند.
- Kiro (محصول آمازون): یک خط لوله سهمرحلهای شامل «نیازمندیها»، «طراحی» و «ایجاد وظیفه» را به کار میگیرد. این رویکرد ساختاریافته یادآور استفاده از قراردادهای حافظه برای جلوگیری از خطاهای GraphRAG در مدیریت دادههای حجیم است.
با این حال، این روش هزینههای جدیدی دارد. مستندات نیاز به نگهداری مداوم دارند؛ اگر پروژه تکامل یابد اما مستندات بهروز نشوند، عامل هوش مصنوعی کورکورانه از دستورات قدیمی پیروی میکند. همچنین، تلاش برای نسخهبندی (Versioning) مستندات تنها برای ویژگیهای پیچیده بهصرفه است و برای کارهای کوچک یا میکروسرویسهای پراکنده، ناکارآمد است.
برای توسعهدهنده مدرن، این یعنی نگاه به مستندات به عنوان یک رابط قراردادی (Contract Interface). هدف این است که کمترین مقدار متن — با تمرکز بر قصد، معیارهای پذیرش و محدوده خارجی — نوشته شود تا ابهام به صفر برسد.
این چرخش، نقطهٔ شکست را از یک بازگشت هزینهبر در مرحلهٔ Merge به یک اصلاح ساده در یک جمله منتقل میکند. با تبدیل مستند به «منبع» و کد به «مصنوع»، تیمها میتوانند بدهی فنی (Technical Debt) ناشی از حدسزنیهای هوش مصنوعی را کاهش دهند.
گام بعدی شما
- پرامپتهای فعلی خود را بازبینی کرده و منطق کسبوکار را از دستورات اجرایی جدا کنید.
- یک فایل مستندات (Spec) نسخهبندیشده برای ویژگیهای پیچیده پروژه ایجاد کنید.
- خروجیهای مدل را بر اساس تطابق با مستندات بسنجید، نه فقط بر اساس اجرای صحیح کد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو