تصور کنید در یک دفتر شلوغ یا میان ترافیک شهر هستید و میخواهید ایدههایتان را سریعاً به متن تبدیل کنید؛ جایی که اکثر دستیارهای صوتی تسلیم نویز محیط میشوند. مدل Canto دقیقاً برای همین لحظات ساخته شده تا فاصلهٔ میان محیطهای استریل آزمایشگاهی و هرجومرج دنیای واقعی را پر کند.
آزمایشگاه رابطهای پیشرفته Wispr (Wispr Advanced Interfaces Lab) اعلام کرد که مدل Canto در دقت دیکتهٔ واقعی، مدلهای گوگل و OpenAI را شکست داده است. طبق اعلام این آزمایشگاه، Canto در پردازش صداهای خودبهخودی و نویزی، کمترین نرخ خطای کلمه (Word Error Rate - WER) را میان تمام مدلهای مورد آزمایش به دست آورده است. آریا راسترو، مدیر استراتژی Wispr Flow، میگوید: «ما Canto را به عنوان جدیدترین مدل بازشناسی گفتار برای دیکتهٔ آنی معرفی میکنیم.»
بسیاری از سامانههای بازشناسی گفتار در استودیوهای ساکت عالی عمل میکنند، اما در آشفتگیهای زندگی روزمره شکست میخورند. دیکتهٔ واقعی بهندرت در شرایط کنترلشده اتفاق میافتد. میلیونها کاربر از Wispr Flow برای پیام دادن به دوستان، نوشتن ایمیلها، کدنویسی و پردازش ایدهها در میز کار، بین جلسات، هنگام رفتوآمد و در دفاتر شلوغ استفاده میکنند. آنها از طریق میکروفون لپتاپ، ایربادها و هدستها صحبت میکنند، در حالی که اغلب صداهای دیگران، موسیقی یا ترافیک در پسزمینه شنیده میشود. همانطور که در تحلیل قبلی ما دربارهی تبدیل دیکتههای صوتی به گردشکارهای عاملمحور اشاره کردیم، Canto اکنون روی سختافزارهای معمولی، حتی در حضور نویزهای محیطی، دقت را بالا میبرد تا شکاف میان صدای پاک آزمایشگاهی و واقعیت سخت سختافزاری و محیطی را پر کند.
محک زدن در هرجومرج واقعی
تیم توسعه برای اثبات کارایی Canto، یک مجموعه ارزیابی شامل ۱۰ ساعت دیکته انگلیسی از کاربران واقعی Wispr Flow ایجاد کرد. این مجموعه شامل بیش از ۲۳۰۰ گوینده منحصربهفرد بود که بهصورت تصادفی از کاربردهای مختلف و موارد استفاده گوناگون انتخاب شده بودند. برای جلوگیری از بیشبرازش (Overfitting) — شبیه وقتی دانشآموزی فقط جوابهای یک کتاب خاص را حفظ میکند و نمیتواند به سؤالات جدید پاسخ دهد — آزمایشگاه جداسازی شدیدی میان گویندگان دادههای آموزش و آزمون اعمال کرد تا مدل بر اساس ویژگیهای خاص گویندگان یاد نگیرد.
بر اساس مستندات کنترل دادههای Wispr، تمام نمونههای این ارزیابی از کاربرانی گرفته شده که اجازه اشتراک دادههای خود را داده بودند. این اجازه باعث میشود دادهها بهصورت ناشناس برای ارزیابی و بهبود مدلها مورد استفاده قرار گیرند.
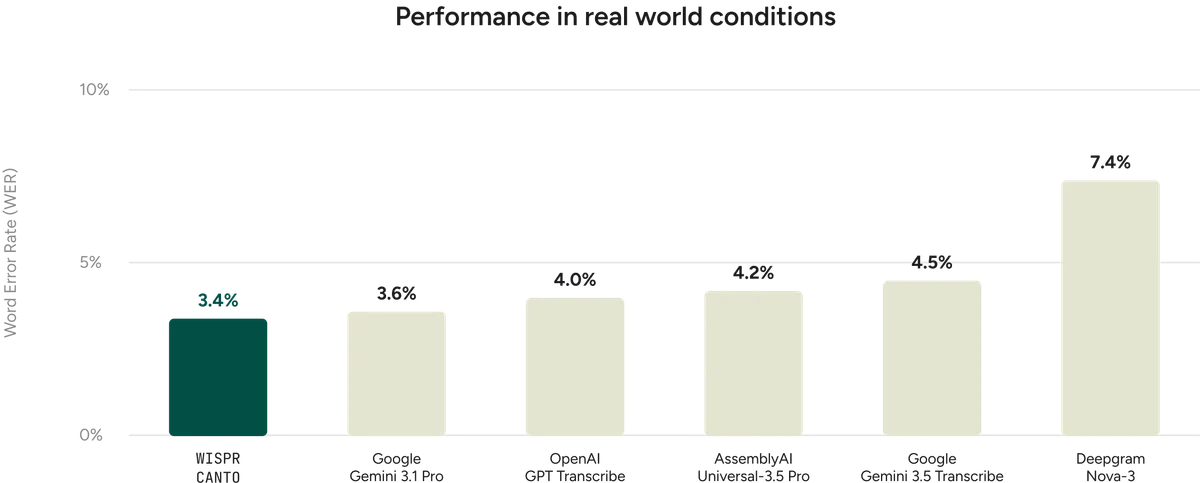
در این مجموعه جامع، Canto از مدلهای گوگل، OpenAI، AssemblyAI و Deepgram پیشی گرفت. معیار اصلی اندازهگیری، نرخ خطای کلمه (WER) بود که جایگزینی، حذف یا اضافه شدن کلمات را نسبت به متن مرجع انسانی میسنجد. در این معیار، هرچه عدد کمتر باشد، عملکرد مدل بهتر است. این رقابت در حالی صورت میگیرد که غولهایی مانند گوگل نیز بهشدت در حال بهینهسازی هستند؛ چنانکه گوگل پیشتر موفق شد نرخ خطای تبدیل گفتار به متن خود را به ۲.۶٪ برساند تا استانداردهای جدیدی در این حوزه تعریف کند.
تست استرس: نقطه شکست مدل
تیم Wispr برای فشار آوردن به مدل، یک «مجموعه ارزیابی چالشی» ۳ ساعته ساخت تا مدل را تا نقطه شکستش پیش ببرد. این مجموعه شامل شرایطی بود که احتمال شکست دیکته در آنها بسیار زیاد است:
- نویز محیطی: صداهایی که تحت تأثیر صحبتهای نزدیک، موسیقی، ترافیک و باد قرار دارند.
- کیفیت پایین صدا: حجم ضبط پایین، صحبتهای پچپچگونه و صحبت از فاصله دور (Far-field).
- کمبود زمینه: دیکتههای بسیار کوتاه که زمینه زبانی بسیار کمی برای کمک به مدل در حل ابهامات فراهم میکنند.
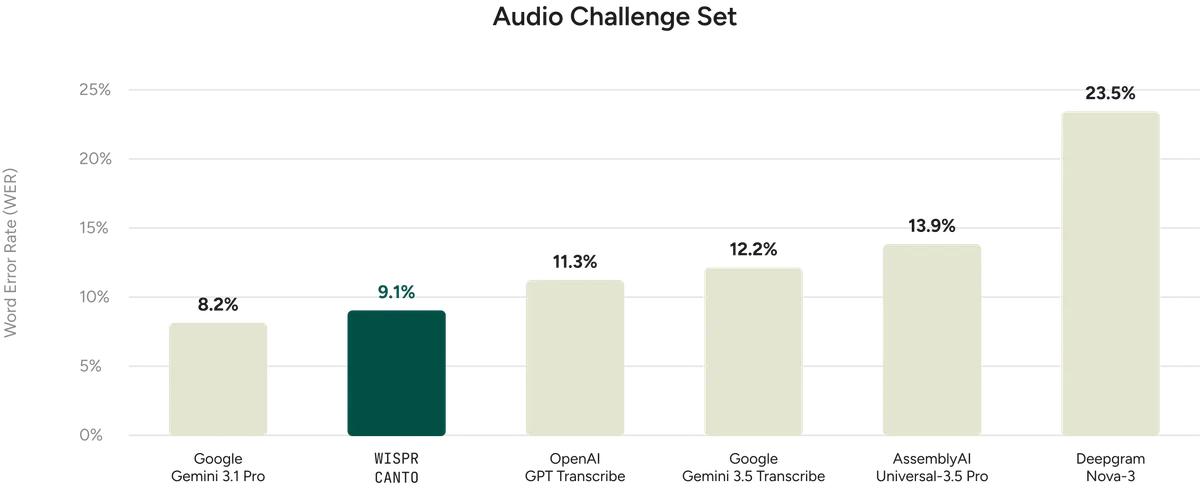
در این محیط پرفشار، Canto رتبه دوم را پس از Gemini 3.1 Pro کسب کرد. با این حال، آزمایشگاه اشاره کرد که Gemini 3.1 Pro یک مدل چندوجهی (Multimodal) در مقیاس مدلهای پیشرو (Frontier-size) و بسیار حجیم است که برای کاربردهای آنی با تأخیر کم (Low-latency) مناسب نیست. در میان مدلهای مخصوص ترنسکریپشن آنی که ارزیابی شدند، Canto کمترین نرخ خطا را داشت.
تحلیل نقاط ضعف
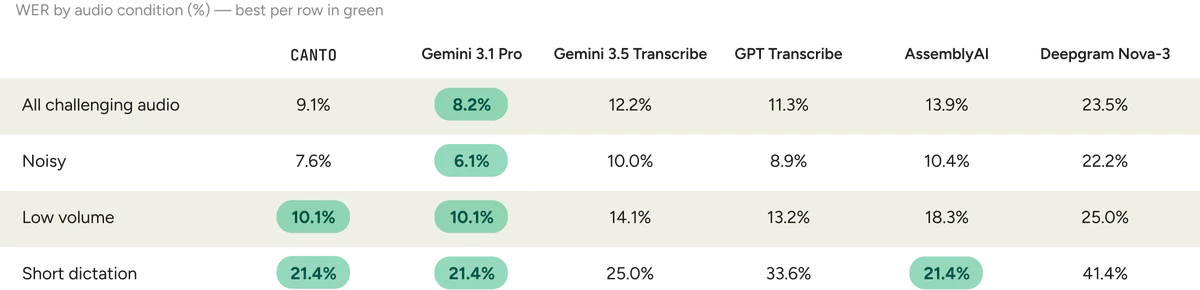
بررسی دقیقتر مجموعه دادههای چالشی نشان داد که مدلهای مختلف تحت فشار چگونه رفتار میکنند. Gemini 3.1 Pro کمترین نرخ خطا را در صداهای نویزی (تعریف شده به عنوان دیکتههایی با SNR پایین و نویز پسزمینه شدید مانند باد یا ترافیک) به دست آورد.
اما Canto در تشخیص پچپچها، صحبتهای دور و جملات بسیار کوتاه، رتبه اول (یا مشترک در کمترین خطا) را به دست آورد. جالب است که جملات ۱ تا ۲ کلمهای در تمام مدلهای مقایسه شده، بیشترین نرخ خطا را داشتند. دلیل این امر آن است که در جملات کوتاه، یک اشتباه کوچک تأثیر نسبی بزرگی روی WER میگذارد و مدل زمینه زبانی کمتری برای رفع ابهام در اختیار دارد.
دادههای عمومی در برابر دادههای واقعی
در تست روی سه مجموعه داده عمومی انگلیسی شامل LibriSpeech، FLEURS و Common Voice، مدل Canto رقابتی باقی ماند. این مدل در LibriSpeech کمترین نرخ خطا را به دست آورد، هرچند در FLEURS یا Common Voice پیشرو نبود. این مدلها بدون استفاده از پرامپتهای زمینهای (Contextual Prompting) ارزیابی شدند.
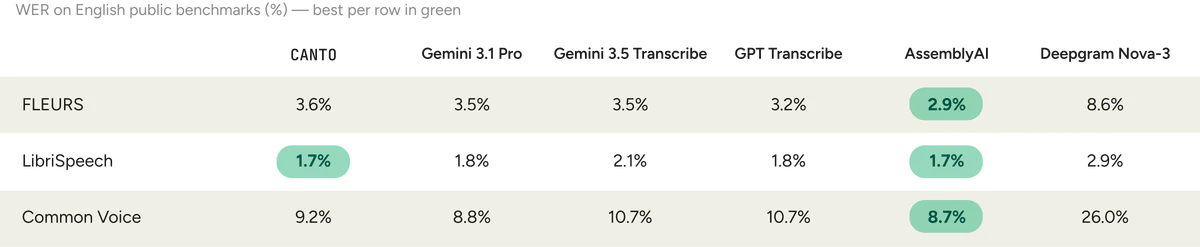
با این حال، آزمایشگاه استدلال میکند که این مجموعههای عمومی گمراهکننده هستند چون عمدتاً شامل «متنهای خواندهشده» (Read Speech) هستند. برای مثال، LibriSpeech از کتابهای صوتی گرفته شده و FLEURS و Common Voice عمدتاً شامل افرادی است که جملات از پیش آماده شده را میخوانند.
دیکته واقعی توزیع متفاوتی دارد. در استفادههای «در محیط واقعی» (In-the-wild)، مردم بهصورت خودبهخودی حرف میزنند، مکث میکنند، افکارشان را اصلاح میکنند و اغلب زمینه زبانی بسیار کمی ارائه میدهند. این تضاد توضیح میدهد که چرا آزمایشگاه دادههای واقعی استفاده از Wispr را بر بنچمارکهای عمومی قابل تکرار ترجیح میدهد.
راز آموزش: متد GRPO
مدل Canto از یک مدل پیشآموزشدیده روی میلیونها ساعت گفتار و متن شروع میشود. عملکرد برتر آن مدیون یک فرآیند پسآموزش دو مرحلهای است:
۱. تنظیم نظارتشده (SFT): در این مرحله، مدل صداهای جفتشده با متنهای مرجع را میبیند و یاد میگیرد کلمات را یکی پس از دیگری پیشبینی کند. این مرحله به مدل میآموزد که وظیفه پایه ترنسکریپشن را چگونه انجام دهد.
۲. یادگیری تقویتی (RL): مدل آموزش میبیند تا کیفیت متنهای کامل تولید شده را مقایسه کند. برای یک صوت واحد، مدل چندین ترنسکریپشن احتمالی تولید میکند که سپس در برابر یک مرجع امتیازدهی میشوند.
بهطور مشخص، تیم از روش بهینهسازی سیاست نسبی گروهی (GRPO) استفاده کرد که اخیراً در DeepSeekMath معرفی شده است. در این روش، مدل به جای پیشبینی صرف کلمه بعدی، چندین کاندید برای متن تولید میکند که به آنها «رولاوت» (Rollouts) میگویند.
هر رولاوت یک پاداش (امتیاز عددی) دریافت میکند که نشان میدهد هدف آموزشی را تا چه حد برآورده کرده است. GRPO پاداش هر کاندید را با پاداش سایر کاندیدها در همان گروه مقایسه میکند. امتیاز نسبی حاصل، که «مزیت» (Advantage) نامیده میشود، نشان میدهد که آن کاندید بهتر یا بدتر از گروهش عمل کرده است و این موضوع جهت بهروزرسانی آموزش را تعیین میکند.
یادگیری از اصلاحات انسانی
واژگان و نحوه استفاده از نامها سریعتر از آن تغییر میکنند که مدلها دوباره آموزش ببینند. برای مثال، کلمهای مثل "Claude" ممکن است زمانی یک جایگزین غیرمعمول برای "cloud" بوده باشد. برای مدیریت این موضوع، Wispr راهی ابداع کرد تا ویرایشهای کاربران را برای کسانی که اجازه اشتراک داده دادهاند، به سیگنالهای آموزشی تبدیل کند.
از آنجا که هر ویرایشی لزوماً خطای ترنسکریپشن نیست (کاربران اغلب فرمت را تغییر میدهند یا جملات را بازنویسی میکنند)، Wispr از سیگنالهای صوتی و خودِ ویرایش برای شناسایی خطاهای واقعی بازشناسی استفاده میکند. آنها از این ابزارها بهره میبرند:
- اعتماد تراز اجباری (Forced-alignment confidence): اندازهگیری اینکه کلمات کاندید چقدر با موج صوتی مطابقت دارند.
- تحلیل ویرایش: بررسی مکان و شکل ویرایش انجام شده.
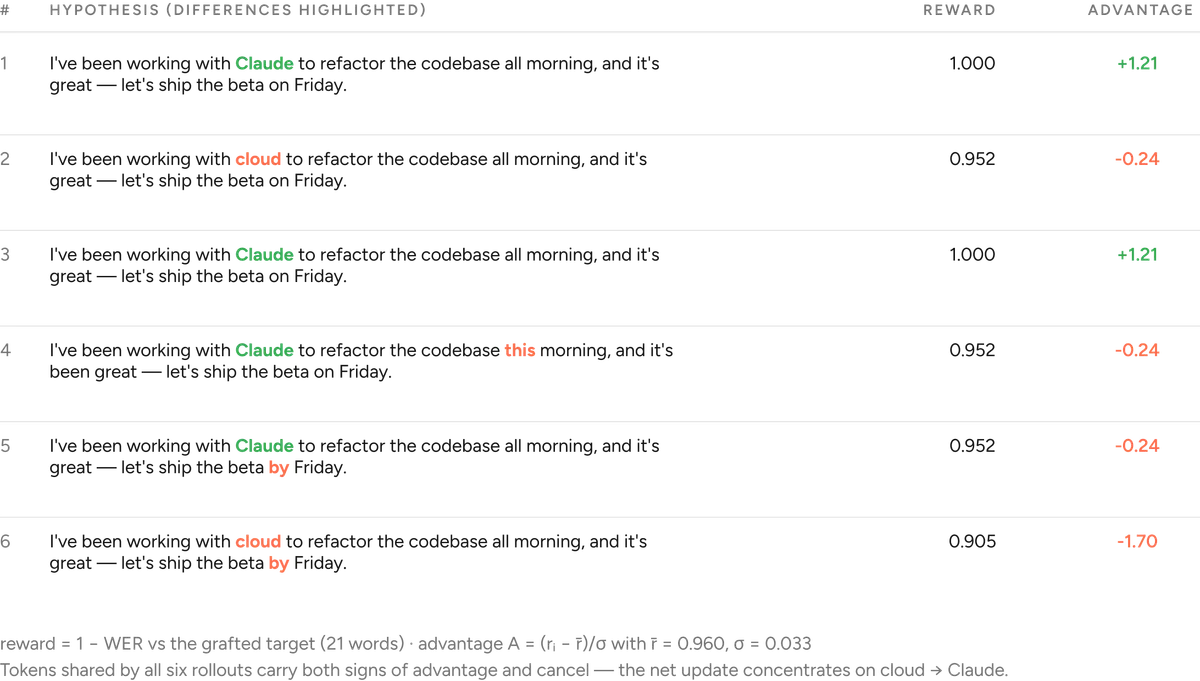
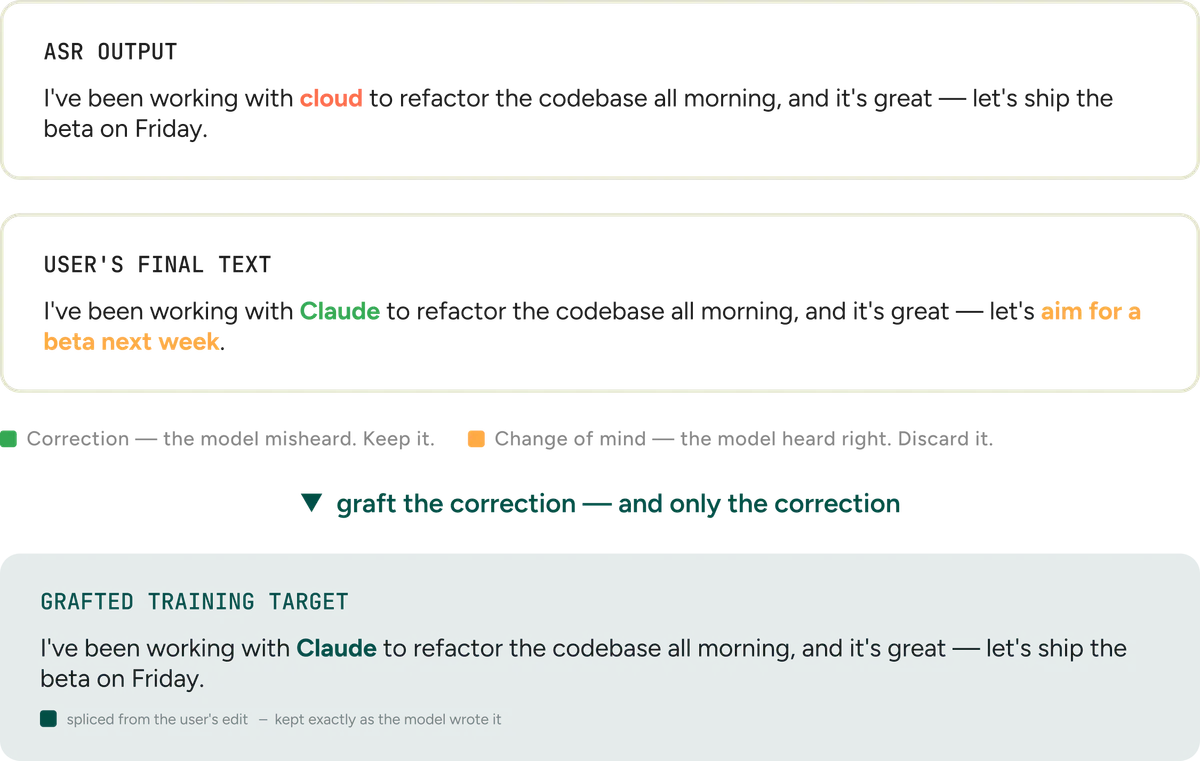
آزمایشگاه با «پیوند زدن» (Grafting) تنها اصلاحات محتمل به متن اصلی و بدون تغییر باقی گذاشتن سایر بخشها، یک سیگنال آموزشی متمرکز در سطح توالی ایجاد میکند. این متن پیوندزده به عنوان مرجعی برای امتیازدهی به رولاوتهای GRPO استفاده میشود. یک فرضیه زمانی پاداش بیشتری میگیرد که اصلاح مورد نظر را اعمال کرده باشد. چون GRPO مزایا را در هر گروه مرکز میکند، کلماتی که در فرضیات با پاداش بالا و پایین مشترک هستند، سیگنالهای خنثیکننده دریافت میکنند و تضاد آموزشی را به تصمیم خاصی که در حال آموزش است محدود میکند.
حل معمای زمینه (Context)
در زمان اجرا، Canto واژگان تخصصی از لغتنامه شخصی فرد را دریافت میکند تا نامها و اصطلاحات نادر را بازیابی کند. اما این کار ریسک «پذیرش بیش از حد» (Overeager adoption) زمینه را ایجاد میکند. اگر "Barry" در لغتنامه باشد و کاربر بگوید "I want to make a berry salad"، یک مدل بیشازحد مشتاق ممکن است "Barry" را انتخاب کند چون در لغتنامه هست، حتی اگر صوت نشاندهنده "berry" باشد.
برای اندازهگیری این موضوع، آزمایشگاه مدل را با «منحرفکنندههای مصنوعی» (Synthetic distractors) تست کرد که شباهت آوایی متفاوتی با کلمه صحیح داشتند. «تغییر منحرفکننده» (Distractor flip) زمانی رخ میدهد که یک پیشنهاد غلط باعث شود مدل آن را بپذیرد.
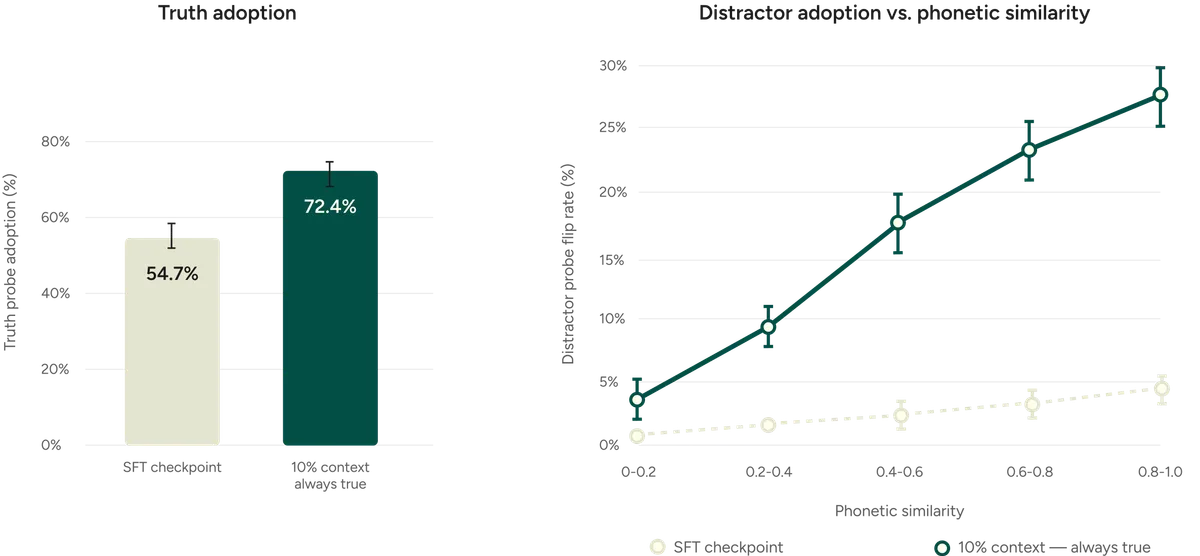
آموزش اولیه RL مدل را نسبت به زمینه پاسخگوتر کرد، اما همزمان آن را در برابر خطاها آسیبپذیرتر ساخت. در میان اصطلاحات با شباهت آوایی زیاد، مدل تقریباً ۵ برابر بیشتر از مدل SFT اولیه، منحرفکنندهها را پذیرفت. برای رفع این مشکل، آزمایشگاه سه اجرای مختلف را از یک نقطه شروع (Checkpoint) SFT آموزش داد:
- همیشه درست (Always True): زمینه ارائه شده فقط شامل کلمه صحیح بود. این منجر به یک میانبر شد که در آن مدل هر کلمهای را که شبیه صوت بود میپذیرفت و باعث افزایش پیروی از زمینه غلط شد.
- منحرفکنندهها + درست (Distractors + True): کلمه صحیح در کنار جایگزینهای مشابه آوایی ظاهر شد. این کار زمینه را به یک مسئله «انتخاب» تبدیل کرد و مدل را برای انتخاب کاندیدی که توسط صوت پشتیبانی میشد، پاداش داد.
- فقط منحرفکنندهها (Distractors Only): نمونهها به جای کلمه صحیح، شامل موارد نزدیک اما غلط بودند. این کار زمینه را «خصمانه» کرد و مدل را مجبور کرد پیروی از زمینه غلط را کاهش دهد در حالی که پذیرش زمینه درست را حفظ کند.
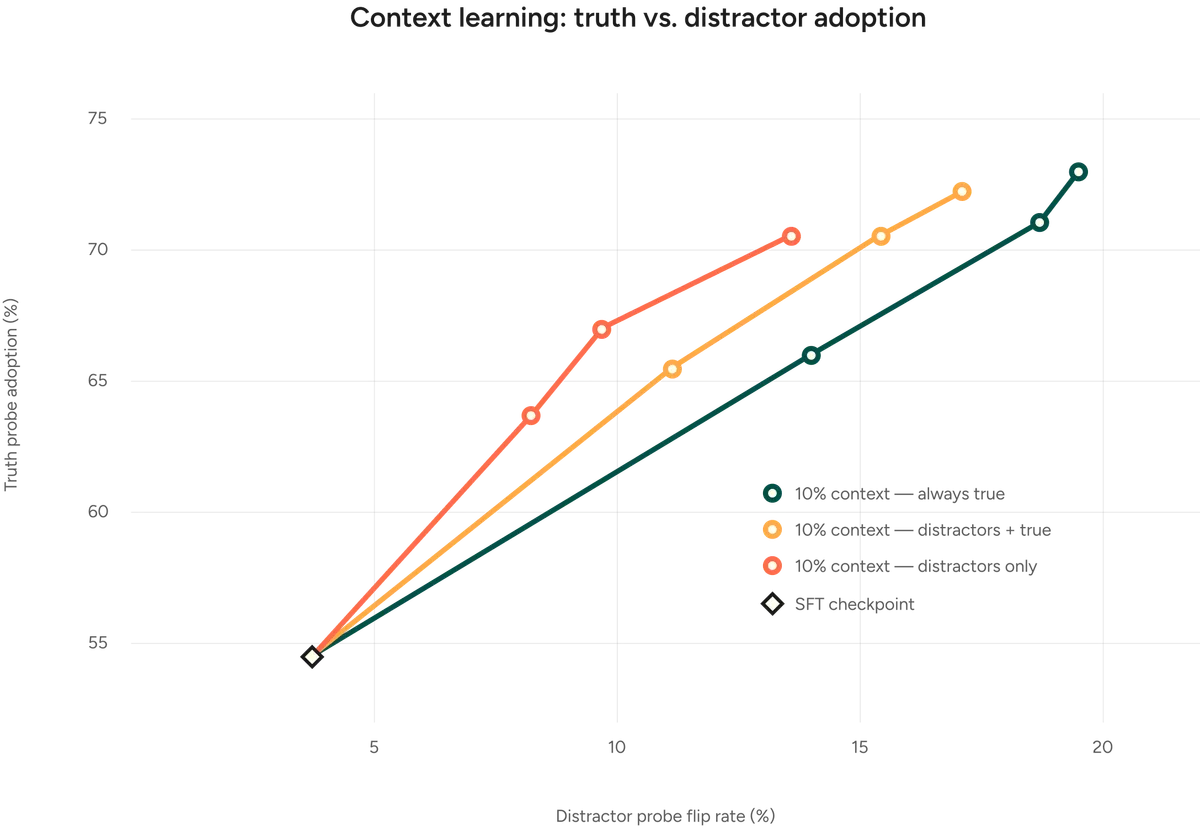
این آزمایشها نشان میدهند که توازن بین «پذیرش» و «تمایز» قابل آموزش است. هدف این است که به مدل یاد داده شود چه زمانی زمینه ارزش دنبال کردن دارد و چه زمانی باید به نفع صوت نادیده گرفته شود.
مسیر رسیدن به صوت یکپارچه
مدل Canto اولین مدل در یک خانواده بزرگتر است. آزمایشگاه در حال حاضر جانشینی را با مقیاسی بیش از ۱۰ برابر Canto آموزش میدهد. اهداف این نسل بعدی عبارتند از:
- بازشناسی بهبودیافته: عملکرد بهتر در شرایط صوتی دشوار.
- بازشناسی چند-گوینده: ارتقای محصول یادداشتبردار (Notetaker) که اخیراً عرضه شده است.
- تسلط زمینهای: استفاده بهینه تر از واژگان زمینهای.
- گسترش چندزبانه: رسیدن به همین استاندارد دقت در زبانهای بیشتر.
یکی از تمرکزهای اصلی، معماری یکپارچه برای ترنسکریپشن و تفکیک گوینده (Diarization) است. اکثر سیستمهای ترنسکریپشن جلسات، کلمات را شناسایی کرده و سپس گویندگان را در مراحل جداگانه تشخیص میدهند، که باعث میشود خطاهای یک مرحله در مرحله دیگر جمع شوند. یک مدل مشترک میتواند همزمان درباره اینکه چه گفته شد، چه کسی گفت و چه زمانی گوینده تغییر کرد، استدلال کند. ساختار گوینده همچنین میتواند در محیطهای نویزی شواهدی برای تشخیص مکالمه اصلی از صدای پسزمینه ارائه دهد. در این راستا، توسعه استکهای پیشرفته برای پردازش همزمان صوت و متن حیاتی است؛ موضوعی که در تحلیل ارکان اصلی ساخت استکهای چندوجهی برای ترجمه رباتیک زنده به آن پرداختیم.
با گذشت زمان، این مدلها باید کاربردی را که فرد در آن صحبت میکند درک کنند و کلمات را به هدف نهایی کاربر متصل کنند. Canto مدل گفتاری، رویکرد آموزشی و چارچوب ارزیابی را برای دنبال کردن این رابط گستردهتر فراهم میکند. برای کاربران تجاری، این امر «مالیات ویرایش» — یعنی زمانی که صرف اصلاح اشتباهات هوش مصنوعی میشود — را کاهش داده و تبدیل صوت به متن را از یک ابزار پیشنویس اولیه به یک رابط آماده تولید تبدیل میکند. در دنیای امروز که سرعت پردازش حرف اول را میزند، مدلهایی مانند Granite Speech 5.0 آیبیام که قادر است ۳.۵ ساعت صوت را در یک ثانیه تبدیل به متن کند، نشان میدهند که مرزهای بهرهوری در ترنسکریپشن به کجا میرود.
گام بعدی شما
- اگر از ابزارهای دیکته برای یادداشتبرداری استفاده میکنید، روی مدلهایی تمرکز کنید که از دادههای «در محیط واقعی» (In-the-wild) آموزش دیدهاند، نه فقط مجموعههای کتاب صوتی.
- برای کاهش خطای نامهای خاص در مدلهای صوتی، از قابلیتهای لغتنامه شخصی (Custom Vocabulary) استفاده کنید.
- منتظر مدلهای یکپارچه (Joint Models) باشید که تفکیک گوینده و تبدیل صوت به متن را همزمان انجام میدهند تا دقت جلسات ضبطشده افزایش یابد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو