تصور کنید عاملهای هوش مصنوعی شما در محیط تولید (Production) بهخوبی کار میکنند، کاربران راضی هستند و همه چیز طبق برنامه پیش میرود. اما وقتی صورتحساب ماهانه میرسد، مبلغ آن سه برابر تخمینهای اولیه و مدلهای مالی شماست. شما داشبورد OpenAI را باز میکنید و فقط مجموع هزینهها بهتفکیک مدل و مجموع توکنهای مصرفشده در هر روز را میبینید؛ عددی که به شما میگوید همه چیز بالا رفته است، اما هیچ توضیحی درباره «چرا» نمیدهد.
به گزارش منابع فنی، غولهایی مثل OpenAI، Anthropic و Google هزینهها را بهتفکیک مدل نشان میدهند، اما در نمایش این موضوع شکست میخورند که کدام عامل خاص — خواه برای پشتیبانی باشد، یا کدنویسی یا استخراج داده — مسئول این قبض سنگین است. در واقع، هر ارائهدهنده بزرگ LLM از جمله OpenAI، Anthropic، Google، Mistral و DeepSeek تقریباً داشبورد یکسانی ارائه میدهد: مجموع توکنهای مصرفی و هزینه کل، تفکیک شده بر اساس مدل و روز.
این سطح از اطلاعات برای یک بررسی مالی ماهانه کافی است، اما برای عملیات (Operations) کاملاً بیفایده است. این داشبوردها نمیتوانند به شما بگویند کدام ویژگی (Feature) محرک هزینه است، آیا جهش هزینهها ناشی از افزایش حجم فراخوانیهاست یا طولانی شدن پرامپتها، و یا اینکه آیا سیستم حافظه پاداش (Prompt Caching) شما بهطور خاموش دچار شکست شده است. همچنین مشخص نمیشود کدام عاملها بیش از حد نیاز، توکنهای خروجی تولید میکنند.
این شکاف دیدگاهی باعث میشود تیمها بهجای داده، بر اساس حدس و گمان بهینهسازی کنند. تا تاریخ ۳۰ سپتامبر ۲۰۲۶، اکثر تیمها در این وضعیت قرار دارند. این موضوع بازتابدهنده یک روند گستردهتر از «بدهی فنی» در استقرار هوش مصنوعی است؛ مشابه همان اتفاقی که در مورد تستهای تولید شده توسط AI میافتد که بدون بررسیهای دقیق، بیارزش میشوند (موضوعی که پیشتر پوشش دادیم). مشکل اصلی این نیست که «کدام مدل ارزانتر است» — چون صدها جدول مقایسهای برای این کار وجود دارد — بلکه مشکل این است که وقتی عاملها فعال شدند، شما تقریباً هیچ دیدی نسبت به محرکهای واقعی هزینه ندارید.
اگر پنج عامل مختلف داشته باشید — یکی برای طبقهبندی، یکی برای خلاصهسازی دادهها، سومی برای بررسی کد، چهارمی برای پشتیبانی و پنجمی برای استخراج داده — یک داشبورد کلی نمیتواند بگوید جهش هزینه از کجا آمده است. وقتی شما یک عامل دارید که یک مدل را فراخوانی میکند، هزینه کلی کافی است. اما وقتی پنج عامل با مدلهای مختلف و نرخهای متفاوت کار میکنند، هزینه کلی همه چیز را پنهان میکند. اولین نیاز هر سیستم تولیدی جدی، «تخصیص هزینه بهتفکیک هر عامل» (Per-agent cost attribution) است: هزینه بهتفکیک عامل، بهتفکیک هر فراخوانی و بهصورت لحظهای.
مکانیسمهای پنهان مصرف توکن
برای متوقف کردن این ریزش بودجه، باید سه دسته توکن در هر فراخوانی API را بهدقت بشناسید:
- توکنهای ورودی (Input Tokens): شامل پرامپت، پیامهای سیستمی، زمینههای تزریق شده (Injected Context)، تاریخچه گفتگو و پیام کاربر.
- توکنهای خروجی (Output Tokens): متنی که مدل تولید میکند. این توکنها معمولاً در اکثر مدلها گرانترین بخش هستند.
- توکنهای ورودی حافظهشده (Cached Input Tokens): توکنهای ورودی که بهجای پردازش مجدد، از حافظه موقت (Cache) ارائهدهنده خوانده میشوند.
طبق مستندات Anthropic، توکنهای حافظهشده تقریباً با ۱۰٪ نرخ استاندارد ورودی محاسبه میشوند. صرفهجوییهای مشابهی برای پرامپتهای واجد شرایط در OpenAI نیز اعمال میشود. این تفاوت در عمل بسیار عظیم است. عاملی را تصور کنید که یک پرامپت سیستمی ۳۰۰۰ توکنی دارد و ۵۰۰۰ بار در روز فراخوانی میشود. این عامل روزانه ۱۵ میلیون توکن ورودی فقط برای پرامپت سیستمی ارسال میکند (بدون احتساب پیامهای کاربر). اگر این توکنها حافظهشوند، شما هزینه تقریباً ۱.۵ میلیون توکن مؤثر را میپردازید. اگر حافظهنشوند، برای هر فراخوانی هزینه کامل پرداخت میکنید. اکثر تیمها از Caching استفاده نمیکنند و بسیاری حتی نمیدانند آیا حافظه پاداش آنها اصلاً کار میکند یا خیر.
سه محرک اصلی هزینه
بر اساس بررسی دادههای محیط تولید، سه الگوی تکراری وجود دارد که بودجهها را میبلعند:
۱. بستر ثابت تکراری (Repeated Stable Context): این شامل پرامپتهای سیستمی، دستورالعملهای پسزمینه، پایگاههای دانشی و کاتالوگ محصولات است؛ محتوایی که در هر فراخوانی یکسان است. اگر اینها حافظهنشوند، شما هزاران بار در روز برای پردازش مجدد آنها هزینه میپردازید. این مورد تقریباً همیشه بزرگترین محرک هزینه و در عین حال سادهترین مورد برای اصلاح است.
۲. تورم پرامپت (Prompt Bloat): پرامپتها بهمرور زمان رشد میکنند. تیمها دستورالعملهای جدید، مثالها، مدیریت حالتهای خاص (Edge-cases) و توضیحات بیشتر را اضافه میکنند، اما هیچکس چیزی را حذف نمیکند. پرامپتی که در زمان عرضه ۸۰۰ توکن بود، ممکن است یک سال بعد به ۲۴۰۰ توکن برسد. چون هر افزودنی در هر فراخوانی و هر روز تکرار میشود، اکثر تیمها هرگز پرامپتهای خود را با هدف اولیه بازبینی نکردهاند.
۳. خروجیهای نامحدود (Unbounded Outputs): برخی عاملها بسیار بیشتر از آنچه برای تکلیف لازم است، خروجی تولید میکنند. برای مثال، یک عامل طبقهبندی که باید فقط یک برچسب و یک امتیاز اطمینان برگرداند، اما در عوض شروع به توضیح مفصل استدلالهای خود میکند؛ یا یک عامل خلاصهسازی بدون محدودیت طول که خلاصههای ۸۰۰ کلمهای تولید میکند در حالی که ۲۰۰ کلمه برای کاربر کافی بود. خروجیهای کنترلنشده، یک منبع ریزش هزینه خاموش و مداوم هستند.
راهکار با بازدهی بالا: حافظه پاداش (Prompt Caching)
حافظه پاداش (Prompt Caching) اثرگذارترین بهینهسازی موجود است. این قابلیت میتواند هزینههای ورودی را ۸۰ تا ۹۰٪ کاهش دهد بدون اینکه تغییری در خروجی مدل ایجاد کند. مکانیسم آن ساده است: اگر بخش اول پرامپت شما در فراخوانیهای مختلف یکسان باشد، ارائهدهنده آن را ذخیره کرده و در فراخوانیهای بعدی که همان پیشوند (Prefix) را دارند، از حافظه میخواند و کسری از نرخ عادی را دریافت میکند.
با این حال، Caching بسیار شکننده است و الزامات خاصی دارد:
- طول: پیشوند قابل حافظهشدن باید به اندازه کافی طولانی باشد؛ Anthropic حداقل ۱۰۲۴ توکن را میطلبد.
- ثبات: هر تغییری — حتی تفاوت در یک کاراکتر — باعث ابطال حافظه میشود.
- موقعیت: محتوای ثابت باید در ابتدا قرار گیرد؛ محتوای پویا مانند پیامهای کاربر و زمینههای متغیر باید در انتها باشند.
- کنترل: در Anthropic، شما باید نشانگرهای کنترل حافظه (Cache Control Markers) را در نقاط شکست درست اضافه کنید. در OpenAI، حافظه برای پرامپتهای واجد شرایط خودکار است اما برای فعال شدن به ساختار صحیح نیاز دارد.
دهها راه برای شکستن تصادفی این سیستم وجود دارد. درج یک برچسب زمانی (Timestamp) در ابتدای پرامپت سیستمی، شخصیسازی نام کاربر در ابتدای دستورالعملها، استقراری که یک جمله از پرامپت را تغییر میدهد، یا تغییر ترتیب تعریف ابزارها (Tool Definitions) بین فراخوانیها، همگی باعث شکست خاموش حافظه میشوند. شما هزینه کامل میپردازید و داشبورد نظارتی شما نمیگوید چرا. تنها معیار مهم در اینجا «نرخ برخورد حافظه» (Cache Hit Rate) است؛ یک عامل پایدار با حجم فراخوانی بالا باید در حالت عادی نرخ برخورد ۹۰٪ داشته باشد. اگر کمتر است، چیزی در حال باطل کردن حافظه است و باید آن را پیدا کنید.
مسیر بهینهسازی
به نقل از گزارش dev.to، تیمها باید ترتیب خاصی از عملیات را دنبال کنند تا تلاشهایشان هدر نرود. اکثر تیمها سعی میکنند قبل از اینکه بتوانند «ببینند»، بهینهسازی کنند؛ یعنی مدلها را عوض میکنند یا پرامپتها را کوتاه میکنند بدون اینکه خط مبنایی (Baseline) داشته باشند تا بفهمند آیا این کار اثر داشته است یا خیر.
- ایجاد دید (Establish Visibility): ابتدا تفکیک هزینه و توکن بهتفکیک هر عامل (ورودی، خروجی، حافظهشده)، تأخیر (Latency) و نرخ خطا را پیاده کنید. این خط مبنای شماست و هر چیز دیگری به آن وابسته است. برای کسانی که با چندین مدل مختلف کار میکنند، استفاده از یک داشبورد واحد برای ردیابی مصرف توکنها اولین گام در جهت دستیابی به این دیدبانی است.
- شناسایی اهداف (Identify Targets): ۲۰٪ از عاملهایی که ۸۰٪ هزینه را ایجاد میکنند پیدا کنید. از دادهها برای شناسایی عاملهایی با بدترین نرخ برخورد حافظه یا خروجیهای بهطور غیرمنتظره طولانی استفاده کنید.
- فعالسازی حافظه (Enable Caching): حافظه پاداش را برای هر پرامپت ثابت بالای ۱۰۲۴ توکن اعمال کنید. این بالاترین بازدهی (ROI) ممکن است چون به خروجیها دست نمیزند.
- حذف زوائد (Audit for Waste): نمونههایی از پرامپتهای واقعی در محیط تولید را بررسی کنید. به دنبال دستورالعملهای تکراری، متون قدیمی از ویژگیهای حذف شده، یا زمینههایی بگردید که در هر فراخوانی تزریق میشوند اما فقط گاهی لازم هستند. ۲۰٪ کاهش در اندازه پرامپت، به معنای ۲۰٪ کاهش دائمی در هزینههای ورودی است.
- محدود کردن خروجی (Constrain Outputs): راهنماییهای صریح برای طول متن اضافه کنید و برای تکالیفی که نیاز به نثر ندارند، از فرمتهای خروجی ساختاریافته (Structured Output) استفاده کنید. سقف توکنهای خروجی (Max Tokens) معقولی تعیین کنید.
- تغییر مدل (Switch Models): جایگزینهای ارزانتر را تنها پس از تثبیت سیگنالهای کیفیت تست کنید. GPT-4o mini بین ۱۰ تا ۱۵ برابر ارزانتر از GPT-4o است و در بسیاری از تکالیف عملکرد مشابهی دارد. DeepSeek V3 برخی از پایینترین قیمتهای ورودی را برای یک مدل کلاس Frontier ارائه میدهد. هدف باید «هزینه بهازای هر خروجی قابل قبول» باشد، نه «هزینه بهازای هر توکن».
حل مشکل دیدبانی
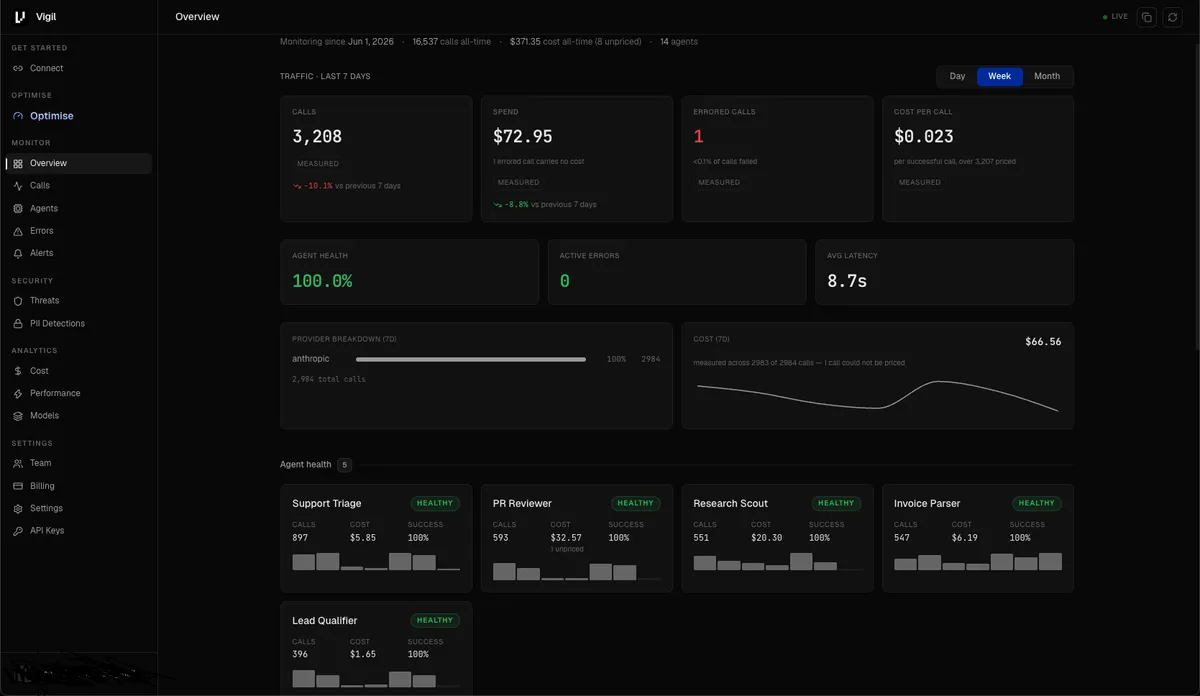
برای دسترسی به این دادهها نیازی به بازنویسی برنامه نیست. یک لایه پروکسی (Proxy Layer) مانند Vigil بین برنامه و ارائهدهنده قرار میگیرد. با تغییر یک URL پایه — یعنی تغییر URL ارائهدهنده به نقطه انتهایی (Endpoint) پروکسی — هر فراخوانی بهتفکیک عامل، هزینه و تأخیر بهصورت لحظهای ثبت میشود. این روش در OpenAI، Anthropic، Gemini، Mistral و DeepSeek کار میکند. کد برنامه، پرامپتها و خروجیهای شما تغییر نمیکنند. این کار تنها چند میلیثانیه تأخیر شبکه اضافه میکند اما دیدبانی عملیاتی کامل به شما میدهد.
این رویکرد نیاز به ساخت داشبوردهای سفارشی یا ابزارگذاری کد را از بین میبرد. به تیمها اجازه میدهد «رانش هزینه» (Cost Drift) — جایی که هزینه متوسط هر فراخوانی یک عامل بهتدریج بالا میرود — را قبل از تبدیل شدن به یک صورتحساب ماهانه عظیم شناسایی کنند. همچنین به شناسایی سریعتر باگها کمک میکند؛ جهش هزینه در یک عامل اغلب نشانه یک حلقه بینهایت (Runaway Loop)، زمینهای است که بهطور نامحدود رشد میکند، یا تغییری در پرامپت که حافظه را شکسته است. نظارت بهتفکیک عامل، این موارد را بهعنوان ناهنجاری (Anomaly) نشان میدهد، بهجای اینکه آنها را در اعداد کلی پنهان کند.
با دیدبانی بهتفکیک عامل، میتوانید بودجههای واقعی بر اساس هزینههای p50 و p95 برای هر فراخوانی تعیین کنید. میتوانید تصمیمات بهتری درباره مدل بگیرید؛ مثلاً متوجه شوید که یک عامل خلاصهسازی ممکن است روی مدلی که ۱۰ برابر ارزانتر از یک عامل استدلال پیچیده است، به همان اندازه خوب عمل کند. شما این موضوع را فقط از طریق تست و اندازهگیری هزینه بهتفکیک عامل پس از تغییر مدل میفهمید.
مشکل هزینههای ترکیبی
هزینههای LLM بهگونهای متفاوت از سرورهای ابری سنتی ترکیب میشوند. هزینه یک سرور ثابت، تخت میماند، اما هزینههای AI با طول پرامپت، حجم فراخوانیها و تعداد عاملها مقیاس میپذیرند. همان معماری که در زمان عرضه ۴۰۰ دلار در ماه هزینه داشت، میتواند ۱۸ ماه بعد ۴۰۰۰ دلار در ماه هزینه کند و تیم واقعاً گیج شود که چرا این اتفاق افتاده است. این نوسانات شدید در مدلهای مصرفی، مشابه تجربهای است که برخی توسعهدهندگان در گیتهاب با جهش هزینههای Copilot مواجه شدند و متوجه شدند مدلهای مبتنی بر مصرف میتوانند بهسرعت بودجهها را به چالش بکشند.
تیمهایی که این موضوع را بهخوبی مدیریت میکنند، لزوماً از مدلهای ارزانتر یا پرامپتهای کوتاهتر استفاده نمیکنند. آنها از همان ابتدا با دیدبانی (Visibility) کار میکنند. آنها رشد هزینهها را بهصورت لحظهای میبینند و میدانند کدام عاملها بهخوبی مقیاس میپذیرند و کدامها بد عمل میکنند. آنها بهطور مستمر بهینهسازی میکنند، نه اینکه هنگام رسیدن صورتحساب دچار پانیک شوند. نظارت بهتفکیک عامل، زیربنای کار است؛ هر چیز دیگر — از Caching و انتخاب مدل گرفته تا مهندسی پرامپت و مدیریت زمینه — روی این زیربنا ساخته میشود.
آنچه امروز در دسترس است — دیدبانی بهتفکیک عامل، حافظه پاداش و تفکیک هزینه/توکن برای هر فراخوانی — زیربنایی است که هر تصمیم دیگری را ممکن میکند. مسیریابی مدل (Model Routing) و کوتاه کردن تاریخچه (History Trimming) در نقشه راه هستند اما هنوز فعال نشدهاند. اگر عاملهای AI را در محیط تولید بدون دیدبانی هزینه بهتفکیک عامل اجرا میکنید، در واقع در حال پرواز در تاریکی هستید. این مشکلی است که در پنج دقیقه قابل حل است.
برای تضمین حاشیه سود خود، همین امروز با بررسی نرخ برخورد حافظه (Cache Hit Rate) گرانترین عامل خود شروع کنید. $\rightarrow$ vigil.wtf
گام بعدی شما
- نرخ برخورد حافظه (Cache Hit Rate) گرانترین عامل خود را بررسی کنید.
- پرامپتهای سیستمی را برای حذف دستورالعملهای تکراری بازبینی کنید.
- یک لایه پروکسی برای تفکیک هزینه بهتفکیک عامل (Per-agent attribution) مستقر کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو