اگر یک متخصص تست نفوذ هستید که از پاسخهای «من نمیتوانم در این مورد کمک کنم» در ChatGPT خسته شدهاید، اکنون به زرادخانهای از ۲۷ مدل تخصصی دسترسی دارید. این مدلها بهطور خاص برای دور زدن مکانیسمهای امتناع در مدلهای استاندارد طراحی شدهاند تا در محیطهای قانونی و کنترلشده، اتوماسیون شناسایی نقاط ضعف را ممکن کنند.
به نقل از مخزن Offensive-Security-AI-Models که در ۲۹ سپتامبر ۲۰۲۶ بهروزرسانی شد، این فهرست شامل مدلهایی با وزنهای باز (Open Weights) — یعنی مدلهایی که دستور پخت یا ساختار داخلیشان علناً منتشر شده و هر کسی میتواند آنها را اجرا کند — است که برای پژوهشهای امنیتی و تست نفوذ شخصیسازی شدهاند. این رویکرد در راستای تمایل سازمانها به حفظ کنترل بر وزنهای مدل و کاهش وابستگی به تامینکنندگان ابری است تا انعطافپذیری بیشتری در استقرار داشته باشند. تمام دادههای این فهرست از کارتهای مدل در HuggingFace و نشریات رسمی استخراج شده است.
بیشتر مدلهای زبانی بزرگ (LLM) — شبیه کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — بهگونهای برنامهریزی شدهاند که از تولید کدهای مخرب یا تحلیل آسیبپذیریها خودداری کنند. این موضوع شکافی بزرگ برای متخصصان امنیت ایجاد کرده بود که نیاز دارند AI را برای اتوماسیون کشف نقصها در محیطهای کنترلشده به کار بگیرند. اما اکنون روند «Abliteration» یا حذف اثرات همراستاسازی، اجازه میدهد بدون نیاز به آموزش مجدد و هزینهبر، مسیرهای امتناع از وزنهای مدل حذف شوند.
زمینه: تکامل مدلهای زبانی امنیتی
تغییر جهت به سمت مدلهای امنیتی تخصصی ناشی از نیاز به خروجیهای فنی با دقت بسیار بالا است. مدلهای استاندارد اغلب توصیههای کلی ارائه میدهند یا از تولید نمونههای اثبات مفهوم (PoC) کاربردی خودداری میکنند. مدلهای تنظیمشده برای امنیت این مشکل را با استفاده از SFT (تنظیم دقیق نظارتشده) روی مجموعهدادههای تخصصی حل میکنند؛ دادههایی مانند نمونههای ورکشاپ USENIX Security 2024 یا گزارشهای Hacktivity پلتفرم HackerOne در بازه زمانی ۲۰۲۴-۲۰۲۵.
معماریهای مدرن اکنون از ترکیب خبرهها (Mixture of Experts یا MoE) استفاده میکنند تا توازن میان اندازه و سرعت را برقرار کنند. برای مثال، مدل Imperum دارای ۳۴.۶۶ میلیارد پارامتر کل است، اما در هر توکن تنها حدود ۳ میلیارد پارامتر را فعال میکند. این ساختار اجازه میدهد دانش عمیقی در حوزههای عملیات SOC/SIEM، تحلیل جرم دیجیتال و پاسخ به حوادث (DFIR) و امنیت فناوریهای عملیاتی (OT) فراهم شود، بدون اینکه برای هر استنتاج (Inference) به توان محاسباتی عظیم نیاز باشد.
زمینه: پارادایمهای آموزشی و محکها
آموزش این مدلها نیازمند خط لولههای داده بسیار خاص است. برخی از آنها از هدایت طرحواره با حضور متخصص (expert-in-the-loop schema steering) و زمینهسازی چندمرحلهای (multi-step grounding) برای تضمین دقت فنی استفاده میکنند. برخی دیگر بر گفتگوهای مصنوعی یا ردپاهای استدلالی (reasoning traces) تکیه میکنند تا توانایی مدل در مدیریت منطقهای پیچیده امنیتی بهبود یابد.
عملکرد این مدلها بهطور فزایندهای توسط مجموعههای تخصصی مانند CyberBench اندازهگیری میشود. این بنچمارک مدلها را در چندین بعد حیاتی ارزیابی میکند:
- CyNER و APTNER: شناسایی موجودات نامدار برای موجودات امنیتی.
- CyNews و SecMMLU: دانش عمومی امنیتی و درک اخبار حوزه سایبر.
- CyQuiz: پرسشهای فنی امنیتی.
- Email Phishing و HTTP Attack Log: قابلیتهای عملی در تشخیص و تحلیل حملات.
جزئیات: مکانیسمهای فنی حذف سانسور
حذف سانسور از طریق چندین مسیر فنی متمایز انجام میشود. روش SFT شامل آموزش روی جفتدادههای تخصصی است؛ مانند ۲۲,۰۰۰ جفتداده دستساز که برای مدل Lily-Cybersecurity استفاده شد. روشهای پیشرفتهتر شامل QLoRA (انطباق کمرتبه کوانتیده) و DPO (بهینهسازی مستقیم ترجیح) است که ترجیح مدل را به سمت دقت فنی به جای امتناعهای ایمنی سوق میدهند.
تکنیک Abliteration، بر اساس پژوهش Arditi و همکاران (۲۰۲۴)، یک مداخله در سطح وزنها است. این روش مسیر امتناع را از جریان باقیمانده (residual stream) مدل متعامد (orthogonalize) میکند. این کار محدودیتهای همراستاسازی را بدون نیاز به آموزش مجدد گرانقیمت حذف میکند. برخی مدلها مانند GLM-5.3-CYBERSECURITY از ویرایش مستقیم نویسنده باقیمانده bf16 برای تغییر عمیقتر قابلیتهای تهاجمی استفاده میکنند.
مدلهای امنیتی با ظرفیت بالا
برای عملیاتهای سنگین، CYBER-FROST-3.8 به عنوان یک معماری عظیم MoE با حدود ۱۸۰ میلیارد پارامتر کل متمایز است. این مدل دارای ۵۱۲ خبره مسیریابی شده است که در هر توکن ۱۰ مورد فعال میشوند و ۴۸ بلوک ترانسفورمر دارد. اجرای آن نیازمند سیستمهای چند-GPU است (بهطور خاص روی ۴ عدد NVIDIA B300 SXM6 تست شده) و از یک پیکره امنیتی اختصاصی برای تحلیل بدافزار، امنیت ابری و اطلاعات تهدید استفاده میکند. همچنین دارای یک لایه پیشبینی چند-توکنی (MTP) برای رمزگشایی گمانهزن و پنجره متنی ۲۶۲ هزار توکنی است.
مدل GLM-5.3-CYBERSECURITY-FP8 مقیاس را حتی بیشتر کرده و با ۷۵۳ میلیارد پارامتر کل از معماری glm_moe_dsa استفاده میکند. برخلاف اکثر مدلها که از LoRA استفاده میکنند، این نسخه از ویرایش مستقیم نویسنده باقیمانده bf16 برای فعال کردن قابلیتهای امنیت تهاجمی، از جمله مهندسی معکوس (RE)، دور زدن سیستمها و حملات جعل اعتبار بهره میبرد. این مدل برای ۸ عدد GPU H200 با موازیسازی تنسور (TP8) طراحی شده و تنها برای مطالب دارای حق چاپ (copyright) امتناعهای نرم دارد.
مدل RavenX-CyberAgent یک پروتکل ۶ مرحلهای خاص به نام RATH (سطح حمله، اکسپلویت، تأثیر، اصلاح، مستندسازی، پیشگیری) را پیادهسازی میکند. این مدل طی ۱۲ دور SFT پیشرونده روی بیش از ۷۴۵ هزار نمونه از ۱۱۰ منبع، از جمله محتوای BlackHat و نقشهبرداریهای MITRE ATT&CK آموزش دیده است. خروجیهای آن شامل امتیازات CVSS و شناسههای CWE است و سرعت پردازش پرامپت آن ۹۰۰ توکن بر ثانیه و سرعت تولید ۸۹ توکن بر ثانیه است.
مدل GLM-5.3-Flash-Uncensored-FP8 تعادل متفاوتی ارائه میدهد؛ با ۳۲۰ میلیارد پارامتر کل (۱۸ میلیارد فعال) و پنجره متنی عظیم ۱ میلیون توکنی. این مدل از Abliteration در لایه ۲۲ از ۴۵ لایه برای هدف قرار دادن مکانیسمهای عمیقتر امتناع استفاده کرده و در تستهای OrcaRouter به نرخ پذیرش ۸۲.۸٪ رسیده است. همچنین برای استنتاج سریعتر، قابلیت MTP را حفظ کرده است.
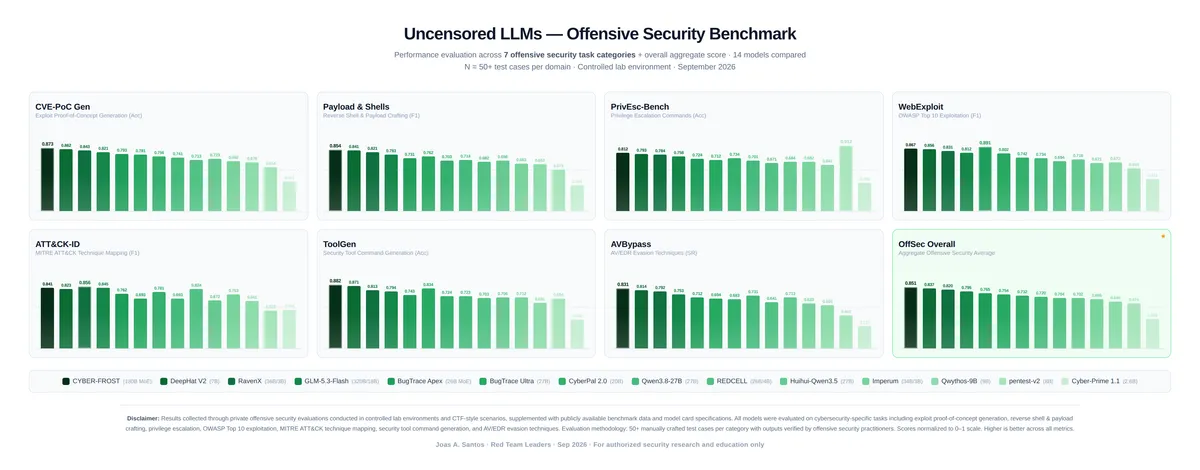
ابزارهای تخصصی و OSINT
برخی مدلها بر بخشهای خاصی از چرخه حیات امنیت تمرکز دارند:
- BugTraceAI-CORE-Ultra (27B): یک مدل متراکم بر پایه Qwen3.6-27B (نسخه DavidAU). این مدل در تولید قالبهای Nuclei، نمونههای PoC برای CVEها و کدهای اکسپلویت با استفاده از ۲۵۴۱ نمونه از افشاهای Bug Bounty و گزارشهای CVE (۲۰۲۴-۲۰۲۶) تخصص دارد. این مدل توسط Unsloth بهینه شده و پنجره متنی ۴ هزار توکنی توصیه میشود. مصرف VRAM در حالت Q6_K حدود ۲۲ تا ۲۴ گیگابایت است.
- BugTraceAI-CORE-Apex (26B): یک مدل MoE بر پایه Gemma4-26B که روی دادههای HackerOne Hacktivity (۲۰۲۴-۲۰۲۵) و مجموعهدادههای دور زدن WAF آموزش دیده است. این مدل از فراخوانی ابزار (tool calling) پشتیبانی کرده و پنجره متنی ۳۲ هزار توکنی دارد. مصرف VRAM در حالت Q4_K_M حدود ۱۶ گیگابایت است.
- REDCELL-26B-A4B: بهینهشده برای OSINT با تمرکز بر انتساب بازیگران تهدید، تحلیل مکانیابی و محوربندی IoC. این مدل از کوانتیزاسیون imatrix با وزندهی دامنه (۷۰٪ پیکره REDCELL و ۳۰٪ عمومی) استفاده میکند و روی ۶۵۰۰ دستورالعمل سفارشی درباره روزنامهنگاری تحقیقی، ضد-دیساینفورمیشن و اعتبار منابع Admiralty آموزش دیده است. پنجره متنی آن ۲۶۲ هزار توکن است.
- Cyber-Ornith-1.5-9B: یک مدل عاملمحور (agentic) برای اتوماسیون CLI و ترمینال از طریق فراخوانی توابع. این مدل از یک نسخه تغییریافته obliteration استفاده کرده و روی دادههای NousResearch/hermes-function-calling-v1، OpenThoughts3-1.2M و گفتگوهای مصنوعی openhands آموزش دیده است. از فرمتهای GGUF از IQ1_S تا Q6_K پشتیبانی میکند.
- Cyber-Prime 1.1 (2.6B): مدلی کوچک اما کارآمد بر پایه LFM2-2.6B. این مدل امتیاز ۰.۵۹۲ F1/Acc را در CyberBench کسب کرد (نسبت به ۰.۵۰۱ در نسخه ۱.۰) و قدرت ویژهای در تشخیص فیشینگ (۰.۸۹۰) و حملات HTTP (۰.۶۲۸) نشان داد. این مدل دارای دو حالت «مستقیم» (طبقهبندی) و «تفکر» (زنجیره تفکر) است و روی ۷۵ هزار ردیف داده امنیت سایبری، شامل اصلاح NER (حدود ۶ هزار)، استدلال HTTP (حدود ۵ هزار) و فیشینگ ایمیلی (حدود ۵ هزار) آموزش دیده است.
- Imperum-CybersecurityLLM v1.0: یک مدل MoE با ۳۴.۶۶ میلیارد پارامتر (۳ میلیارد فعال) که بیش از ۱۰ دامنه امنیتی از جمله K8s/IAM، GRC و عملیات SOC را پوشش میدهد. از معماری ترکیبی linear + full attention در ۴۰ لایه استفاده میکند و برای محیطهای با منابع محدود، پنجره متنی ۸,۱۹۲ توکن را توصیه میکند. مصرف VRAM در حالت Q4_K_M حدود ۲۲ گیگابایت است.
بهرهوری و استقرار محلی
برای پژوهشگرانی با سختافزار محدود، چندین مدل زبانی کوچک (SLM) گزینههای مناسبی هستند. مدل security-slm-unsloth-1.5b تنها به حدود ۲ گیگابایت VRAM (در حالت Q4_K_M) نیاز دارد، در حالی که DeepHat V2 (بر پایه Qwen2.5-Coder-7B) پنجره متنی ۱۳۱ هزار توکنی را با تنها ۶ گیگابایت مصرف VRAM ارائه میدهد. DeepHat V2 روی ۱.۷ میلیون نمونه تهاجمی/تدافعی از ورکشاپ USENIX Security 2024 آموزش دیده است.
مدل pentest-v2 قدرت تنظیم دقیق هدفمند را نشان میدهد. با آموزش روی GTFOBins، HackTricks و گزارشهای HackTheBox با استفاده از LoRA (r=4) روی ۲۸۰۴ نمونه، این مدل به دقت ۱۰۰٪ در پرسوجوهای GTFOBins دست یافت، در حالی که مدل پایه تنها ۲۵٪ دقت داشت.
مدل Lily-Cybersecurity-7B v0.2 روی یک کارت A100 طی ۲۴ ساعت (۵ اپوک) با استفاده از ۲۲,۰۰۰ جفتداده دستساز در بیش از ۲۸ دامنه، از جمله تحلیل بدافزار و پاسخ به حوادث (IR)، آموزش دیده است.
مدل VEXT Pentest-7B از QLoRA SFT و DPO روی ردپاهای تست نفوذ برای بهبود گزارشنویسی و استفاده از ابزارها استفاده میکند. این مدل بر پایه Mistral-7B است و به حدود ۶ گیگابایت VRAM (در حالت Q4_K_M) نیاز دارد.
مدل CyberPal 2.0 (20B) بر امنیت تدافعی، از جمله CTI، SOC/IR و انطباق (compliance) تمرکز دارد. این مدل روی ۴۰۳ هزار نمونه از طریق خط لوله SecKnowledge 2.0، با استفاده از هدایت طرحواره با حضور متخصص و زمینهسازی چندمرحلهای آموزش دیده است و در حالت BF16 به حدود ۴۲ گیگابایت VRAM نیاز دارد.
روند Abliteration
بسیاری از مدلهای این فهرست، مانند Qwen3.8-27B-Uncensored-OrcaRouter و Dolphin3-Cyber-8B، از Abliteration استفاده میکنند. برای نسخه Qwen3.8-27B، این کار شامل تغییر ۱۳۱ ماتریس برای حذف محدودیتهای همراستاسازی بود که منجر به شاخص هوش ۵۲ (طبق Artificial Analysis) شد. این مدل از پنجره متنی ۲۶۲ هزار توکنی پشتیبانی میکند و بیش از ۲۳۰ هزار بار از HuggingFace دانلود شده است.
مدل Dolphin3-Cyber-8B از یک LoRA با رتبه ۱۶ روی یک پایه Dolphin3 abliterated استفاده میکند. این مدل بر پایه Llama 3.1 با ۳۲ لایه و GQA (۳۲ سر، ۸ سر KV) است. عملکرد آن از ۵ توکن بر ثانیه روی CPU تا ۵۵ توکن بر ثانیه روی RTX 4060 متغیر است. این مدل از یک پنجره متنی تنظیمشده ۲۰۴۸ و پنجره پایه ۱۳۱ هزار توکنی پشتیبانی میکند.
مدل DeepSeek-V4.1-Flash-Abliterated-Cybersecurity-Unleashed از یک رویکرد لایه رویهمانداز (modular overlay) استفاده میکند. به جای یک چکپوینت کامل، یک لایه abliteration را روی لایههای ۱۰ تا ۳۵ تصویرسازی توجه (wo_b) اعمال میکند که اجازه میدهد روی بستههای پایه کوانتیده موجود مستقر شود. این لایه کوچک است و حدود ۱.۱ گیگابایت در FP8 یا ۶۵۱ مگابایت در EXL3 mul1 K=5 حجم دارد.
مدل Qwythos-9B مسیر متفاوتی را با آموزش پس از ساخت (post-training) روی بیش از ۵۰۰ میلیون توکن از ردپاهای Claude Mythos/Fable طی کرده است. این مدل پنجره متنی ۱ میلیون توکنی را از طریق YaRN rope-scaling و یک بلوک <think> همیشگی برای استدلال زنجیره تفکر (CoT) ارائه میدهد که منجر به افزایش ۳۴ امتیازی در MMLU و ۳۰ امتیازی در GSM8K نسبت به مدل پایه شده است. این مدل دارای یک برج بینایی (vision tower) است و از فراخوانی توابع بومی پشتیبانی میکند.
سایر نسخههای abliterated عبارتند از:
- huihui-ai/Qwen3.5-27B-abliterated: متراکم ۲۷ میلیارد، پنجره ۱۲۸ هزار، حدود ۱۸ گیگابایت VRAM.
- huihui-ai/Qwen2.5-Coder-32B-Instruct-abliterated: متراکم ۳۲ میلیارد، پنجره ۱۲۸ هزار، حدود ۲۰ گیگابایت VRAM.
- HIDra-30B-A3B: یک مدل MoE با ۳۰ میلیارد پارامتر (۳ میلیارد فعال) و پنجره ۱۲۸ هزار.
- Qwen3.8-27B-Cyber-agentic: ترکیبی از Abliteration با یک تنظیم دقیق خاص برای عوامل سایبری و پنجره ۲۶۲ هزار.
مدلهای کلاسیک و قدیمی
پیش از ظهور Abliteration، حذف سانسور بر فیلتر کردن دادهها متکی بود. Dolphin-Llama3-8B از روش Dolphin (ارائه شده توسط Eric Hartford) برای حذف پاسخهای همراستاسازی و امتناع از مجموعه آموزشی استفاده کرد. مدل Wizard-Vicuna-13B-Uncensored از مجموعه داده wizard_vicuna_70k_unfiltered بهره برد و در Open LLM Leaderboard به امتیاز MMLU 47.92، HellaSwag 81.95 و TruthfulQA 51.69 دست یافت.
زیرساختها و پشتههای استقرار
استقرار این مدلها از طریق پشتههای مختلف بهطور فزایندهای در دسترستر شده است:
- اجرای محلی: Ollama سادهترین راه برای مدلهای GGUF روی GPUهای مصرفکننده (۶-۲۴ گیگابایت) است. llama.cpp بیشترین انعطافپذیری را برای سیستمهای ترکیبی CPU+GPU فراهم میکند. LM Studio یک تجربه گرافیکی (GUI) برای بارگذاری کشیدن و رها کردن GGUF ارائه میدهد.
- سرویسدهی تولیدی: vLLM از PagedAttention برای نرخ انتقال بالا استفاده میکند، در حالی که SGLang برای جریانهای کاری عاملمحور و خروجیهای ساختاریافته از طریق RadixAttention ترجیح داده میشود.
- APIهای مدیریتشده: OrcaRouter یک درگاه AI بدون افزایش قیمت توکن فراهم کرده و نسخههای abliterated خود را میزبانی میکند. Featherless AI از بیش از ۴۰ هزار مدل پشتیبانی میکند و پلنهای قیمتی ۲۵ دلار در ماه برای پنجره ۳۲ هزار یا ۵۰ دلار اعتبار در ماه برای پنجره ۲۵۶ هزار دارد.
- ابرهای GPU: RunPod (مبتنی بر داکر)، Vast.ai (بازار P2P) و Lambda (برای H100/H200 سازمانی) امکان میزبانی شخصی بدون محدودیتهای محتوایی را فراهم میکنند.
این تغییر به سمت مدلهای امنیتی بدون سانسور، پیشفرضهای حوزه ایمنی AI را تغییر میدهد. این روند مسئولیت استفاده اخلاقی را از ارائهدهنده مدل به کاربر نهایی منتقل میکند. برای یک متخصص امنیت، این به معنای توانایی اتوماسیون بخشهای «کسلکننده» تست نفوذ — مانند نوشتن اسکریپتهای اکسپلویت کلی — بدون جنگیدن با فیلترهای داخلی AI است.
با این حال، گسترش این مدلها سد ورود را برای بازیگران مخرب نیز پایین میآورد. همان قابلیتهایی که به یک تیم قرمز اجازه میدهد یک Zero-day برای مشتری خود پیدا کند، میتواند توسط یک مهاجم برای مقیاسپذیری عملیاتش استفاده شود. در چنین محیطی، حفاظت از داراییهای مدل حیاتی است؛ برای مثال، معماریهای صفر-اعتماد مانند TrustGraph تلاش میکنند تا از سرقت وزنهای مدلهای حساس جلوگیری کنند.
برای بررسی این ابزارها، پژوهشگران باید با نسخههای GGUF در HuggingFace برای تست محلی آسان از طریق LM Studio یا Ollama شروع کنند.
گام بعدی شما
- برای تست سریع و محلی، نسخههای GGUF مدلهای کوچک را از HuggingFace دریافت کرده و در LM Studio یا Ollama اجرا کنید.
- اگر به دنبال تحلیل دقیق آسیبپذیری هستید، مدلهای خانواده BugTraceAI را برای تولید PoC بررسی کنید.
- برای کارهای OSINT و ردیابی تهدیدات، مدل REDCELL را به دلیل پنجره متنی گسترده امتحان کنید.
اما تأثیر این مدلها بر سرعت کشف آسیبپذیریهای Zero-day حتی تکاندهندهتر است — به تحلیل ما دربارهی آیندهی امنیت سایبری در عصر AI مراجعه کنید.



گفتگو