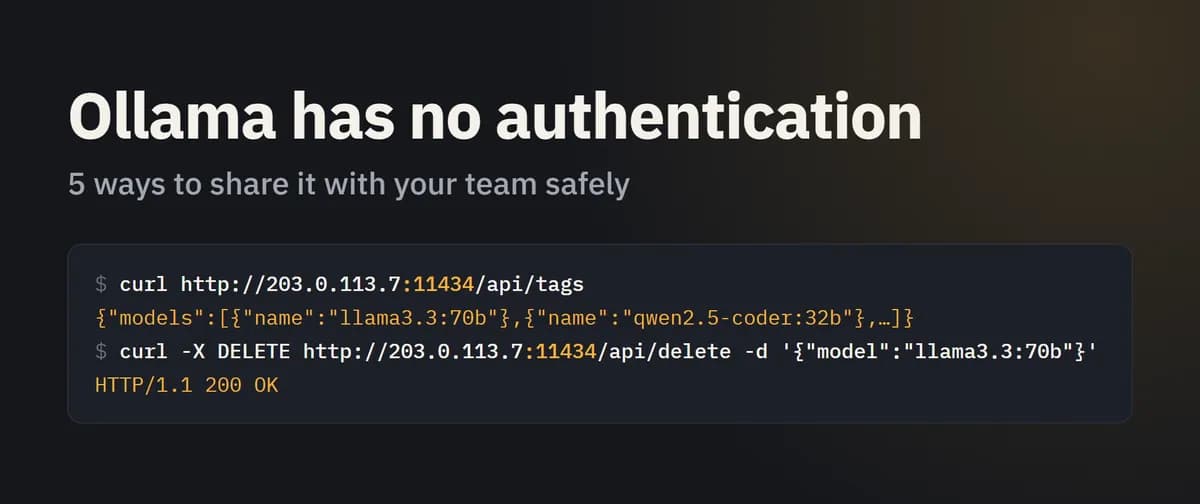
اگر امروز یک سرور اولاما (Ollama) را برای استفادهٔ تیم خود فعال کردهاید، احتمالاً یک حفرهٔ امنیتی عظیم را در شبکه باز گذاشتهاید. این ابزار بهصورت پیشفرض هیچ کلید API یا سیستم احراز هویتی ندارد و به هر کسی که بتواند به پورت آن متصل شود، پاسخ میدهد. در حالت عادی، اولاما روی 127.0.0.1:11434 گوش میدهد و فقط به درخواستهای محلی پاسخ میدهد.
مشکل زمانی شروع میشود که مدیر سیستم برای دسترسی همکاران، متغیر OLLAMA_HOST=0.0.0.0 را تنظیم میکند تا مثلاً یک همکار بتواند از روی یک ماشین دیگر به باکس GPU که زیر میز قرار دارد دسترسی داشته باشد؛ از این لحظه، تمام نقاط اتصال (Endpoints) برای هر کسی که به شبکه دسترسی داشته باشد باز است. این دسترسی فقط شامل چت کردن نیست، بلکه هر کسی میتواند مدلها را Pull کند، آنها را حذف کند، مدل جدید بسازد یا مدلهای موجود را به مخازن (Registry) خارجی Push کند.
این آسیبپذیری صرفاً تئوری نیست. به گزارش شرکتهای SentinelOne و Censys در ژانویه ۲۰۲۶، حدود ۱۷۵,۰۰۰ سرور اولاما در ۱۳۰ کشور بهصورت باز در اینترنت شناسایی شدند. این وضعیت یادآور گزارش اخیر ما درباره سرورهای MCP است که در آن مشخص شد اکثریت قریب به اتفاق این زیرساختها نیز فاقد هرگونه احراز هویت هستند. طبق این گزارش، تقریباً نیمی (۴۸٪) از این سرورهای در معرض خطر، مدلهایی با قابلیت «فراخوانی ابزار» (Tool-calling) فعال داشتند که سطح حمله را بهشدت افزایش میدهد و به مهاجم اجازه میدهد از طریق مدل، دستورات سیستمی اجرا کند.
اوج این بحران در مه ۲۰۲۶ با کشف آسیبپذیری «Bleeding Llama» (CVE-2026-7482) توسط شرکت Cyera رخ داد. این اکسپلویت به مهاجم اجازه میدهد تنها با دو درخواست ساده و بدون نیاز به احراز هویت، حافظهٔ سرور — شامل متغیرهای محیطی، کلیدهای API و پرامپتهای کاربران دیگر — را استخراج کند. مکانیسم حمله به این صورت است: ابتدا یک درخواست به /api/create با یک فایل GGUF دستکاری شده ارسال میشود و سپس با یک درخواست به /api/push به رجیستری مهاجم، دادهها نشت میکنند. اگرچه اصلاحیهٔ این مشکل در نسخه ۰.۱۷.۱ در فوریه منتشر شد، اما بسیاری از مدیران بهدلیل نبود برچسب صریح «وصله امنیتی» در یادداشتهای انتشار، آن را نادیده گرفتند.
همانطور که در بحثهای گذشتهی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، میزبانی شخصی همواره با چالش مدیریت دسترسی همراه است. تا نسخه ۰.۴۰.۳ در اکتبر ۲۰۲۶، اولاما همچنان احراز هویت سمت سرور را ارائه نمیدهد. در سال ۲۰۲۵، یکی از توسعهدهندگان این پروژه در پاسخ به یک Pull Request صراحتاً اعلام کرد که برنامهای برای افزودن سیستم کلید API به خودِ سرور در کوتاهمدت ندارند و استفاده از VPNهایی مثل Tailscale را توصیه میکنند. باید بدانید متغیر OLLAMA_AUTH فقط باعث میشود کلاینت اولاما درخواستهای ارسالی را امضا کند؛ این متغیر هیچ حفاظتی برای سرور ایجاد نمیکند. برای ایمن کردن محیط خود، باید یک لایه حفاظتی در جلوی API قرار دهید.
بررسیهای سریع امنیتی
برای اینکه بفهمید سرور شما در معرض خطر است، از یک دستگاه خارج از شبکه دستور curl -s --max-time 5 http://YOUR_PUBLIC_IP:11434/api/tags را اجرا کنید. اگر لیستی از مدلها چاپ شد، یعنی هر کسی میتواند از آنها استفاده کند. همچنین با دستور ollama -v نسخه خود را چک کنید؛ هر نسخهای قدیمیتر از ۰.۱۷.۱ باید فوراً بهروزرسانی شود، فارغ از اینکه چه استراتژی امنیتی دیگری را انتخاب کردهاید.
در مورد داکر (Docker) بسیار محتاط باشید. استفاده از -p 11434:11434 باعث میشود سرور روی تمام رابطها گوش دهد. چون داکر قوانین iptables خودش را مینویسد، یک قانون ufw که پورت ۱۱۴۳۴ را میبندد، عملاً اثر نخواهد داشت و داکر آن را دور میزند. راه درست این است که از -p 127.0.0.1:11434:11434 استفاده کنید، یا اگر فقط کانتینرهای دیگر نیاز به دسترسی دارند، اصلاً پورت را منتشر نکنید.
گزینه ۱: تونلهای SSH و Tailscale
برای تیمهای بسیار کوچک، سادهترین راه این است که اولاما را روی localhost نگه دارید و از یک کانال رمزنگاریشده استفاده کنید. یک تونل SSH با دستور ssh -N -L 11434:localhost:11434 you@gpu-box به کاربر اجازه میدهد طوری از http://localhost:11434 استفاده کند که انگار اولاما روی دستگاه خودش نصب شده است.
برای تیمهای بزرگتر، Tailscale — که شبیه به یک شبکه خصوصی مجازی است که تمام دستگاههای شما را در یک اتاق امن جمع میکند — توصیه میشود و همان روشی است که توسعهدهندگان اولاما پیشنهاد دادهاند. برای این کار:
- اولاما را طوری تنظیم کنید که روی تمام رابطها گوش دهد. این کار را از طریق
sudo systemctl edit ollamaو افزودن عبارت[Service] Environment="OLLAMA_HOST=0.0.0.0:11434"انجام دهید. - دیوار آتش (Firewall) را طوری تنظیم کنید که پورت ۱۱۴۳۴ را فقط از شبکه tailnet بپذیرد:
sudo ufw allow in on tailscale0 to any port 11434 proto tcp.
با فعال بودن ufw و تنظیم پیشفرض آن برای رد کردن ترافیک ورودی، هیچ درخواست دیگری وارد نمیشود. سپس ACLهای تایلاسکیل تصمیم میگیرند کدام افراد یا دستگاههای خاص بتوانند به باکس دسترسی داشته باشند.
نقطه ضعف: هر کسی که وارد این شبکه شود، دسترسی کامل به API دارد و میتواند مدلها را حذف کند. از نظر اولاما، تمام درخواستها یکسان هستند، بنابراین نمیتوانید ردیابی کنید چه کسی از GPU استفاده میکند یا چه مقدار مصرف کرده است. همچنین نمیتوانید دسترسی یک اسکریپت خاص را بدون قطع دسترسی کل کاربر لغو کنید. علاوه بر این، هر کاربر باید Tailscale را نصب کند، به این معنی که ابزارهای ابری (مثل n8n میزبانی شده) نمیتوانند به راحتی به آن متصل شوند.
گزینه ۲: پروکسیهای معکوس توکنمحور
اگر تیم شما به یک آدرس HTTPS استاندارد نیاز دارد، پروکسیهایی مثل Caddy میتوانند بررسی توکن را اجباری کنند. Caddy گواهینامههای SSL را بهطور خودکار مدیریت میکند. یک پیکربندی امن به این شکل خواهد بود:
ollama.example.com {
  @no_token not header Authorization "Bearer {$OLLAMA_TOKEN}"
  respond @no_token 401

  @model_admin {
    path /api/create /api/push /api/pull
    path /api/delete /api/copy /api/blobs/*
  }
  respond @model_admin 403

  reverse_proxy localhost:11434 {
    header_up Host {upstream_hostport}
  }
}
Caddy را با یک OLLAMA_TOKEN تصادفی و طولانی در محیط (Environment) اجرا کنید. خط header_up Host بسیار حیاتی است؛ زیرا اولامایی که روی localhost گوش میدهد، درخواستهایی که برای نام میزبان (Host name) دیگری ارسال شده باشند را رد میکند. بدون این خط، اولاما به هر درخواستی که با یک دامنه واقعی بیاید، خطای ۴۰۳ میدهد.
کلاینتهای سازگار با OpenAI مثل Continue، Cursor، n8n و SDKهای OpenAI میتوانند از این توکن بهعنوان API Key خود با آدرس پایه https://ollama.example.com/v1 استفاده کنند. بستن نقاط اتصال مدیریت مدل (مثل /api/delete یا /api/push) در این روش حیاتی است، زیرا دقیقاً همین نقاط برای اجرای حمله Bleeding Llama استفاده میشوند.
نقطه ضعف: شما یک توکن مشترک برای همه دارید. اگر کسی از تیم جدا شود، باید توکن را در تمام دستگاهها تغییر دهید. شما هنوز نمیتوانید ببینید چه کسی چه درخواستی فرستاده است. اگرچه میتوانید در nginx یا Caddy نقشههای متعددی بسازید تا به هر شخص توکن جدا بدهید، اما در واقع دارید یک Gateway شخصی را در یک فایل کانفیگ مینویسید.
گزینه ۳: Open WebUI بهعنوان دروازه
بسیاری از تیمها از Open WebUI بهعنوان رابط کاربری اصلی استفاده میکنند. با خصوصی نگه داشتن اولاما و هدایت تمام ترافیک از طریق Open WebUI، شما به سیستمهای SSO و حسابهای کاربری مجزا دسترسی پیدا میکنید.
برای فعالسازی دسترسی API:
- مدیران باید کلیدها را در مسیر Admin Settings → Authentication → API Keys فعال کنند.
- کاربران غیرمدیر باید دسترسی API Keys permission را داشته باشند.
- سپس کاربران کلید شخصی خود را در Settings → Account میسازند.
این کلیدها با نقاط اتصال /api/chat/completions (سبک OpenAI) و /ollama/api/* که به اولاما پاس داده میشوند، کار میکنند.
نقطه ضعف: یک کلید تمام دسترسیهای سازندهاش را به ارث میبرد. اگرچه محدودیتهای Endpoint وجود دارد، اما این محدودیتها برای کل نمونه (Instance) اعمال میشوند، نه برای هر کلید بهطور جداگانه. در مستندات اشارهای به محدودیت هزینه یا نرخ درخواست (Rate Limit) برای هر کلید نشده است، به این معنی که یک عامل (Agent) که در حلقه افتاده باشد، میتواند تمام توان GPU را در تمام روز اشغال کند. این ریسک دقیقاً همان چیزی است که در بررسی ما درباره دسترسیهای بیش از حد عاملهای هوش مصنوعی و تبدیل آنها به حفرههای امنیتی به آن پرداختیم.
گزینه ۴: پروکسیهای تخصصی (LoLLMs Hub و LiteLLM)
برای مدیریت چندین سرور GPU، ابزار LoLLMs Hub (ساخته ParisNeo، که در ابتدا ollama_proxy_server بود و در README اولاما با نام "Ollama Fortress" ذکر شده) لایهای مدیریتی قدرمند فراهم میکند. این ابزار تحت لایسنس Apache-2.0 است و امکانات زیر را دارد:
- کلیدهای مجزا برای هر کاربر و محدودیت نرخ درخواست (Rate Limit).
- آمار دقیق مصرف برای یک یا چندین سرور اولاما.
- توزیع بار (Load Balancing) بین چندین ماشین GPU.
- یک صفحه مدیریت برای Pull و Delete کردن مدلها.
بهطور جایگزین، LiteLLM پروکسی قدرتمندی است که از کلیدهای مجازی با بودجههای سختگیرانه و محدودیت نرخ درخواست پشتیبانی میکند. این ابزار میتواند با اولاما و تقریباً ۱۰۰ ارائهدهنده ابری ارتباط برقرار کند. اما این گزینه به یک پایگاهداده Postgres برای مدیریت وضعیت نیاز دارد و نگهداری آن فعالتر است.
نقطه ضعف: هر دو گزینه باعث اضافه شدن یک سرویس دیگر برای اجرا و بهروزرسانی میشوند. بهویژه LiteLLM به دلیل نیاز به دیتابیس، پیچیدگی معماری را افزایش میدهد.
گزینه ۵: Spillway برای تیمهای کوچک و متوسط
Spillway یک جایگزین متنباز (تحت لایسنس AGPL-3.0) برای شرکتهای ۱۰ تا ۵۰ نفره است که یک سرور GPU دارند، برای مدلهای Claude یا OpenAI هزینه پرداخت میکنند و مهندس زیرساخت اختصاصی ندارند. این ابزار در یک کانتینر واحد با SQLite و یک صفحه مدیریت اجرا میشود. نصب آن بسیار ساده است:
mkdir spillway && cd spillway
curl -fsSLO https://raw.githubusercontent.com/Artemy-And/spillway/main/docker-compose.yml
echo "OLLAMA_URL=http://ollama:11434" >> .env
docker compose --profile ollama up -d
docker compose logs spillway
کانتینر اولاما در این فایل compose هیچ پورتی را منتشر نمیکند، بنابراین فقط Spillway میتواند به آن دسترسی داشته باشد. Spillway از فرمت بومی اولاما (/api/chat, /api/generate, /api/embed, /api/tags) و همچنین فرمتهای OpenAI و Anthropic پشتیبانی میکند. این ابزار بهطور کامل دسترسی به /api/create، /api/push و /api/delete را مسدود میکند.
ویژگیهای کلیدی Spillway عبارتند از:
- بودجهبندی: تعریف کلیدهای مجزا با سقف دلاری روزانه و ماهانه برای مدلهای ابری.
- حفاظت از GPU: قوانینی که تعداد درخواستهای کلیدهای Agent را در هر دقیقه محدود میکند تا سرور کرش نکند.
- حریم خصوصی: یک لاگ درخواست که شماره کارتها و دادههای شخصی را ماسک میکند. این ابزار میتواند پرامپتهای حاوی دادههای حساس را برای مدلهای ابری مسدود کند، در حالی که اجازه میدهد مدلهای محلی به آنها پاسخ دهند.
- جایگزینی خودکار (Failover): اگر یک ارائهدهنده ابری قطع شود یا بودجه تمام شود، درخواستها بهطور خودکار به مدل محلی اولاما هدایت میشوند.
نقطه ضعف: این پروژه هنوز جوان است (نسخه ۰.۴) و توسط یک توسعهدهنده مدیریت میشود. لایسنس AGPL-3.0 ممکن است در برخی شرکتها محدودیت ایجاد کند. همچنین این ابزار قابلیت توزیع بار بین چندین ماشین GPU را ندارد.
استراتژی انتخاب
| استراتژی | دسترسی هر فرد | محدودیت هر کلید | زمان راهاندازی |
|---|---|---|---|
| SSH / Tailscale | بر اساس دستگاه | ندارد | چند دقیقه |
| Token Proxy | یک توکن مشترک | ندارد | یک ساعت |
| Open WebUI | بله | ندارد | چند دقیقه (اگر نصب باشد) |
| LoLLMs Hub | بله | نرخ درخواست | یک شب |
| LiteLLM | بله | بودجه و نرخ | یک شب + Postgres |
| Spillway | بله | دلار و نرخ | چند دقیقه |
یک قانون کلی: برای دو یا سه نفر که به هم اعتماد دارند، از Tailscale استفاده کنید. برای افرادی که به آدرس HTTPS و اسکریپت نیاز دارند، از یک پروکسی با نقاط اتصال مدیریت بسته استفاده کنید. برای تیمهای بزرگتر یا ترکیبی از مدلهای محلی و ابری، از سیستمی با کلیدهای شخصی استفاده کنید. فارغ از ابزار انتخابی، مطمئن شوید که روی نسخه ۰.۱۷.۱ یا بالاتر هستید و پورت ۱۱۴۳۴ در معرض اینترنت نیست.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو