اگر تصور میکنید عاملهای هوش مصنوعی صرفاً موتورهای جستوجوی سریعتر هستند، نتایج جدید آزمایشگاه AllSpark این باور را به چالش میکشد. این مدلها ثابت کردند که جستوجوی وب میتواند از یک ابزار بازیابی ساده به یک مهارت استدلالی بنیادی تبدیل شود. این رویکرد تفاوتهای بنیادینی با روشهای سنتی دارد، همانطور که در مقایسهی عاملهای هوش مصنوعی با موتورهای جستوجوی سنتی در پردازش الگوها مشاهده شد.
به نقل از مستندات منتشر شده در ۱۳ سپتامبر ۲۰۲۶، مدلهای Iris-mini و Iris-pro در حال حاضر پیشتاز کلاسهای وزنی خود در محکهای استدلال پیچیده وب هستند. این دستاورد نشان میدهد که آموزش تخصصی برای جستوجو میتواند منجر به بهبود تواناییهای استدلالی کلی در وظایف اداری نامرتبط شود.
بسیاری از عاملهای فعلی بر بازیابی ساده متکی هستند، اما AllSpark استدلال میکند که یک «عامل» واقعی باید بتواند سرنخهای غیرمستقیم متعدد را به هم زنجیر کند. این تغییر، هدف را از «یافتن یک سند» به «حل یک معما» با استفاده از وب بهعنوان یک پایگاهداده تغییر میدهد. برای متخصصان فنی، این یک حرکت به سمت تفکر سیستم ۲ (System 2 thinking) برای عاملهای وب خودمختار است.
همانطور که در تحلیلهای پیشین ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، دسترسی به وزنها برای بازبینی سازوکارهای استدلال حیاتی است.
معماری فنی و آموزش
مدل Iris-mini با ۳۵ میلیارد پارامتر و Iris-pro با ۳۹۷ میلیارد پارامتر، بر پایه سری Qwen (بهطور مشخص نسخههای Qwen3.6-35B-A3B و Qwen3.5-397B-A17B) ساخته شدهاند. هر دو مدل دارای پنجرهٔ زمینه (Context Window) ۲۵۶,۰۰۰ توکنی هستند. تیم توسعه از یک فرآیند منحصربهفرد به نام «صعود SFT-RL» استفاده کرده است که در آن تنظیم نظارتشده (SFT) و یادگیری تقویتی (RL) بهصورت متناوب روی جستوجوی زنده وب اجرا میشوند. در این چرخه، کارآمدترین مسیرهای حل مسئله و سختترین وظایفی که در هر دور حل شدهاند، به عنوان ورودی به چرخه آموزشی بعدی بازمیگردند.
برای جلوگیری از اتکای مدل به تطبیق ساده کلمات کلیدی، AllSpark سؤالات آموزشی را از ساختار لینکهای وب مهندسی معکوس کرد. این خط لوله ابتدا گرافی از اصطلاحات و روابط را از یک صفحه بذر و لینکهای خروجی آن میسازد. سپس سؤالاتی چندمرحلهای تولید میکند که نیازمند زنجیره کردن گامهای متصل است. در این مسیر، هر اصطلاح میانی با یک عبارت جایگزین (Paraphrase) عوض میشود تا هیچ سرنخی از طریق جستوجوی متنی ساده قابل حل نباشد. این سازوکار مدل را مجبور میکند تا به جای انجام یک جستوجوی متنی مستقیم، از طریق زنجیره شواهد استدلال کند.
فیلتر دادهها و اعتبارسنجی
طبق گزارش AllSpark، برای تضمین کیفیت آموزش، یک فرآیند فیلترینگ دو مرحلهای سختگیرانه اجرا شده است:
- تولید توسط معلم: یک مدل قدرتمند (Teacher Model)، مسیرهای حل مسئله شامل استدلالها، پرسوجوهای جستوجو و نتایج بهدستآمده را تولید میکند.
- فیلتر اول: کل مسیر از نظر صحت پاسخ، عمق جستوجو و وجود حلقههای تکراری بررسی میشود.
- فیلتر دوم: یک مدل داور، بازبینی گامبهگام را بر اساس معیارهای استخراجشده از خودِ دادهها (و نه قوانین دستی از پیش تعیین شده) انجام میدهد.
تنها سؤالاتی وارد مجموعه آموزشی میشوند که یک مدل مرجع بدون دسترسی به ابزارها قادر به حل آنها نیست، اما با دسترسی به منابع درست میتواند پاسخ دهد. برای حفظ استقلال از سرویسهای خارجی، مدل داور و سیستمهای خلاصهساز نتایج، درون خوشه (Cluster) آموزشی و توسط مدل بزرگ Qwen خود تیم اجرا میشوند.
عملکرد در محکها
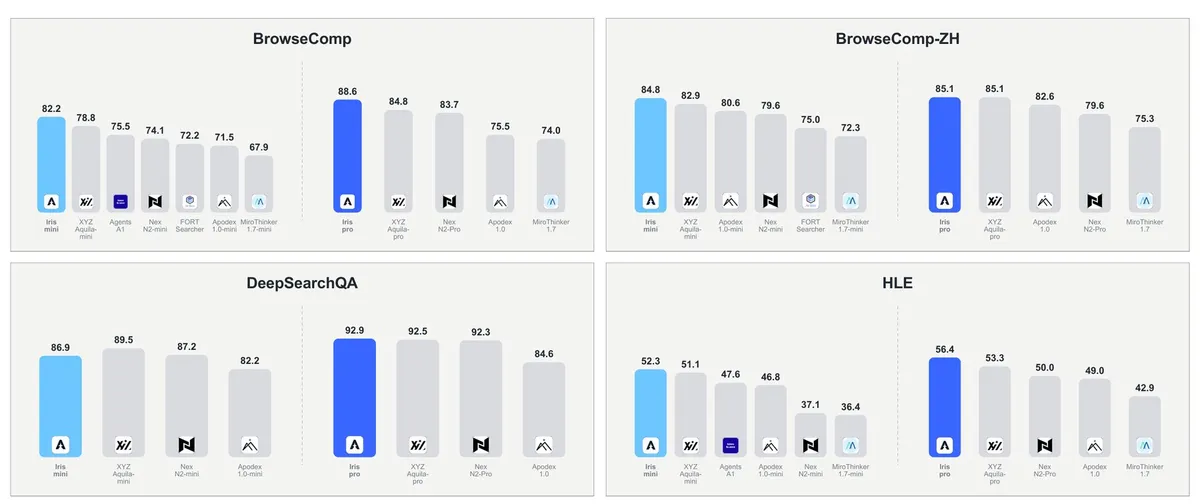
بر اساس مقاله AllSpark، این مدلها در چهار محک اصلی مورد آزمایش قرار گرفتند. امتیازات Iris حاصل عملکرد یک تکعامل بدون کمک گرفتن از عاملهای کمکی یا گامهای اعتبارسنجی اضافی است:
- BrowseComp: یافتن حقایق نادر از سرنخهای غیرمستقیم. Iris-mini امتیاز ۸۲.۲ و Iris-pro امتیاز ۸۸.۶ را کسب کردند.
- BrowseComp-ZH: نسخه چینی محک فوق. Iris-mini امتیاز ۸۴.۸ و Iris-pro امتیاز ۸۵.۱ را گرفتند.
- DeepSearchQA: ارزیابی کامل بودن شواهد. Iris-mini امتیاز ۸۶.۹ و Iris-pro امتیاز ۹۲.۹ را ثبت کردند.
- Humanity's Last Exam: سؤالات آکادمیک سطح خبره. Iris-mini امتیاز ۵۲.۳ و Iris-pro امتیاز ۵۶.۴ را کسب کردند.
در کلاس مدلهای کوچکتر، Iris-mini در سه محک از چهار محک پیشتاز است و در BrowseComp با ۳.۴ امتیاز از رقیب بعدی یعنی XYZ-Aquila-mini جلو زده است، هرچند در DeepSearchQA عقبتر است. Iris-pro نیز در کلاس مدلهای بزرگ، در اکثر موارد پیشتاز است یا با سیستمهایی که محاسبات (Compute) بسیار بیشتری میطلبند، برابری میکند. این نتایج در کنار بررسی سرویسهای پیشرو در ارزیابی کیفیت و کارایی جستوجوی هوش مصنوعی، استانداردهای جدیدی را برای سنجش دقت مدلهای جستوجو تعریف میکند.
شکاف مدیریت زمینه
AllSpark به یک نقطه کور صنعتی اشاره میکند: مدیریت زمینه در زمان اجرا (Runtime Context Management). آنها استدلال میکنند که استراتژیهای مدیریت، تأثیری بیشتر از تفاوتهای ذاتی سیستمها دارند. برای جداسازی این اثر، تیم محکها را با و بدون مدیریت زمینه آزمایش کرد، در حالی که ابزارها، محدودیتهای زمینه و مدل داور را ثابت نگه داشت.
یافتهها نشان داد که عملکرد Iris-mini در BrowseComp هنگام استفاده از استراتژیهای «حذف تاریخچه»، تا ۲۱.۲ امتیاز جهش میکند. این موضوع به دلیل بودجه توکن نیست، بلکه به دلیل مصرف سریعتر است؛ Iris-mini برای وظایف مشابه به گامهای بیشتری نیاز دارد و زودتر به سقف پنجره زمینه میرسد. در محک Humanity's Last Exam، این بهبود کمتر بود زیرا آن آزمون بیشتر بر دانش دامنه و استدلال آکادمیک متکی است تا جستوجوی وب.
برای حل این مشکل، مکانیزم «تلاش دوم» پیاده شد. اگر جستوجوی اول شکست بخورد، سیستم تلاش ناموفق را در یک یادداشت کوتاه از منابع ردشده خلاصه کرده و به اجرای بعدی اضافه میکند تا از تکرار جستوجوهای قبلی جلوگیری شود.
تحلیل: جستوجو بهعنوان یک مهارت بنیادی
این انتشار، این فرض را که عاملهای جستوجو متخصصانی محدود هستند، به چالش میکشد. AllSpark گزارش میدهد که مدلهای Iris در استفاده کلی از ابزارها و کارهای اداری بهبود یافتهاند، در حالی که هرگز برای این وظایف آموزش ندیدهاند. این نشان میدهد توانایی مدیریت اطلاعات ناقص — که هسته جستوجوی وب است — در واقع یک مهارت استدلالی بنیادی است که به سایر گردشکارهای عاملمحور منتقل میشود.
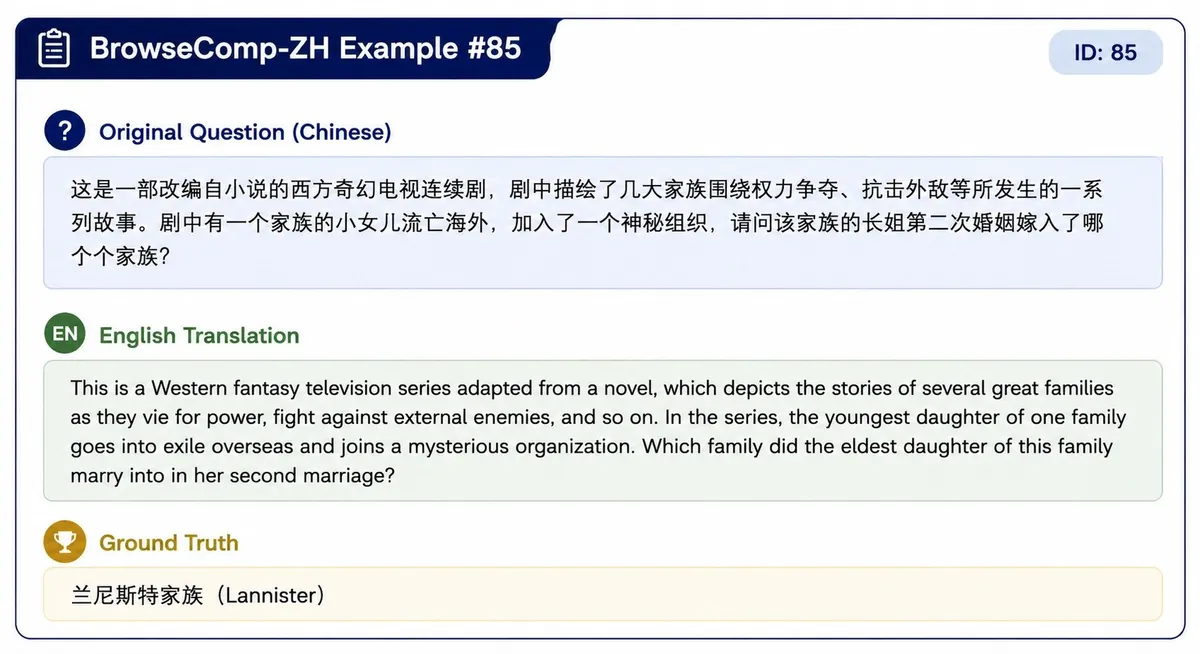
علاوه بر این، کشف خطاهای «داده مرجع» (Ground Truth) در محکها، نیاز به ارزیابیهای بهتر را نشان میدهد. در یک مورد از BrowseComp-ZH درباره «بازی تاج و تخت»، عامل بهدرستی پاسخ «بولتون» را داد (اشاره به دومین ازدواج سانسا استارک با رمزی بولتون)، اما چون داده مرجع «لنیستر» را ثبت کرده بود، پاسخ مدل غلط علامت زده شد.
AllSpark وزنهای مدل را در Hugging Face و کدها را در GitHub منتشر کرده است. این مجموعه شامل Iris Harness برای نقاط انتهایی سازگار با OpenAI است که حلقه عامل، ابزارها، استراتژیهای مدیریت زمینه و هر چهار محک را در بر میگیرد. تیم توسعه قصد دارد خط لولههای ساخت داده و آموزش را در آینده منتشر کند.
گام بعدی شما
- اگر توسعهدهنده عامل هستید، Iris Harness را از گیتهاب دریافت کنید تا استراتژیهای مدیریت زمینه (Context Management) را روی مدلهای خود تست کنید.
- در پیادهسازیهای خود، مکانیزم «خلاصه شکستها» را برای جلوگیری از تکرار جستوجوهای ناموفق جایگزین پاکسازی کامل تاریخچه کنید.
اما تأثیر این مدلها بر کاهش هزینههای استنتاج در مقیاس سازمانی موضوع دیگری است — به تحلیل ما درباره بهینهسازیهای جدید در مدلهای Qwen مراجعه کنید، یا برای درک بهتر اقتصاد این سیستمها، گزارش Mixedbread درباره کاهش ۱۰ برابری هزینه عاملهای جستوجو را مطالعه کنید.



گفتگو