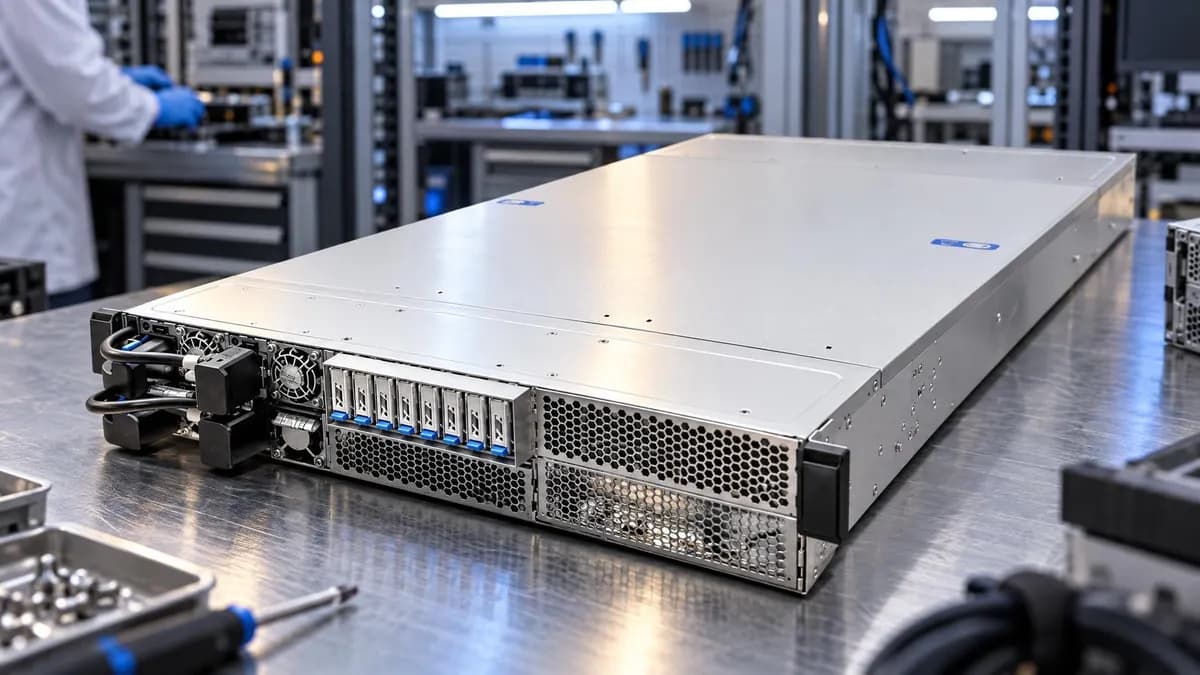
تصور کنید یک برنامهنویس ارشد در تیمی کوچک است که میخواهد عاملهای هوش مصنوعیاش را از مرحلهی «پیشنهاد کد» به مرحلهی «اجرای خودکار در محیط عملیاتی» برساند، اما با کرش کردنهای مداوم سیستم میزبان مواجه میشود. این دقیقاً همان نقطهای است که ایسوس (ASUS) با معرفی سرور XA P2N-E2 در ۱۲ اکتبر ۲۰۲۶ در اجلاس OCP Global Summit در سن خوزه، قصد دارد آن را به یک مزیت رقابتی تبدیل کند.
این سرور ۲ یو (2U) بهجای تمرکز بر استنتاج ساده، برای مدیریت لایهی اجرا طراحی شده است؛ یعنی همان جایی که عاملها واقعاً کد میزنند و از ابزارها استفاده میکنند. طبق اعلام ایسوس، اکثر سختافزارهای فعلی بر روی محاسبات عظیم برای آموزش یا تولید توکن متمرکز هستند، اما وقتی یک عامل تصمیم میگیرد یک اسکریپت پایتون را اجرا کند یا از یک پایگاهداده پرسوجو کند، با گلوگاههای متفاوتی روبرو میشود.
این وضعیت شبیه به داشتن یک موتور فوقسریع (GPU) است که مجبور است منتظر یک گیربکس کند (CPU) بماند تا ماشین را در دنده قرار دهد؛ ایسوس در اینجا دقیقاً روی بهینهسازی این «گیربکس» متمرکز شده است تا شکاف موجود در زیرساختهای اجرای کد توسط عاملهای هوشمند را پر کند.
زمینه: لایهی اجرا
به گفتهی ایسوس در یک بیانیهی مطبوعاتی، XA P2N-E2 بهطور خاص برای بارهای کاری هوش مصنوعی عاملمحور (Agentic AI) و یادگیری تقویتی (Reinforcement Learning) طراحی شده است. این سیستم لایهی اجرای برنامههای هوش مصنوعی را هدف قرار میدهد؛ لایهای که مسئولیت استفاده از ابزارها، پردازش دادهها، ارکستراسیون و اجرای کد را بر عهده دارد. این رویکرد در راستای چشمانداز گستردهتری است که در آن عاملهای همیشهفعال به هدف جدید سختافزارهای انویدیا تبدیل شدهاند تا بتوانند بهصورت محلی و مستقل عمل کنند.
این تلاشها فراتر از خودِ مدل هوش مصنوعی است. ایسوس با ترکیب محاسبات CPU و شتابدهی GPU در یک پلتفرم 2U، قصد دارد پاسخدهی عاملهای هوش مصنوعی را در حین وظایف دشوار ارزیابی و اجرا، از طریق حافظههای با پهنای باند بالا و کممصرف و همچنین عملکرد قدرتمند تکرشتهای CPU، تضمین کند.
معماری سختافزاری
این سرور بر پایه معماری NVIDIA MGX ساخته شده و از دو پردازنده NVIDIA Vera بهره میبرد. ایسوس این پردازندهها را نخستین تراشههایی مینامد که بهطور اختصاصی برای عاملهای هوش مصنوعی ساخته شدهاند. در این گردشکار، پردازنده (CPU) مسئول ارکستراسیون و اجرای کد در محیطهای ایزوله (Sandboxed) است، در حالی که پردازندههای گرافیکی (GPU) صرفاً به استنتاج و آموزش اختصاص مییابند.
هر پردازنده Vera دارای ۸۸ هسته سفارشی Olympus با قابلیت چندرشتهای فضایی (Spatial Multithreading) است که در مجموع ۱۷۶ رشته در هر سوکت فراهم میکند و توان طراحی حرارتی (TDP) آن تا ۴۸۰ وات میرسد. طراحی ماژولار MGX نیز تضمین میکند که ماژول پردازنده میزبان و محفظه GPU بهطور مستقل قابل سرویسدهی و تعویض باشند.
مشخصات فنی
جزئیات سختافزاری این سیستم به شرح زیر است:
- پشتیبانی از GPU: تا دو عدد NVIDIA RTX PRO 6000 Blackwell Server Edition با دو اسلات (هر کدام با توان مصرفی تا ۶۰۰ وات).
- حافظه: ۱۶ ماژول SOCAMM2 با استاندارد LPDDR5X و سرعت ۹۶۰۰MT/s که مجموعاً تا ۱.۵ ترابایت ظرفیت ایجاد میکند. این پیکربندی مصرف انرژی حافظه را ۵۰٪ کاهش و بهرهوری انرژی را تا دو برابر نسبت به حافظههای سنتی RDIMM افزایش میدهد.
- اتصالات: نسل دوم NVIDIA NVLink-C2C که پهنای باند ۱.۸ ترابایت بر ثانیه برای ارتباط CPU-to-CPU و ۳.۴ ترابایت بر ثانیه برای ارتباط بین هستهها فراهم میکند.
- ذخیرهسازی و توسعه: هشت محفظه درایو E1.S با قابلیت تعویض گرم (Hot-swap)، دو اسلات PCIe Gen6 x16 و یک اسلات اختصاصی برای DPU/NIC.
- خنککننده: شاسی کاملاً بادی با جریان هوا از جلو به عقب که تمام مناطق پردازنده، حافظه و GPU را پوشش میدهد و توسط دو منبع تغذیه ۲۰۰۰ وات redundant با استاندارد 80 PLUS Titanium تغذیه میشود.
حل گلوگاههای عاملمحور
بر اساس بررسیهای ایسوس در ۱۰ اوت ۲۰۲۶، چهار گلوگاه سختافزاری اصلی مانع رشد هوش مصنوعی عاملمحور هستند: عملکرد ضعیف تکرشتهای در مقیاس بالا، پهنای باند ناکافی حافظه در هر هسته، تأخیر در دسترسی به دادههای بین-تراشهای (Cross-die) و نبود ایزولاسیون سختافزاری برای محیطهای Sandbox. در این راستا، بحث بر سر این است که آیا لایهی سختافزاری میتواند جایگزین مدلهای نرمافزاری در تامین امنیت شود تا از خروج غیرمجاز عاملها از محیطهای ایزوله جلوگیری کند.
سرور XA P2N-E2 این مشکلات را مستقیماً هدف قرار میدهد. ایسوس ادعا میکند پردازنده Vera عملکرد تکرشتهای را ۱.۸ برابر نسبت به CPUهای سنتی x86 بهبود داده و سرعت گردشکارهای کدنویسی را ۱.۵ برابر افزایش میدهد. همچنین اجرای کد در محیطهای ایزوله ۱.۸ برابر سریعتر از زیرساختهای قدیمی انجام میشود. این دستاوردها نتیجهی طراحی ۸۸ هستهای، پهنای باند ۱.۲ ترابایت بر ثانیهی حافظه LPDDR5X و پهنای باند ۳.۴ ترابایت بر ثانیهی اتصالات داخلی است.
فناوریهای مقیاس رک و پلتفرم
ایسوس علاوه بر این سرور، سیستم XA VR721-E3 AI POD را برای مقیاسهای بزرگتر معرفی کرده است. این سیستم رکم-اسکیل، ۳۶ پردازنده Vera و ۷۲ پردازنده گرافیکی NVIDIA Rubin را از طریق پلتفرم NVIDIA Vera Rubin NVL72 یکپارچه میکند. برخلاف مدل P2N-E2 که خنککننده بادی دارد، AI POD برای آموزش، پسآموزش (Post-training) و استنتاج در مقیاس وسیع از معماری کاملاً مایع استفاده میکند.
سایر فناوریهای معرفیشده شامل موارد زیر است:
- XR R1I12B-M1BHFS: ترکیبی از NVIDIA HGX Rubin NVL8 با خنککننده مایع مستقیم برای GPUها و خنککننده بادی برای پردازندههای Intel Xeon 6.
- Groq 3 LPX: یک شتابدهنده استنتاج برای Vera Rubin NVL72 که تولید توکنها را با سرعت فوقالعادهای ممکن میسازد.
- شبکه و ذخیرهسازی: سوئیچینگ اترنت Spectrum-X (بر پایه Spectrum-6) و پلتفرم ذخیرهسازی حافظه متنی CMX (CMX Context Memory Storage Platform).
جایگزینهای اینتل و ایامدی
برای کسانی که ترجیح میدهند از تراشههای سنتی استفاده کنند، ایسوس سرورهایی بر پایه AMD EPYC 9006 (با نام کد Venice) و Intel Xeon 6 را نیز به نمایش گذاشت. مدل RS700A-E14B-R16U (AMD) از PCIe 6.0 پشتیبانی میکند و ظرفیت پذیرش ۱۶ درایو E3.S را دارد، در حالی که مدل RS700-E12-RS4U (Intel) از طراحیهای DC-MHS برای مجازیسازی و بارهای کاری متمرکز بر داده استفاده میکند.
برای هوش مصنوعی شتابیافته، مدل ESC8000A-E13P از شتابدهندههای AMD Instinct MI350P PCIe پشتیبانی میکند. علاوه بر این، مدل XA AM3A-E13 هشت شتابدهنده AMD Instinct MI355X را در یک طراحی 10U خنکشونده با هوا جای داده است که استقرار با تراکم بالا را بدون نیاز به زیرساختهای آب خنکشده ممکن میسازد.
این چرخش به سمت سختافزارهای «بهینهشده برای اجرا» نشان میدهد که صنعت از «عصر چتباتها» به «عصر عاملها» نقل مکان کرده است. در این دوران، CPU دیگر صرفاً یک مدیر برای GPU نیست، بلکه ابزاری تخصصی برای اجرای امن و ایزوله کدهای تولید شده توسط هوش مصنوعی است. برای کسبوکارها، این یعنی عاملهای AI میتوانند بدون ریسکِ کرش کردن سیستم میزبان، کدها را مستقیماً در محیطهای عملیاتی اجرا کنند.
در نهایت، باید منتظر عرضه NVIDIA Omniverse DSX Blueprint بود؛ ابزاری که ایسوس در کنار طراحی مرجع NVIDIA DSX از آن استفاده میکند تا دوقلوهای دیجیتال دقیق از کارخانههای هوش مصنوعی بسازد و استقرار این سختافزارها را پیش از ورود به مرکز داده بهینهسازی کند. این پلتفرم در نمونههای مشابه توان عملیاتی توکنها را تا ۲۴٪ افزایش داده است و اکنون در ابعاد صنعتیتر به کار گرفته میشود.
گام بعدی شما
- اگر در حال توسعه عاملهای خودکار هستید، روی معیارهای «عملکرد تکرشتهای» (Single-thread) بهجای تعداد هستهها تمرکز کنید.
- بررسی کنید که آیا محیطهای Sandbox فعلی شما گلوگاه تأخیر (Latency) ایجاد میکنند یا خیر.
- برای بهینهسازی استقرار سختافزاری، مستندات NVIDIA Omniverse DSX Blueprint را دنبال کنید تا پیش از خرید سختافزار، دوقلوی دیجیتال مرکز داده خود را شبیهسازی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو